familiarのタスク分割とoutput_file
Claude、Qwen3-Coder-Next 80B、GLM-5.1で6ページ生成のタイムアウトを調べました。LLM導入で使うタスク分割、動的プロンプト、output_fileと実行ログを紹介します。
familiar で歯科クリニックの6ページサイトを生成し、失敗の原因を調べました。Claude を orchestrator、Qwen3-Coder-Next 80B IQ4_KSS を naughty、GLM-5.1 smol-IQ4_K を grandpa に使いました。orchestrator は claude | codex | gemini | ローカル LLM に切り替えられます。
worker backend unavailable の原因は、6ページ分の仕様を1つの worker call に渡し、GPUTimeout=300s に達したことでした。workspace、chat_history、Grafana の session flow、DCGM GPU monitoring を照合して確認しました。
検証構成
検証した項目は次の3点です。
- 大きい仕様を、共有する contract を先に決めて分割できるか
naughtyとgrandpaの担当と出力を追えるか- 失敗の原因がモデルの回答か、実行計画かを記録で区別できるか
実運用には translator も含まれますが、今回は orchestrator / grandpa / naughty の3ロールを検証しました。以前の kindergarten 構成は廃止しています。
使用したロール構成です。
| Role | 主な役割 | モデル |
|---|---|---|
| orchestrator | ターン制御、worker call 計画、依存関係整理 | Claude orchestrator |
| naughty | HTML 生成、単一ファイルの直接生成 | Qwen3-Coder-Next 80B IQ4_KSS x 2 instance |
| grandpa | 部分レビュー、検証、ファイル読解ベースの確認 | GLM-5.1 smol-IQ4_K |
| translator | 翻訳 | Plamo-2-translate bf16 |
Plamo-2-translate はライセンスの都合で、長期運用では置き換える予定です。記事時点では llm-jp/llm-jp-4-32b-a3b-base に翻訳用 LoRA を適用し、nvfp4 化する作業を進めていました。
生成対象は index.html、services.html、doctors.html、info.html、visit.html、access.html です。共通ヘッダとフッタ、料金表、モーダル、README も要求しました。
最初のエラー
最初に次のメッセージが返りました。
  Status: worker execution failed after one recovery attempt.
Initial error: worker call w1 failed: worker backend unavailable
  (alias=naughty backend=vllm model=naughty): knowledge gate: llm backend unavailable:
  request vllm: Post "http://compute.home.arpa:8001/v1/chat/completions":
  context deadline exceeded (Client.Timeout exceeded while awaiting headers)
最初は naughty の容量不足や疎通を疑いました。ただし、メッセージだけでは backend の停止は確認できません。
workspace では、orchestrator が6ページを1つの worker call で生成する計画を立てていました。naughty の並列度情報は届いていましたが、system prompt に具体的な分割方法が足りませんでした。
生成されたページと履歴
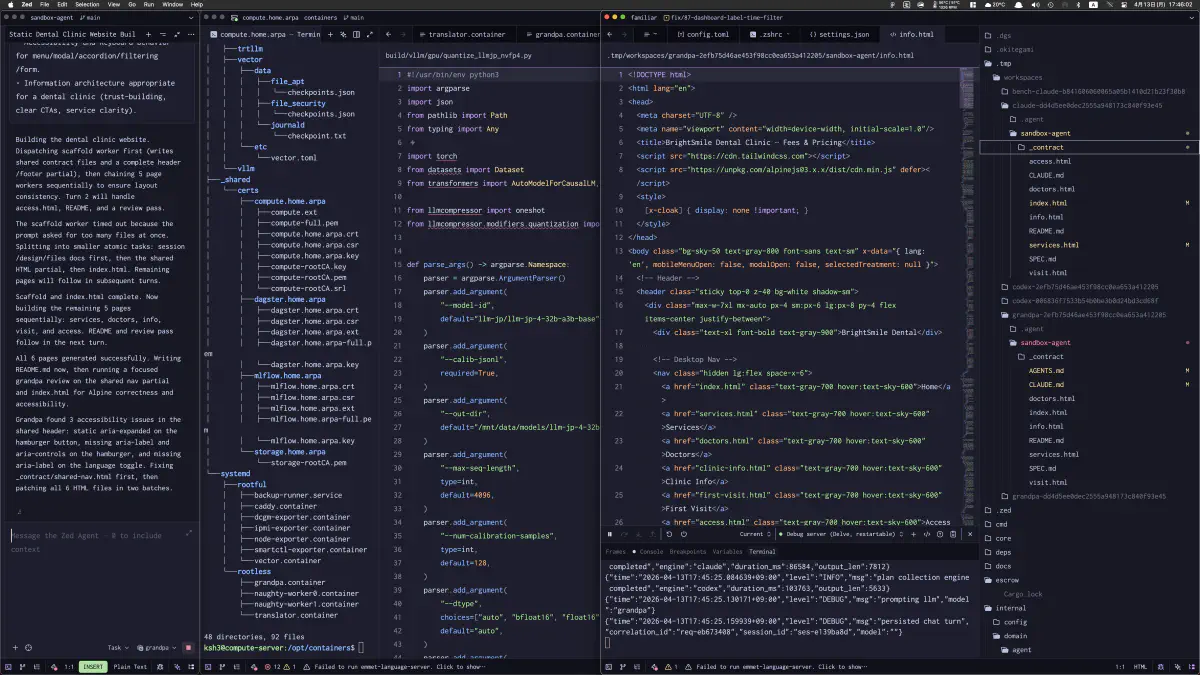
料金表モーダル付きのページは描画され、info.html に対応する HTML がありました。画面とファイルから、生成は途中まで進み、完了前に止まったと確認できました。
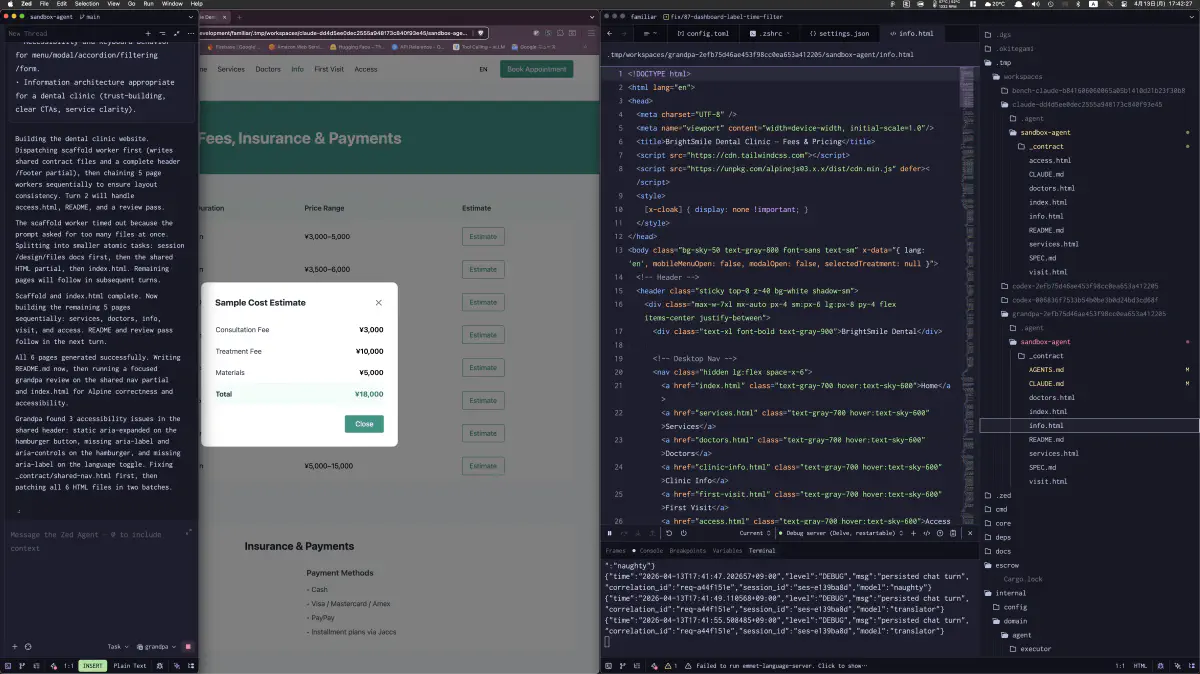
chat_history には orchestrator、grandpa、他の worker の発話と usage がターンごとに残っていました。レビューを2つに分けた記録と、worker ごとの usage JSON も確認しました。
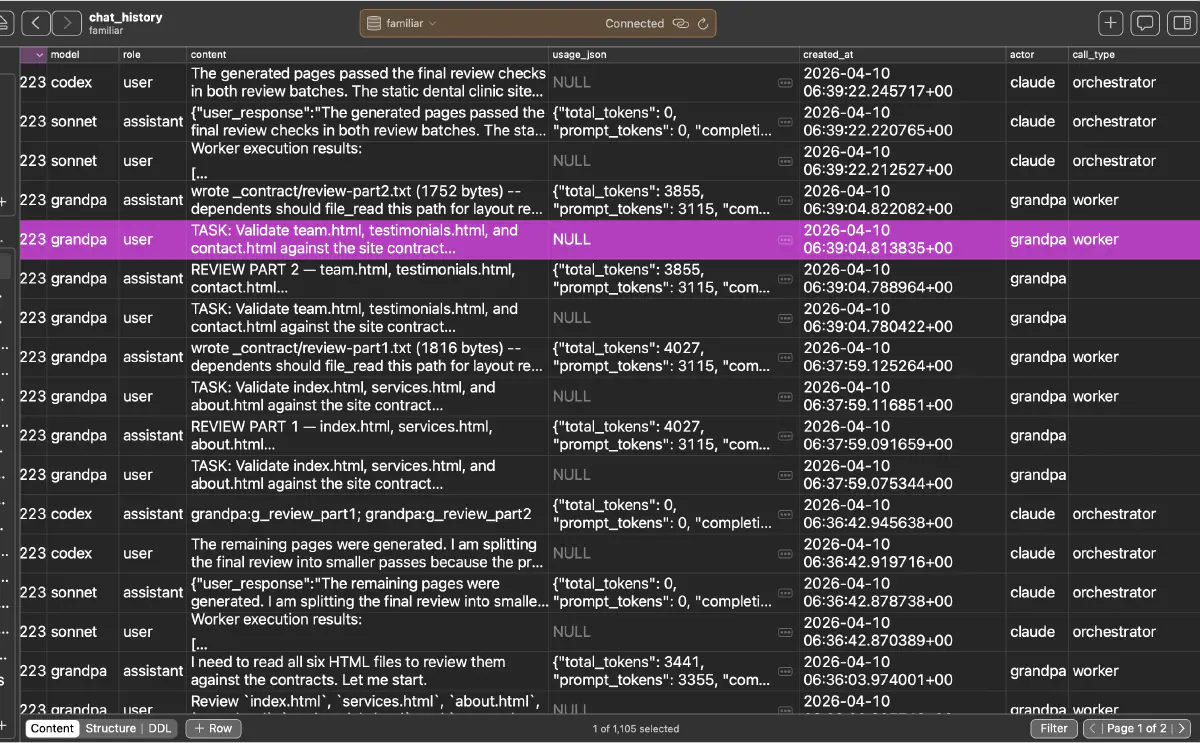
原因を調べた記録
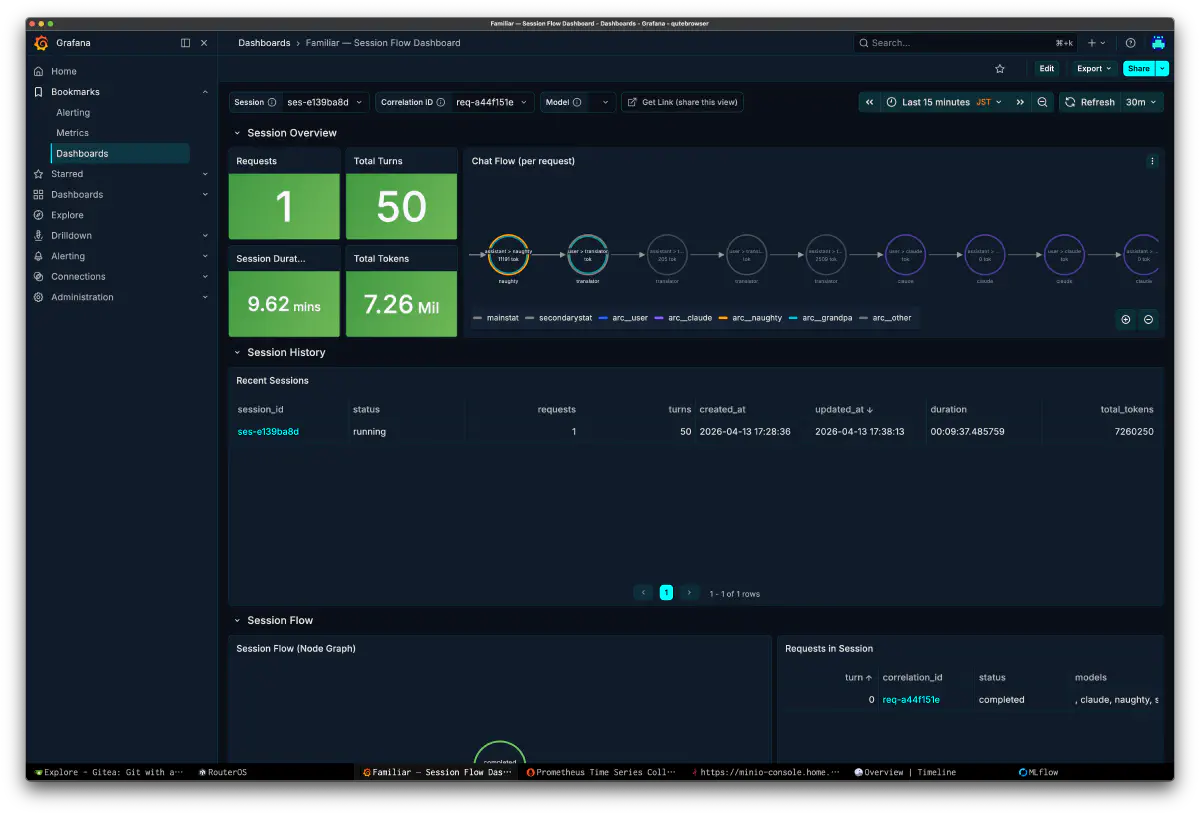
原因を調べるため、workspace、DB、session flow、GPU の4つの記録を照合しました。
Grafana では、1リクエスト約50ターンの実行が数分続いていました。誤ったクエリ条件で 7.26M tokens と表示されましたが、修正後は約 442k でした。chat flow では naughty、grandpa、claude を色分けし、各ロールの実行時間を追えます。
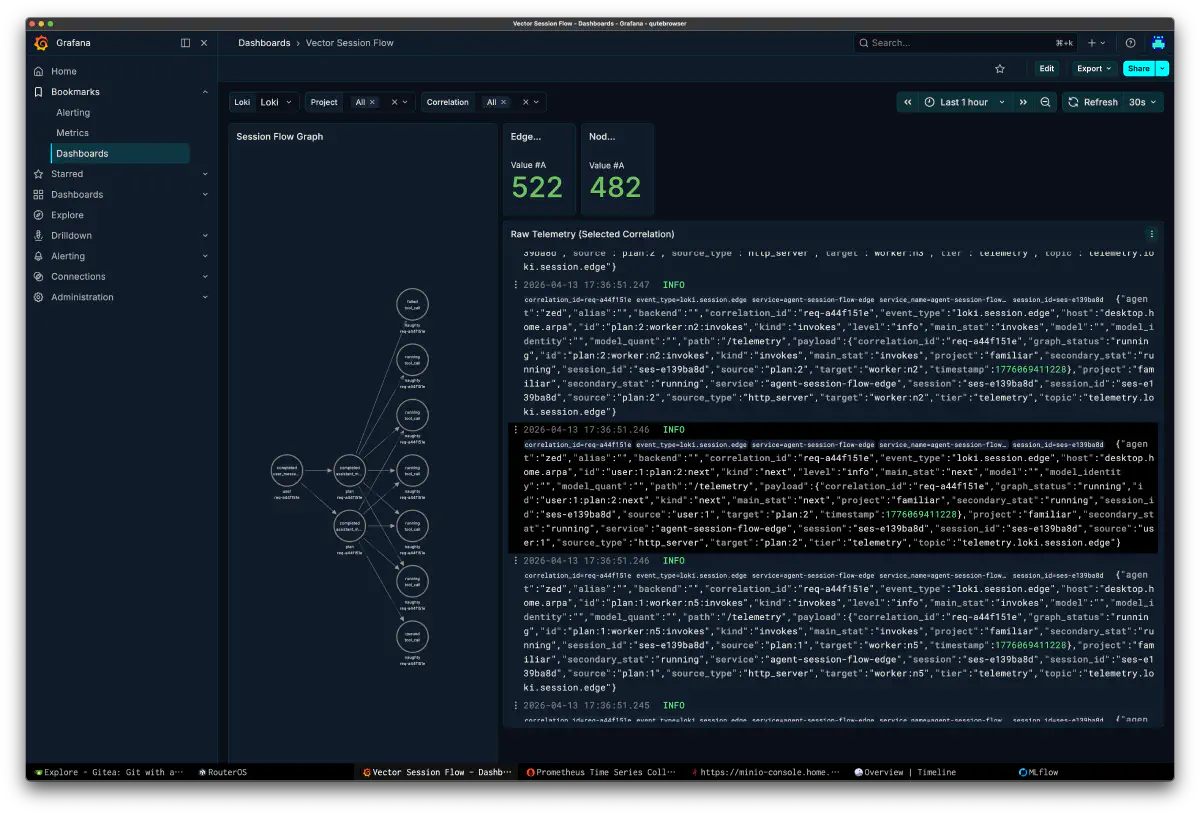
Vector の session flow graph では、plan から worker への分岐と、running / queued の遷移を raw telemetry で確認しました。orchestrator の DAG を調べるための記録です。
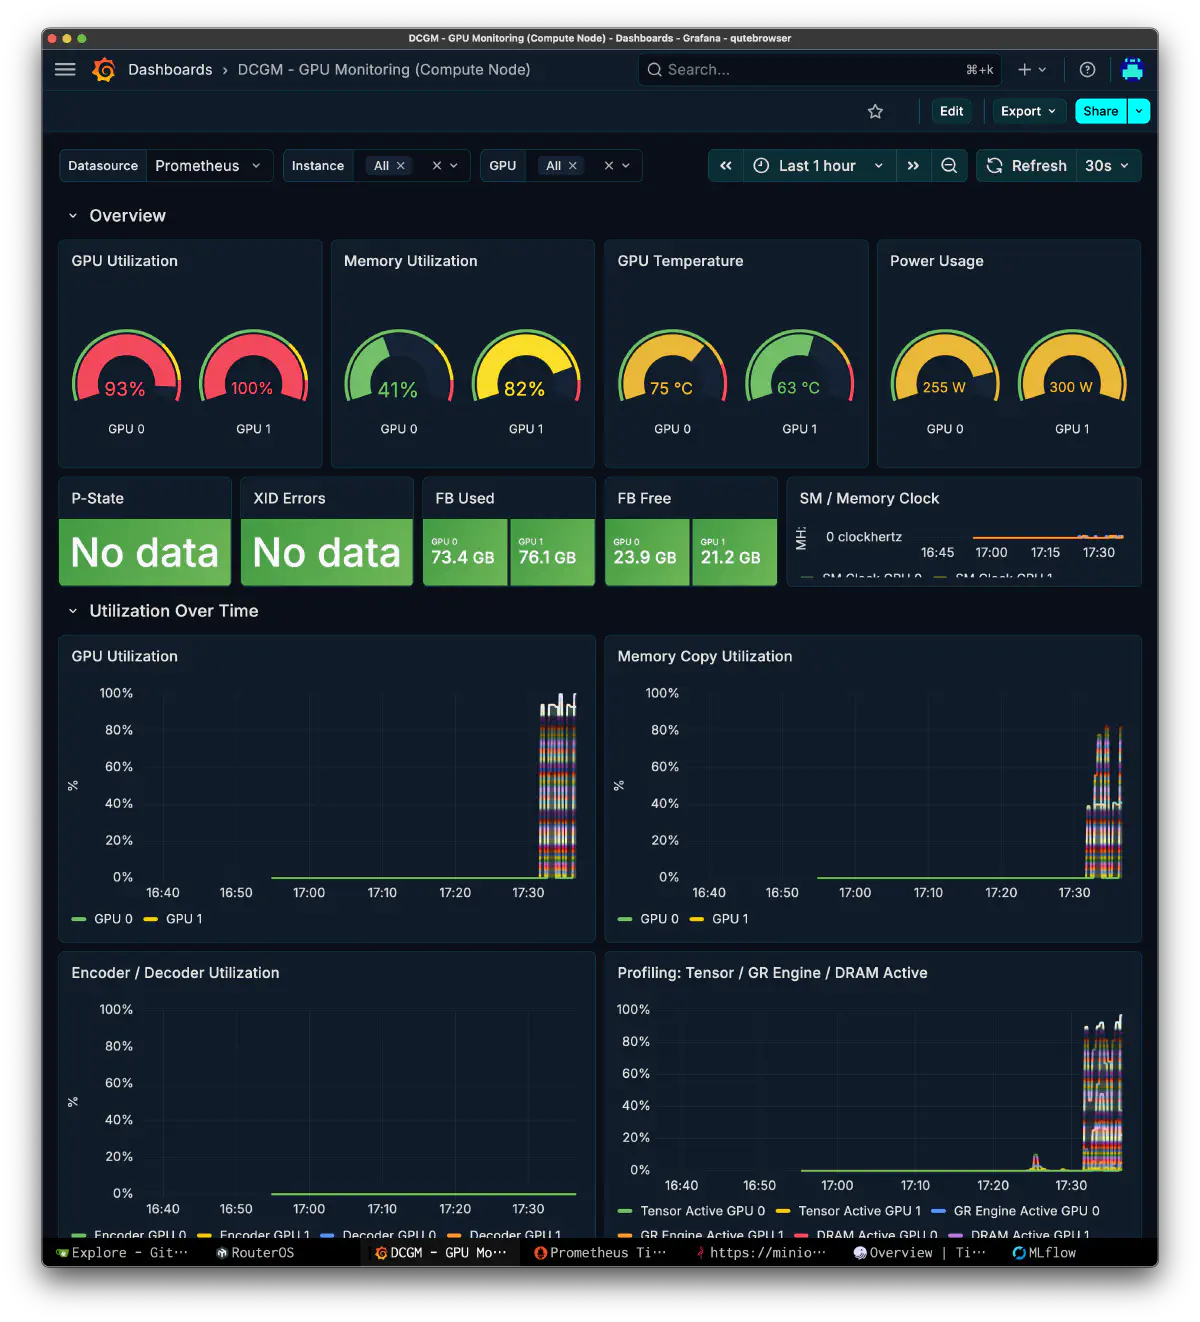
DCGM では両 GPU の utilization と FB usage が上がっていました。backend が完全に停止していたわけではありません。
根本原因
失敗までの流れは次のとおりです。
- orchestrator は V1 相当の system prompt で動いていました
- contract-first parallel design の具体例が不足していました
- 6 ページ要件を 1 回の worker call にまとめていました
naughtyは 300 秒以内に完了できず、GPUTimeoutに達しました- recovery も同じ plan を再試行して失敗しました
想定していた worker_calls は次の形です。
  {
  "continue": true,
  "worker_calls": [
    {
      "id": "n1",
      "alias": "naughty",
      "prompt": "Create the shared structure and landing page first.",
      "depends_on": [],
      "output_file": "index.html"
    },
    {
      "id": "g1",
      "alias": "grandpa",
      "prompt": "Review the shared contract and validate accessibility risks.",
      "depends_on": ["n1"]
    },
    {
      "id": "n2",
      "alias": "naughty",
      "prompt": "Create services.html using the shared header/footer.",
      "depends_on": ["n1"],
      "output_file": "services.html"
    }
  ]
}
共有する骨格を先に作り、その contract に沿ってページを分割する計画です。grandpa はレビューと検証を担当します。
実装した変更
3点を修正しました。
worker poolに応じたsystem prompt
BuildOrchestratorSystemPrompt(pool) を導入し、naughty、grandpa、translator の有効・無効に応じて、ロール説明と分割例を変えるようにしました。最終合成と部分合成の版も保存し、差分、採用結果、使われたターンを追えるようにしました。
output_fileによる単一ファイル生成
output_file モードを追加しました。worker の raw text を指定パスに書き、HTML 1ファイルを1回の LLM 呼び出しで生成します。ReAct で tool 呼び出しを繰り返す時間を減らすためです。
--seq=2、--parallel 2 程度なら、軽い並列処理で足りる可能性があります。今回は Qwen3-Coder-Next 80B IQ4_KSS を2 instance で使うため、共有する contract と、同じファイルへの干渉を避ける仕組みを分ける必要がありました。
共有状態と干渉回避に対応する MCP ツールも追加しました。output_file に加え、複数 instance が触れる範囲を管理しています。
orchestra.logへの記録
orchestra.log に system prompt、worker prompt、worker content、tool_call、tool_result、duration_ms をまとめました。worker call が出た理由を後から調べられます。
検証結果
この実行では、次の使い分けが適していると判断しました。
- orchestrator の分割戦略と message stack の扱いを改善する
naughty=Qwen3-Coder-Next 80B IQ4_KSS x 2 instanceは単一ファイルの生成に使うgrandpa=GLM-5.1 smol-IQ4_Kはレビュー、検証、分割した確認に使う- session flow と DB で計画と実際の出力を確認する
session flow と DB により、実行計画と各ロールの出力を別々に確認できました。backend の遅さ、prompt、ターン構成を調べる材料になります。
今回の結果では、モデル単体の性能だけでなく、指示のつなぎ方、messages[N] の操作、途中成果物の受け渡しが実行に影響しました。
約1か月で、廃止したものも含め約20の Rust 製 MCP ツールを開発しました。ローカル LLM 用と汎用の両方があり、主に不要な ctx を減らすためのものです。minimax-m2.7 の検証時と比べ、one-shot サイト生成のコンテキストは 150k から 55k 付近まで減りました。
記事時点では、SFT / DPO 用データの自動収集より、Grafana と DB で失敗をターンごとに説明できることを優先しています。
次に確認する項目
次に確認するのは、orchestrator の切り替え、worker の担当分離、message stack の圧縮、観測データの保存方法です。
LLM導入やAIシステム開発でも、生成処理を小さく分け、入力、出力、実行時間を残すことが失敗の切り分けに役立ちます。