Gemma 4とBlackwell 2枚の推論基盤
Gemma 4、familiar、Dagster、Grafanaを組み合わせたLLMインフラ構築の記録です。GPU割り当て、並列コーディングでの不整合、GLM-5.1とQwen3-Coder-Nextへの変更をまとめました。
Gemma 4を使う推論基盤
Gemma 4の31B denseと26B-A4B MoEを、homelabの推論基盤に配置しました。familiarのロール、Dagsterの分離、テレメトリも合わせて整えています。LLM導入で複数モデルを並列運用するための構成です。
ハードウェア: EPYC + Blackwell x 2
compute node の仕様:
- CPU: AMD EPYC 9175F
- RAM: 768GB
- GPU: RTX 6000 PRO MAX-Q 96GB Blackwell x 2(NVLink なし)
GPUは独立して使います。NVLinkがないため、ここではTensor Parallelを使わず、別モデルを各GPUに載せてparallel slotを増やしました。初期段階の目的はデータ収集のスループットです。
Gemma 4を選んだ理由
初期段階はモデルの種類を抑え、プロンプトや形式の違いによるデバッグを減らす方針です。スコアとメモリ容量から、Gemma 4の31B denseと26B-A4B MoEを選びました。
異種モデルによるデータの多様化は、familiarとパイプラインが安定してから検討します。まず同じファミリーで処理を確認します。
モデル割り当てと GPU メモリ設計
| slot | model | format | runtime | VRAM | parallel | GPU |
|---|---|---|---|---|---|---|
| naughty | Gemma 4 31B IT | NVFP4 | vLLM | ~17GiB | 3 | GPU0 |
| kindergarten | Gemma 4 26B-A4B IT | IQ4_XS | llama.cpp | ~13GiB | 5 | GPU1 |
GPU メモリ割り当て:
- GPU0 (96GB): Gemma 4 31B NVFP4 ~17GiB + KV cache x 3 parallel slots (~79GB 空き)
- GPU1 (96GB): Gemma 4 26B-A4B IQ4_XS ~13GiB + KV cache x 6 parallel slots (~83GB 空き)
naughty: Gemma 4 31B NVFP4 on vLLM
NVFP4はNVIDIA TensorRT Model Optimizer形式で、BlackwellのFP4カーネルを使います。vLLMのcontinuous batchingでparallel 3を処理します。thinking mode、native function calling、system promptに対応しています。
ベンチマーク:
- AIME 2026: 89.2%
- LiveCodeBench v6: 80.0%
- Codeforces ELO: 2150
- GPQA Diamond: 84.3%
- MMLU Pro: 85.2%
31B denseのAIMEは89.2%です。NVFP4では約17GiBなので、96GB GPUにKV cache用の余裕があります。
kindergarten: Gemma 4 26B-A4B MoE on llama.cpp
26B-A4BはMoE(Mixture of Experts)で、アクティブパラメータは4Bです。bartowskiのIQ4_XSでは約13GiBで、parallel slotを多く取れます。
MoEのGGUF推論には、今回扱いやすかったik_llama.cppを使います。denseのcontinuous batchingにはvLLMを使う分担です。
familiar のモデルロール設計
familiarのロールはgrandpa / naughty / kindergarten / translatorの4つです。CLAUDE.mdで切り替えます。
  grandpa x naughty x kindergarten x translator    # フル構成
naughty x translator                              # 最小構成
naughty x kindergarten x translator               # 標準構成
grandpaは速度より品質を優先し、トークン/秒を調整する役割です。初期段階では収集の並列性能を優先して外し、naughty x kindergarten x translatorを標準にしました。
translatorはplamo-2-translateによる日英翻訳用です。多言語記事パイプラインで使います。
model-foundry: Dagster パイプラインの分離
Dagsterも独立したリポジトリへ移しました。
agent-gatewayのdevstack/dagster/からmodel-foundryへ分離しました。gatewayの付属機能を超えた、独立したデータパイプラインになっていたためです。
DuckDBとDagster UI
DuckDBの導入で、実行状況をまとめて確認できるようになりました。
以前は各アセットを開いていました。導入後はpipeline_event_inbox_recordのSTEP_OUTPUTにevent_id、subject、correlation_idがdictで表示されます。
DuckDB 導入直後に型チェックエラーが出た:
  dagster._core.errors.DagsterTypeCheckDidNotPass: Type check failed for step input
"pipeline_event_inbox_record" - expected type "dict".
Value of type <class 'NoneType'> failed type check
NATSキューが空のときにアセットがNoneを返していました。空イベントの処理を修正しました。
イベント名のリデザイン
knowledge domain のパイプラインイベント名も整理した:
| 旧名 | 新名 |
|---|---|
knowledge.chat.persist | llm.chat.persist |
knowledge.embedding | obsidian.semantic_search |
knowledge.flow.lineage | llm.flow.lineage |
knowledge.tool_call | llm.tool_call |
knowledge.*という内部ドメイン名から、対象システムを表す名前へ変更しました。後のv3 リデザインでは3ドメインに分けています。
Grafana LLM ダッシュボード
推論のテレメトリをGrafanaで表示します。
データフロー
familiar -> Vector (HTTP port 8687 /telemetry) -> Prometheus / Loki -> Grafana
描画方針:
- Grafana は Vector 経由のリアルタイムデータで描画する(PostgreSQL を直接参照しない)
- 永続化は PostgreSQL にフラットに持つ
- 要約が必要なものは Dagster + DuckDB で加工
Vectorのhttp_telemetryがfamiliarのイベントを受け、Prometheusにメトリクス、Lokiにログを送ります。correlation_idでセッションを追跡します。
Vector の設定:
  [sources.http_telemetry]
type = "http_server"
address = "0.0.0.0:8687"
path = "/telemetry"
encoding = "json"
familiarからJSONをPOSTし、Vectorで変換・転送します。GrafanaはPrometheusとLokiを合わせ、推論性能とセッションフローを表示します。
並列コーディングの結果
vLLMのnvidia/gemma-4-31b-it-nvfp4を--max-num-seqs 3、ik_llama.cppのgemma4ブランチのQ4_K_Lを--parallel 5で設定しました。Goのchannelでキューを制御して並列実行します。
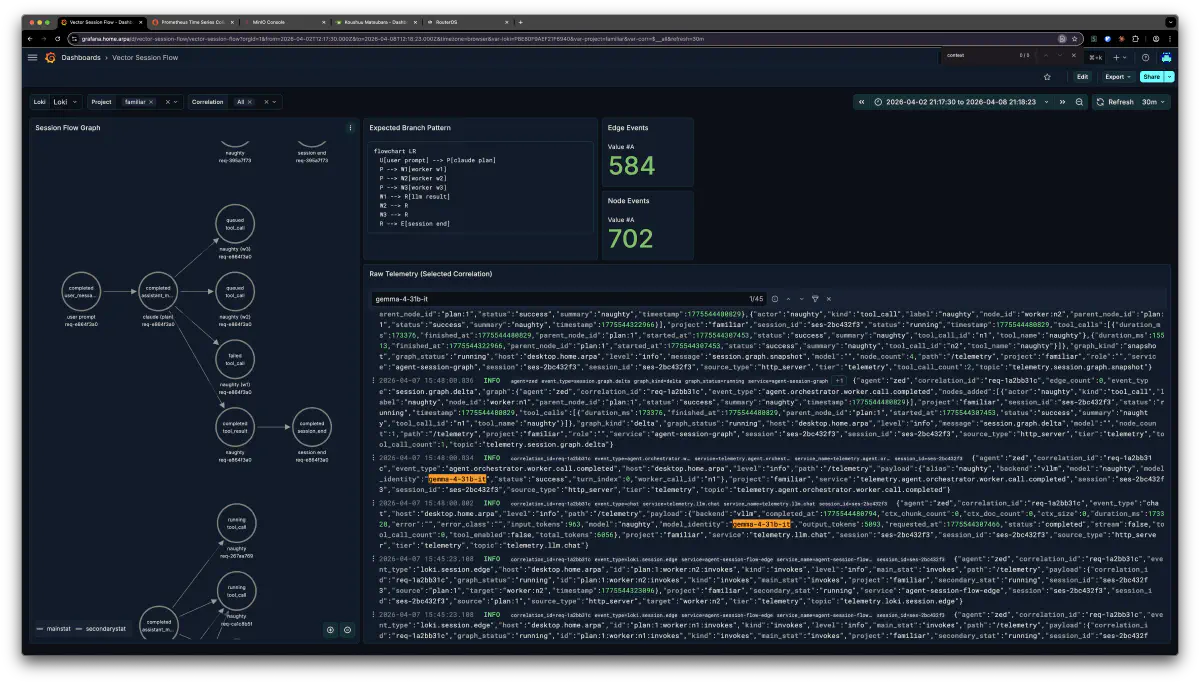
オーケストレータが26B MoE(kindergarten)へ振り分けなかったため、実際に試せたのは31B IT x 3だけです。成果物はできましたが、worker間の方針が揃いませんでした。
KV cacheの同居で似た出力になると期待しましたが、関係は見られませんでした。同じ計画を渡しても、3つのworkerが独立して進め、他のworkerの決定を無視する場面がありました。
この結果から、コーディングでは汎用モデルをオーケストレータに置き、workerのプロンプトとコンテキストを制限する方針にしました。並列化で収集量は増やせても、共同で整合した成果物を作るには制御が必要です。
その後: GLM-5.1 + Qwen3-Coder-Next 構成
その後、grandpaをKimi-K2.5からGLM-5.1へ変更し、Qwen3-Coder-Nextと組み合わせました。
  dev0 / GLM-5.1 (grandpa)
  PP:  340 tok/s
  TG:  12-16 tok/s

dev0 / Qwen3-Coder-Next (worker-0)
  PP:  2500 tok/s
  TG:  114 tok/s

dev1 / Qwen3-Coder-Next (worker-1)
  PP:  5100 tok/s
  TG:  161 tok/s

dev1 / PLaMo2Translate (translator)
  PP:  100-240 tok/s
  TG:  35-140 tok/s
推論力を重視するオーケストレータと、コーディング向けworkerの構成では、Gemma 4だけの構成より協調が取れました。