PostgreSQLを常時稼働のstorageに移す
PostgreSQLをon-demand GPUサーバーから24/7のMac Miniに移しました。インフラ構築の事例として、pgvectorを残した理由、接続設定、macOS対応、バックアップを説明します。
移行した構成
PostgreSQL を compute.home.arpa から、常時稼働する storage.home.arpa に移しました。homelab は storage.home.arpa(Mac Mini 2018、24/7)、desktop.home.arpa(開発機)、compute.home.arpa(on-demand GPU box)の3台構成です。接続設定と devstack も変更しました。
移行前のDB配置
移行前の配置です。
  storage.home.arpa (Mac Mini 2018, Ubuntu, 24/7)
  -- MinIO, Prometheus, Loki, Vector

desktop.home.arpa
  -- familiar (agent-gateway), NATS

compute.home.arpa (GPU box, on-demand)
  -- PostgreSQL, Dagster, MLflow, vLLM, llama.cpp
当初は Dagster と MLflow が同じホストからアクセスしやすいため、PostgreSQL を compute に置きました。Docker Compose 内では postgres をホスト名として使えます。
compute は必要なときだけ起動するため、DB を確認したり desktop から dbt を実行したりするにも、GPU box の起動が必要でした。compute の再構築時に永続データを扱う負担もありました。
storageの負荷を検討
移行先は storage.home.arpa です。Mac Mini 2018(i7-8700B、16GB RAM)で負荷を処理できるかを検討しました。
移行前の PostgreSQL には3つの DB がありました。
agent_gateway: アプリの主 DB(document_chunks, chat_history, session, lineage)dagster: Dagster 実行メタデータmlflow: MLflow 実験トラッキング
主なデータはメタデータ、テキスト、ベクトルです。Parquet や artifacts は MinIO に保存します。pg_dump は数 MB 程度で、この用途の I/O は軽いと判断しました。
データの役割を次のように分けています。
| 保管先 | 役割 | データ例 |
|---|---|---|
| PostgreSQL (storage) | メタデータ + 集計 + pgvector | session, lineage, embeddings, dbt materialized |
| MinIO (storage) | 実体ファイル | Parquet, Iceberg data, MLflow artifacts |
| DuckDB (compute) | 変換・集約ワークベンチ | Dagster パイプライン中間データ |
DuckDB は Dagster job で再生成できる作業用キャッシュです。正本は PostgreSQL と MinIO に置きます。
PostgreSQL を常時稼働させると、desktop からいつでも dbt を使えます。インフラ構築では、永続データと必要時だけ起動する計算資源を分けるための配置です。
pgvectorを残した理由
pgvector を分離し、Qdrant を compute に置く案も検討しました。
Qdrant なら compute の CPU とメモリを HNSW 検索に使えます。高 RPS への対応を期待しましたが、次の問題がありました。
document_chunksのテキストとメタデータを PG、ベクトルを Qdrant で二重管理する- Go のリポジトリ実装を Qdrant client 用に変更する
- compute が停止中は embedding 検索ができない
Gemini などの外部 API を使う際も、compute を起動せずに embedding 検索を使いたいことが、判断の理由になりました。
pgvector を残すと、次の構成を維持できます。
- embedding + メタデータ + chat_history が同一 DB で JOIN できる
correlation_idで横断クエリが1発- 二重管理なし
- バックアップ1箇所
embedding 検索はユーザークエリにつき HNSW 検索1回です。aichat と Zed を同時に使っても、想定 RPS は2–5でした。18 RPS は NATS 経由の Dagster イベントで、軽量な metadata INSERT の値です。
pgvector を PostgreSQL に残して storage に移しました。問題が出た場合は ef_search、shared_buffers の順に調整し、最後に Qdrant@compute を検討する方針です。
実装: Go config と compose の書き換え
config.go は COMPUTE_HOST から DSN を作っていたため、POSTGRES_HOST を追加して分離しました。
  // internal/config/defaults.go
const DefaultPostgresHost = DefaultStorageHost // storage.home.arpa

// internal/config/config.go
postgresHost := envOr("POSTGRES_HOST", DefaultPostgresHost)
ユーザの対応も変更しました。
| 用途 | ユーザ | DB |
|---|---|---|
| アプリケーション | agent | agent_gateway |
| インフラメタデータ | system | dagster, mlflow |
| 管理 | ksh3 | 全 DB |
compute-compose.yaml を変更しました。
  # 削除: postgres サービスブロックと postgres-data volume

# MLflow: backend-store-uri を storage に向ける
mlflow:
  environment:
    BACKEND_STORE_URI: postgresql://system@storage.home.arpa:5432/mlflow

# Dagster: 環境変数で PG ホストを注入
dagster-webserver:
  environment:
    DAGSTER_PG_HOST: storage.home.arpa
    DAGSTER_PG_USER: system
    POSTGRES_DSN: postgresql://agent@storage.home.arpa:5432/agent_gateway

# 全サービスに restart: on-failure を追加(PG 接続リトライ用)
depends_on: postgres を削除し、restart: on-failure と Dagster / MLflow の接続リトライを使います。storage の PostgreSQL が起動すると接続します。
storage の PostgreSQL は systemd quadlet で管理します。postgres:18-trixie に JIT と pgvector を追加し、Mac Mini 向けに設定しました。
  shared_buffers = 2GB      # 16GB RAM を他サービスと共有
effective_cache_size = 6GB
work_mem = 64MB
shm_size = 2GB            # compute の 4GB から削減
初期化を .sql から .sh に変え、ユーザ、DB、pgvector 拡張、権限をまとめて設定します。
go build ./... # 問題なし
devstack の macOS 対応
並行して、homelab/desktop-containers/compose.yaml を macOS 用に修正しました。
修正対象だった Linux 専用の設定です。
| 問題 | 修正 |
|---|---|
node-exporter の privileged: true + pid: host | 削除(macOS VM では意味がない) |
/:/host:ro,rslave マウント | rslave 除去(macOS Docker Desktop 非対応) |
version: "3.9" | 削除(deprecated) |
/private/var/log パス | macOS では /var/log が symlink |
Grafana と Prometheus は変更していません。node-exporter の macOS 機能には制限がありますが、compute と storage のメトリクスは取得できました。
バックアップと symlink の設計
compute-containers/runtime/backup/backup-runner.sh の symlink による重複を確認しました。
  BACKUP_ROOT=/srv/persistent/backup
WORKSPACE_ROOT="${WORKSPACE_ROOT:-/mnt/data/workspace}"
/opt → /mnt/data/workspace の symlink では二重バックアップになりません。backup-runner.sh は WORKSPACE_ROOT を直接指定し、/opt を通りません。tar は通常 symlink 自体を保存します。--follow-symlinks を使う場合や、別の処理が /opt を対象にする場合は別途確認が必要です。
ctree チェックポイントと argus
argus では ctree の create_checkpoint を追加しました。get_revs の差分表示とは別に、作業の節目でチェックポイントファイルを作るためのツールです。
ctree の get_affected と get_depends が、次のシンボル参照を検出できないことも分かりました。
  ctree.get_affected(name="reject_removed_paging_args")  -> 参照なし(実際は dispatch から呼ばれている)
ctree.get_depends(dep="reject_removed_paging_args")     -> "no dependencies found"
この不具合は別セッションで修正しました。
記事時点の familiar には、ツール実行、ワークスペース管理、MCP サーバー管理を担う Application Layer が加わっています。
  Transport Layer (Gin)
    |
    +--- (agent mode) ---> Application Layer [internal/agent/]
    |                         +- loop.go          orchestration loop
    |                         +- orchestrator_runtime.go
    |                         +- intent_packet.go
    |                         +- tools.go         MCP tool definitions
    |                         +- executor/        file, git, shell
    |                         +- mcp/             MCP server management
    |                         +- workspace/       session management
    v                                |
Domain Layer <-----------------------+
通常の API は Transport → Domain → Infra を通ります。エージェントモードでは Transport が Application Layer を通じてオーケストレーションを実行します。
移行後の配置
移行後の3台の構成です。
  storage.home.arpa (Mac Mini 2018, Ubuntu, 24/7)
  -- PostgreSQL :5432 (pgvector, 3 DBs)
  -- MinIO :9000
  -- Prometheus :9090
  -- Loki :3100
  -- Vector

desktop.home.arpa
  -- familiar :8080
  -- NATS :4222
  -- multi-bert-inference :50051
  -- Grafana :3000

compute.home.arpa (GPU box, on-demand)
  -- Dagster :3300
  -- MLflow :5050
  -- vLLM :8000
  -- llama.cpp :8081
  -- DuckDB (パイプライン内ワークベンチ)
永続データの正本を storage に集約しました。compute を停止・再構築しても、正本は storage に残ります。
移行後は familiar、dagster、mlflow、postgres の4 DB が storage で動いています。
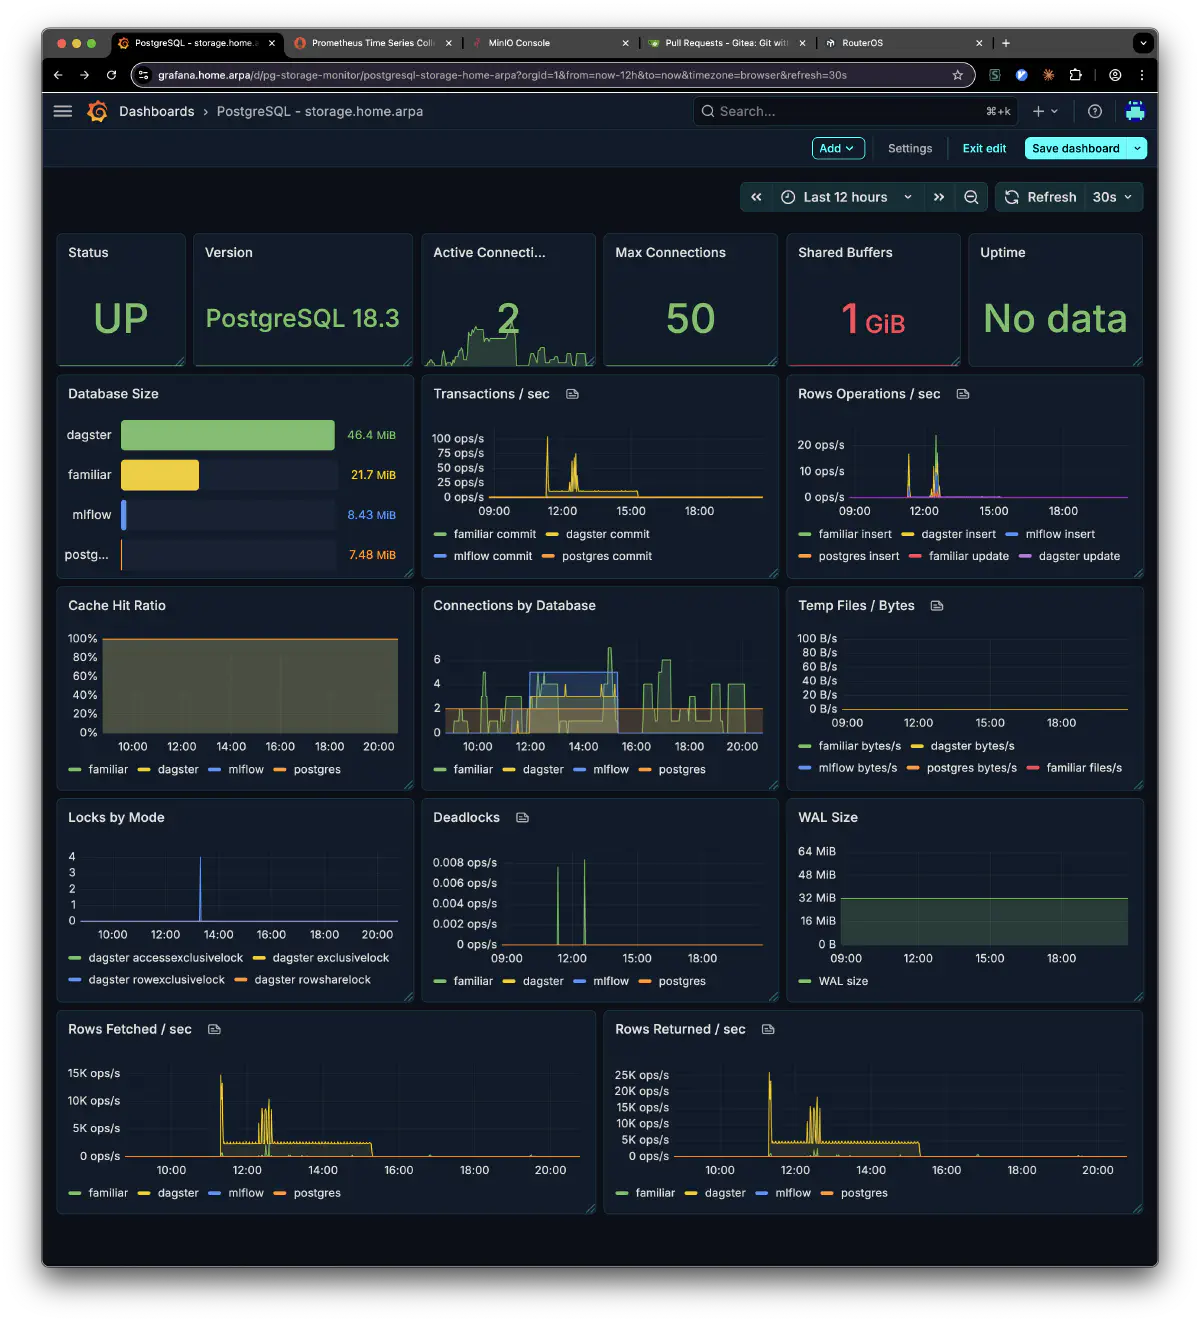
familiar の session flow を telemetry として表示し、correlation_id で一連のリクエストを追えます。
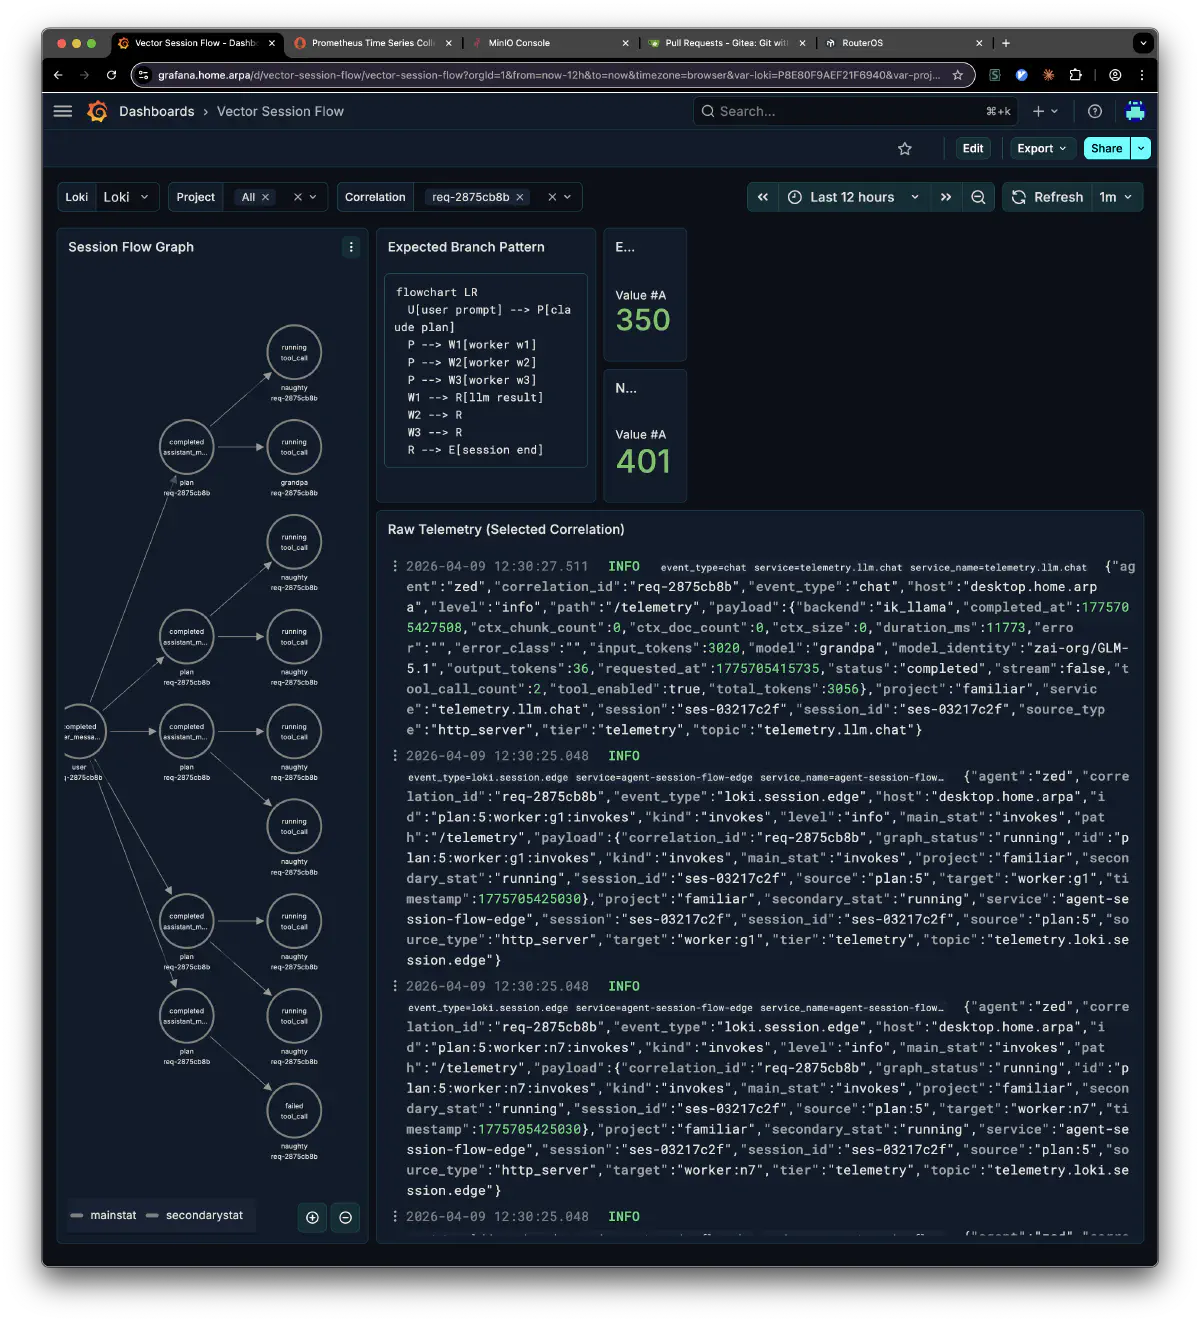
storage は各ノードの restic バックアップの集積先でもあります。ツールの多くは Rust と Go で実装し、観測した範囲では CPU とメモリの負荷に問題はありませんでした。
storage は、じゃんぱらで約4万円で購入した Mac Mini Late 2018 の2TBモデルです。購入時の SMART では Power-On Hours がほぼゼロでした。OS を ubuntu-minimal に替え、24/7 で使っています。