
DeepSeek V4 Flash 0731のvLLM実測とCPU KV offload
RTX PRO 6000 96GB 2枚でDeepSeek V4 Flash 0731を実測。DSpark K5の速度、CPU KV offload、業務システム開発の生成例を記録します。
DeepSeek V4 Flash 0731を RTX PRO 6000 Blackwell Max-Q 96GB 2枚で動かしました。custom vLLM の Gilded Gnosis r24、Tensor Parallel 2、DSpark K5、FP8 compressed MLA KV、native CPU KV offload を使っています。
Coding-agent workload の実行と生成物の確認を動画にしました。
動画リンク: https://www.youtube.com/watch?v=E7JroDgE9no
MAX_MODEL_LEN=262144 で起動し、GPU KV cache は285,336 tokens確保できました。262,144 tokensのリクエスト1本に対する理論concurrencyは1.09xです。生成速度は最大359.0 tok/s、single active request の中央値は230.9 tok/sでした。
結果
| 項目 | 実測値 |
|---|---|
| Model | deepseek-ai/DeepSeek-V4-Flash-0731 |
| Runtime | vLLM Gilded Gnosis r24 |
| GPU | RTX PRO 6000 Blackwell Max-Q 96GB x2 |
| Tensor Parallel / DCP | 2 / 1 |
| Expert path | model-native FP4 / B12X W4A8 |
| KV cache | FP8 DeepSeek compressed MLA |
| Configured context | 262,144 |
| Maximum sequences | 2 |
| GPU KV capacity | 285,336 tokens |
| 262K request concurrency | 1.09x |
| Peak GPU KV usage | 79.4% |
| Peak generation throughput | 359.0 tok/s |
| Single-active-request median | 230.9 tok/s |
| Single-active-request IQR | 167.9-279.3 tok/s |
| Nonzero-window mean | 205.6 tok/s |
| Peak prompt throughput | 5,790.1 tok/s |
| DSpark acceptance length | median 5.12 / best 5.90 |
| DSpark draft acceptance | median 82.4% / best 98.1% |
| CPU KV offload | 8 GiB total across TP ranks |
| Observed KV copy rate | approximately 50-55 GB/s |
| Captured access-log results | 101 / 101 HTTP 200 |
Throughput と DSpark の統計は、Codex で vLLM server log を集計した値です。
既存のDeepSeek V4 Flash記事との違い
以前は DwarfStar 4 で Q2 GGUF を単一GPUに載せ、2台の compute node に分散した orchestrator も試しました。
今回は DeepSeek-V4-Flash-0731 を使い、次の点を変えました。
- RuntimeはDwarfStar 4ではなくcustom vLLM
- Checkpointは
DeepSeek-V4-Flash-0731 - Expert weightsはmodel-native FP4
- GPUは1台ではなく、1ホスト内のRTX PRO 6000 x2
- DSpark K5 speculative decodingを使用
- GPU KVにFP8 compressed MLAを使用
/dev/shm上のnative CPU KV offloadを使用
検証環境
| 項目 | 内容 |
|---|---|
| Host CPU | AMD EPYC 9175F |
| Host RAM | 768GB DDR5 ECC |
| GPU | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition x2 |
| VRAM | 96GB x2 |
| GPU link | PCIe 5.0 x16 |
| OS | Ubuntu 24.04 |
| Container | Podman / Quadlet |
| Model | deepseek-ai/DeepSeek-V4-Flash-0731 |
| Model snapshot | 7872f01b1d1fe23eabc4c98b48bffcef5a386062 |
| Image used | registry.home.arpa/vllm:deepseek-v4 |
| Base release | Gilded Gnosis v20 r24 |
| Runtime version | v0.11.2.dev280 custom build |
起動した vLLM version です。
  Aug 04 01:45:09 compute-server grandpa[415455]: (APIServer pid=52) INFO 08-04 01:45:09 [api_utils.py:345]  ▄▄ ▄█ █     █     █ ▀▄▀ █  version 0.11.2.dev280+gilded.gnosis.v20.vllmf5981f1.si2b9bf2a.fi801d57a.cu132.20260803.r24
Aug 04 01:45:09 compute-server grandpa[415455]: (APIServer pid=52) INFO 08-04 01:45:09 [api_utils.py:345]   █▄█▀ █     █     █     █  model   /models/snapshots/7872f01b1d1fe23eabc4c98b48bffcef5a386062
Private mirror の元の release image です。
  voipmonitor/vllm:gilded-gnosis-v20-vllmf5981f1-si2b9bf2a-fi801d57a-cu132-20260803-r24
Docker manifest: sha256:64b94299abdd3bcf5bb5050ca91b378f9ee4e0b0eff4748375b95352371d7cb2
Local image ID: sha256:dc0bc459b8c1d59f84e945a4b77f65ea474778b58f4a95d3e3d1c97632daeb1d
Model-native FP4 expertとB12X W4A8
Expert weights は model-native FP4 です。一般的な post-training Q4 conversion ではありません。起動ログでも FP4 expert、W4A8、compressed MLA KV、FP8 Lightning Indexer を確認しました。
  (Worker_TP0 pid=496) INFO [quant_config.py:75] DeepSeek V4 expert_dtype resolved to 'fp4'
(Worker_TP0 pid=496) INFO [attention.py:98] Using DeepSeek's fp8_ds_mla KV cache format.
(Worker_TP0 pid=496) INFO [mxfp4.py:426] Using 'B12X' Mxfp4 MoE backend.
(Worker_TP0 pid=496) INFO [attention.py:1023] Using FP8 indexer cache for Lightning Indexer.
(Worker_TP0 pid=496) WARNING [b12x_moe.py:810] B12X MoE force-A8 enabled: using quant_mode=w4a8_mx for E8M0 FP4 weights.
Model loading は InstantTensor の BUFFERED backend を使い、weights は各GPUで81.01 GiBを占めました。
DSpark K5
K5 は、1回の verification で5個の draft token を提案する fixed-depth profile です。
  Environment=MODE=dspark
Environment=DSPARK_DEPTH_MODE=fixed
Environment=DSPARK_TOKENS=5
MAX_NUM_BATCHED_TOKENS=8192 から speculative decoding の slot を差し引き、実効scheduled tokensは8,184になりました。
Aug 04 02:44:37 compute-server grandpa[572062]: (EngineCore pid=179) WARNING 08-04 02:44:37 [vllm.py:1758] max_num_scheduled_tokens is set to 8184 based on the speculative decoding settings. This may lead to suboptimal performance. Consider increasing max_num_batched_tokens to accommodate the additional draft token slots, or decrease num_speculative_tokens or max_num_seqs.
Current speculative depth: 5 に対して acceptance length は最大5.90でした。5個の draft token に通常の target token も含める指標です。acceptance は prompt によって変わりました。
Quadlet
この image は標準の vllm-openai に引数を直接渡す形式ではありません。serve-ds4-flash.sh が環境変数から vLLM 引数、SparkInfer backend、DSpark 設定を組み立てます。
Quadlet の Exec は次の1行です。
Exec=/usr/local/bin/serve-ds4-flash.sh
使用した Quadlet です。
  [Unit]
Description=DeepSeek V4 Flash 0731 / DSpark r24
After=network-online.target
Wants=network-online.target

[Container]
ContainerName=grandpa
Image=registry.home.arpa/vllm:deepseek-v4
Pull=always

Network=host
AddDevice=nvidia.com/gpu=0
AddDevice=nvidia.com/gpu=1
PodmanArgs=--ipc=host --privileged
RunInit=true

Volume=/mnt/data/hf/hub/models--deepseek-ai--DeepSeek-V4-Flash-0731:/models:ro
Volume=/mnt/data/hf/jit/ds4-v20-r24:/cache
Volume=/mnt/data/hf/tmp/ds4-v20-r24:/container-tmp

Environment=BACKEND=b12x-a8
Environment=CUDA_VISIBLE_DEVICES=0,1
Environment=DCP_SIZE=1
Environment=DSPARK_DEPTH_MODE=fixed
Environment=DSPARK_TOKENS=5
Environment=GPU_MEMORY_UTILIZATION=0.975
Environment=INSTANTTENSOR_BACKEND=BUFFERED
Environment=KV_OFFLOADING_SIZE=8
Environment=LOAD_FORMAT=instanttensor
Environment=MAX_MODEL_LEN=262144
Environment=MAX_NUM_BATCHED_TOKENS=8192
Environment=MAX_NUM_SEQS=2
Environment=MODE=dspark
Environment=MODEL_PATH=/models/snapshots/7872f01b1d1fe23eabc4c98b48bffcef5a386062
Environment=PORT=8000
Environment=SERVED_MODEL_NAME=grandpa
Environment=TP_SIZE=2

Ulimit=memlock=-1:-1
Ulimit=nofile=1048576:1048576
Ulimit=stack=67108864:67108864

Exec=/usr/local/bin/serve-ds4-flash.sh

[Service]
ExecStartPre=/usr/bin/mkdir -p /mnt/data/hf/jit/ds4-v20-r24 /mnt/data/hf/tmp/ds4-v20-r24
TimeoutStartSec=3600
TimeoutStopSec=120
Restart=on-failure
RestartSec=30
LimitMEMLOCK=infinity
LimitNOFILE=1048576
LimitSTACK=67108864
--ipc=host と ShmSize= は同時に指定できません。Podman が起動時に拒否するため、どちらかを選びます。
今回の --privileged は、起動を優先した検証時の設定です。最小権限の構成ではありません。
GPU memoryとKV capacity
Graph capture 後の各GPUの内訳です。
| 項目 | 1 GPUあたり |
|---|---|
| Model weights | 81.01 GiB |
| Peak activation | 2.45 GiB |
| Non-torch memory | 0.20 GiB |
| CUDA graph | 0.14 GiB |
| GPU KV cache | 8.59 GiB |
生ログでは同じ startup sequence に memory 内訳と KV capacity が出ています。
  Aug 04 02:44:21 compute-server grandpa[572062]: (Worker_TP0 pid=264) INFO 08-04 02:44:21 [gpu_worker.py:617] Available KV cache memory: 8.59 GiB
Aug 04 02:44:21 compute-server grandpa[572062]: (EngineCore pid=179) INFO 08-04 02:44:21 [kv_cache_utils.py:2428] GPU KV cache size: 285,336 tokens
Aug 04 02:44:21 compute-server grandpa[572062]: (EngineCore pid=179) INFO 08-04 02:44:21 [kv_cache_utils.py:2429] Maximum concurrency for 262,144 tokens per request: 1.09x
Aug 04 02:44:27 compute-server grandpa[572062]: (Worker_TP0 pid=264) INFO 08-04 02:44:27 [gpu_worker.py:918] Free memory on device (93.73/94.97 GiB) on startup. Desired GPU memory utilization is (0.975, 92.59 GiB). Actual usage is 81.01 GiB for weight, 2.45 GiB for peak activation, 0.2 GiB for non-torch memory, and 0.14 GiB for CUDAGraph memory. Replace gpu_memory_utilization config with `--kv-cache-memory-bytes=9288604570` (8.65 GiB) to fit into requested memory, or `--kv-cache-memory-bytes=10511114752` (9.79 GiB) to fully utilize gpu memory. Current kv cache memory in use is 8.59 GiB.
Aug 04 02:44:36 compute-server grandpa[572062]: (EngineCore pid=179) INFO 08-04 02:44:36 [core.py:345] init engine (profile, create kv cache, warmup model) took 47.53 s (compilation: 12.64 s)
Active sequenceの割り振り
GPU KV を約256Kの active working set として管理する案です。
| Active sequences | 1 sequenceあたりの総token目安 |
|---|---|
| 1 | 256K |
| 2 | 128K |
| 4 | 64K |
総tokenは prompt と生成済みoutput の合計です。64K input に32K生成すると、その sequence は96Kを使います。
MAX_MODEL_LEN=262144 のまま MAX_NUM_SEQS を4に増やし、agent-loop / orchestrator で active sequence の総tokenを制限する方法が考えられます。
sum(active prompt tokens + generated tokens + output headroom) <= approximately 256K
Native CPU KV offload
KV_OFFLOADING_SIZE=8 は、TP0とTP1で共有する8 GiBの host RAM pool です。
  Aug 04 02:44:22 compute-server grandpa[572062]: (Worker_TP0 pid=264) INFO 08-04 02:44:22 [shared_offload_region.py:85] Created mmap file /dev/shm/vllm_offload_f5388900-1119-46b2-b2eb-178e4b7e21c5.mmap (8.59 GB)
Aug 04 02:44:22 compute-server grandpa[572062]: (Worker_TP1 pid=265) INFO 08-04 02:44:22 [shared_offload_region.py:93] Opened existing mmap file /dev/shm/vllm_offload_f5388900-1119-46b2-b2eb-178e4b7e21c5.mmap
Aug 04 02:44:22 compute-server grandpa[572062]: (Worker_TP0 pid=264) INFO 08-04 02:44:22 [shared_offload_region.py:176] Unlinked mmap file /dev/shm/vllm_offload_f5388900-1119-46b2-b2eb-178e4b7e21c5.mmap after 2 workers mapped it
mmap file は SSD ではなく、通常 tmpfs の /dev/shm に置きます。実体は host DRAM で、GPUとの転送はPCIe 5.0 x16を通ります。
bytes / recorded copy time の加重平均は、store が54.38 GB/s、load が51.46 GB/sでした。
| Direction | Weighted rate | Observed range |
|---|---|---|
GPU to host RAM (store) | 54.38 GB/s | 52.09-55.56 GB/s |
Host RAM to GPU (load) | 51.46 GB/s | 48.02-54.91 GB/s |
最大store intervalは1.415 GB / 27.17 ms、最大load intervalは185.3 MB / 3.37 msでした。
  Aug 04 02:49:49 compute-server grandpa[572062]: (APIServer pid=53) INFO 08-04 02:49:49 [metrics.py:103] KV Transfer metrics: vllm:kv_offload_store_bytes=1415335680, vllm:kv_offload_store_time=0.027173248052597042, vllm:kv_offload_store_size_count=18, vllm:kv_offload_store_size_sum=1415335680, vllm:kv_offload_cpu_cache_usage_perc=0.0, vllm:kv_offload_cpu_allocation_size_count=7, vllm:kv_offload_cpu_allocation_size_sum=503, vllm:kv_offload_cpu_cache_write_usage_perc=0.0, vllm:kv_offload_cpu_cache_read_usage_perc=0.0
Aug 04 02:49:59 compute-server grandpa[572062]: (APIServer pid=53) INFO 08-04 02:49:59 [metrics.py:103] KV Transfer metrics: vllm:kv_offload_cpu_cache_usage_perc=0.0, vllm:kv_offload_cpu_cache_write_usage_perc=0.0, vllm:kv_offload_cpu_cache_read_usage_perc=0.0, vllm:kv_offload_lookup_sync_delay_seconds_count=5, vllm:kv_offload_lookup_sync_delay_seconds_sum=9.603999751561787e-05, vllm:kv_offload_load_bytes=185264640, vllm:kv_offload_load_time=0.0033739200830459597, vllm:kv_offload_load_size_count=2, vllm:kv_offload_load_size_sum=185264640, vllm:kv_offload_cpu_allocation_size_count=5, vllm:kv_offload_cpu_allocation_size_sum=139, vllm:kv_offload_store_bytes=299439360, vllm:kv_offload_store_time=0.005468831906095147, vllm:kv_offload_store_size_count=10, vllm:kv_offload_store_size_sum=299439360
PCIe 5.0x16 の片方向raw帯域は約64 GB/sなので、50-55 GB/sはその範囲内です。
kv_offload_cpu_cache_usage_perc は最大約3.86%でした。8 GiB pool を使い切る負荷ではなく、offload の動作確認までです。巨大な CPU tier の容量は評価していません。
768GB RAMで増えるのはKVの保管量
768GB RAMを CPU KV offload に使っても、1 request の最大contextやGPU上の同時処理量は増えません。増えるのは、後続requestで再利用する prefix KV の保存量です。
TP2全体のGPU KV 17.18 GiBが285,336 logical tokensに相当しました。CPUでも同じ block layout を保つと仮定すると、512 GiB pool の換算は次のとおりです。
  285,336 tokens x (512 GiB / 17.18 GiB)
  = approximately 8.5 million token-block equivalents
262,144-token の履歴で約32本分ですが、同時実行数ではありません。再利用時は PCIe 経由でGPUへ戻します。保存量は block rounding、metadata、eviction、shared prefix でも変わります。
native offload は未使用の prefix KV をCPUへ退避する cache です。実行中requestをCPUだけで継続しません。KV_OFFLOADING_SIZE を512 GiBへ増やしても、次の値は変わりません。
MAX_MODEL_LEN- GPU KV cacheの285,336 tokens
- GPU上のactive working set
- 設定済みの
MAX_NUM_SEQS
512 GiBの shared mmap には、十分な /dev/shm、空きRAM、memlock、CUDA host registration が必要です。
df -h /dev/shm
8 GiB run からの上限換算です。512 GiBでの起動、latency、実効capacityは未検証です。
Generation throughputとDSpark acceptance
vLLM の10秒ごとの metrics window を集計しました。
Running: 1の22 windowsからmedianとTukey IQRを算出- Generation throughputがnonzeroの34 windowsからmeanを算出
- DSpark metricsがある34 windowsからacceptance統計を算出
- CPU KV bandwidthは
sum(bytes) / sum(recorded transfer time)で算出
| Metric | Value |
|---|---|
| Peak generation throughput | 359.0 tok/s |
| Single-active-request median | 230.9 tok/s |
| Single-active-request IQR | 167.9-279.3 tok/s |
| Mean across nonzero windows | 205.6 tok/s |
| Peak prompt throughput | 5,790.1 tok/s |
| Acceptance length median | 5.12 |
| Acceptance length mean | 4.86 |
| Acceptance length best | 5.90 |
| Draft acceptance median | 82.4% |
| Draft acceptance mean | 77.2% |
| Draft acceptance best | 98.1% |
| Draft acceptance range | 41.9-98.1% |
| Accepted speculative throughput median | 161.2 tok/s |
| Accepted speculative throughput best | 298.2 tok/s |
最も acceptance が高い window は98.1%、generation throughputは359.0 tok/sでした。
  Aug 04 02:46:09 compute-server grandpa[572062]: (APIServer pid=53) INFO 08-04 02:46:09 [loggers.py:314] Engine 000: Avg prompt throughput: 0.0 tokens/s, Avg generation throughput: 359.0 tokens/s, Running: 1 reqs, Waiting: 0 reqs, GPU KV cache usage: 1.9%, Prefix cache hit rate: 88.1%, External prefix cache hit rate: 0.8%
Aug 04 02:46:09 compute-server grandpa[572062]: (APIServer pid=53) INFO 08-04 02:46:09 [metrics.py:125] SpecDecoding metrics: Mean acceptance length: 5.90, Current speculative depth: 5, Accepted throughput: 298.18 tokens/s, Drafted throughput: 303.98 tokens/s, Accepted: 2982 tokens, Drafted: 3040 tokens, Per-position acceptance rate: 1.000, 0.998, 0.993, 0.972, 0.941, Avg Draft acceptance rate: 98.1%
prompt によって acceptance は41.9%まで下がりました。
  Aug 04 02:47:59 compute-server grandpa[572062]: (APIServer pid=53) INFO 08-04 02:47:59 [loggers.py:314] Engine 000: Avg prompt throughput: 0.0 tokens/s, Avg generation throughput: 193.9 tokens/s, Running: 1 reqs, Waiting: 0 reqs, GPU KV cache usage: 3.3%, Prefix cache hit rate: 95.2%, External prefix cache hit rate: 9.3%
Aug 04 02:47:59 compute-server grandpa[572062]: (APIServer pid=53) INFO 08-04 02:47:59 [metrics.py:125] SpecDecoding metrics: Mean acceptance length: 3.09, Current speculative depth: 5, Accepted throughput: 131.19 tokens/s, Drafted throughput: 313.47 tokens/s, Accepted: 1312 tokens, Drafted: 3135 tokens, Per-position acceptance rate: 0.789, 0.542, 0.362, 0.247, 0.152, Avg Draft acceptance rate: 41.9%
Peakの359 tok/sから速度は acceptance によって変わります。今回の中心値は single-active-request median の約231 tok/sです。
Prompt throughput 5,790.1 tok/sは mixed long-context workload の window peak です。固定長の独立した prefill benchmark ではありません。
  Aug 04 02:49:39 compute-server grandpa[572062]: (APIServer pid=53) INFO 08-04 02:49:39 [loggers.py:314] Engine 000: Avg prompt throughput: 2649.6 tokens/s, Avg generation throughput: 107.1 tokens/s, Running: 1 reqs, Waiting: 0 reqs, GPU KV cache usage: 79.4%, Prefix cache hit rate: 95.9%, External prefix cache hit rate: 3.7%
Aug 04 02:49:49 compute-server grandpa[572062]: (APIServer pid=53) INFO 08-04 02:49:49 [loggers.py:314] Engine 000: Avg prompt throughput: 5790.1 tokens/s, Avg generation throughput: 115.7 tokens/s, Running: 1 reqs, Waiting: 0 reqs, GPU KV cache usage: 4.2%, Prefix cache hit rate: 95.9%, External prefix cache hit rate: 3.7%
GPU KV usage は最大79.4%でした。285,336 slotsの単純換算で約226Kですが、複数request、shared prefix、block allocation を含むため、単一prompt長ではありません。
Prefix cache
Prefix cache hit rate は最大97.4%、external prefix cache は最大11.4%でした。
  Aug 04 02:49:29 compute-server grandpa[572062]: (APIServer pid=53) INFO 08-04 02:49:29 [loggers.py:314] Engine 000: Avg prompt throughput: 293.2 tokens/s, Avg generation throughput: 136.6 tokens/s, Running: 0 reqs, Waiting: 0 reqs, GPU KV cache usage: 0.0%, Prefix cache hit rate: 97.4%, External prefix cache hit rate: 6.7%
Aug 04 02:50:39 compute-server grandpa[572062]: (APIServer pid=53) INFO 08-04 02:50:39 [loggers.py:314] Engine 000: Avg prompt throughput: 250.6 tokens/s, Avg generation throughput: 166.5 tokens/s, Running: 1 reqs, Waiting: 0 reqs, GPU KV cache usage: 2.1%, Prefix cache hit rate: 95.5%, External prefix cache hit rate: 11.4%
External prefix cache と native CPU KV offload は別の機能です。Gilded Gnosis r24 の runbook は native offload を qualified host-cache path、DS4の LMCache を experimental としています。
Coding-agent workload
リクエストは自作 agent-loop の Familiar を通しました。tool-call correction と telemetry を適用しており、vLLMへの直接送信ではありません。
代表requestは44 messages、10 tools、41,230 prompt tokens、800 completion tokensでした。
  {"time":"2026-08-04T11:49:58.642929+09:00","level":"INFO","msg":"backend POST","url":"http://compute.home.arpa:8000/v1/chat/completions","model":"grandpa","stream":true,"req_stream_arg":true,"payload_bytes":180640,"total_content_chars":136124,"n_messages":44,"tools":10,"max_tokens":32768,"max_completion_tokens":32768,"reasoning_format":null,"reasoning_effort":null,"temperature":0.7}
{"time":"2026-08-04T11:50:02.952783+09:00","level":"INFO","msg":"http request","method":"POST","path":"/v1/chat/completions","status":200,"duration":4317612500,"model":"familiar","message_count":44,"prompt_tokens":41230,"completion_tokens":800}
記録した access log には HTTP 200 が101件あり、同じ範囲の non-200、CUDA OOM、fatal CUDA error、traceback は0件でした。
  Aug 04 02:50:28 compute-server grandpa[572062]: (APIServer pid=53) INFO:     10.10.10.2:52922 - "POST /v1/chat/completions HTTP/1.1" 200 OK
Aug 04 02:50:30 compute-server grandpa[572062]: (APIServer pid=53) INFO:     10.10.10.2:52922 - "POST /v1/chat/completions HTTP/1.1" 200 OK
Aug 04 02:50:34 compute-server grandpa[572062]: (APIServer pid=53) INFO:     10.10.10.2:52922 - "POST /v1/chat/completions HTTP/1.1" 200 OK
Aug 04 02:50:36 compute-server grandpa[572062]: (APIServer pid=53) INFO:     10.10.10.2:52922 - "POST /v1/chat/completions HTTP/1.1" 200 OK
Aug 04 02:50:38 compute-server grandpa[572062]: (APIServer pid=53) INFO:     10.10.10.2:52922 - "POST /v1/chat/completions HTTP/1.1" 200 OK
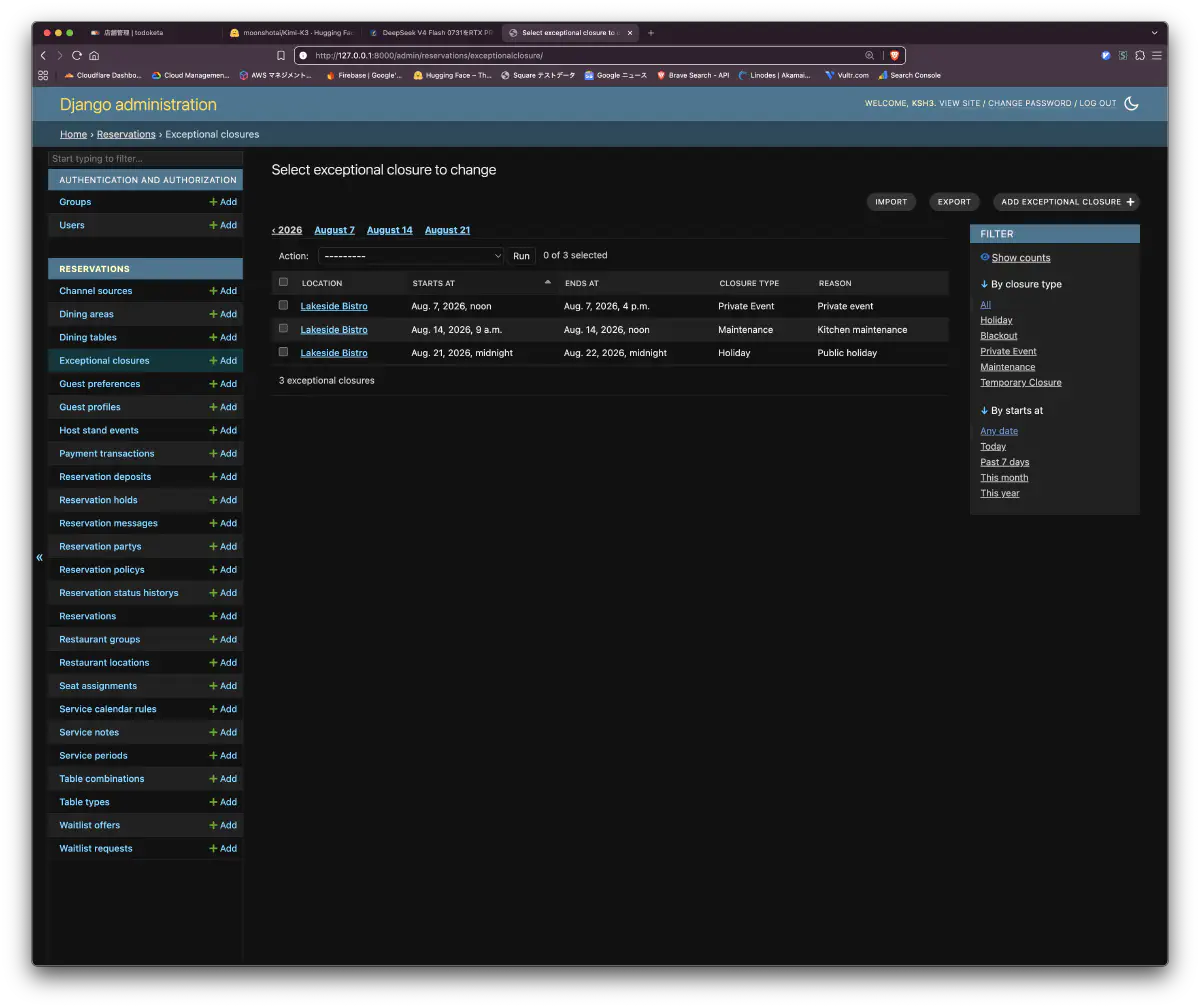
業務システム開発の例として、Django の restaurant reservation system を生成しました。25 domain models、9 public service methods、12 API endpoints、Django Admin、seed dataを含み、52 testsがすべて通りました。
uv run --frozen --offline python manage.py test --verbosity 2
  Ran 52 tests in 0.419s
OK
Seed data 投入後、Django Admin で Lakeside Bistro の Private Event、Maintenance、Holiday の3件の exceptional closure を確認しました。
別途レビューでは、timezone-aware availability calculation、waitlist / hold の expiry enforcement、invalid foreign key handling に問題が残りました。生成物は scaffold より大きいものの、まだ prototype です。
注意点
256K capacityと256K correctnessは別
確認できたのは、262,144 context 設定で起動し、285,336 GPU KV tokens を確保し、mixed long-context workload が安定して完走したことです。
CPU offload APIはexperimental
起動ログでは CPUOffloadingSpec API は experimental です。r24 の runtime test は通っていますが、API contract は今後変わる可能性があります。
Aug 04 02:44:21 compute-server grandpa[572062]: (Worker_TP0 pid=264) WARNING 08-04 02:44:21 [base.py:493] Initializing OffloadingSpec. This API is experimental and subject to change in the future as we iterate the design.
First-run JIT
初回は SparkInfer、TileLang、CUDA graph artifact を compile します。engine initialization は47.53秒、そのうち compilation は12.64秒でした。JIT cache volume を再利用すると、この処理を省けます。
Tool Call
Familiar は tool-call recovery と Vector への telemetry 送出を行います。エディタでの使用では大きく変わらないと考えていますが、direct vLLM の tool calling と同じ結果かは未確認です。
Throughput と DSpark の数値は vLLM server-side metrics log から取得しています。
次に調整する構成
terminal での出力は良いと感じました。長く使っていた stepfun から、ds4 で再調整する予定です。
次は、agent-loop で1 x 256K、2 x 128K、4 x 64Kの総tokenを管理する案を考えています。GPUの active working set を約256Kに保ち、host RAM は再利用可能な prefix KV の保存に使います。