
DeepSeek-V4-FlashをDwarfStar4の2ノードで評価
DeepSeek-V4-FlashのIQ2XXSを2GPUで動かしたローカルAI開発環境の記録です。生成速度、DAGと再計画、Djangoモデル生成、ツール抽出の失敗を確認しました。
DeepSeek-V4-FlashのIQ2XXS版をDwarfStar4の2ノードで起動し、オーケストレーションとコーディングを分けて評価しました。Step-3.7-Flashの単一モデル構成で改善した後の検証です。AIシステム開発で使うローカルエージェントの役割分担を見ています。
TGは31.7-35.8t/sでした。Step-3.7-FlashやQwen3.6-27B-EAGLEに比べ、長いコードを書かせるには待ち時間が大きく感じます。開発初期の1ショットは10-20分でしたが、完走するようになった最近の処理はTG100でも60-70分です。出力は良い印象でもツールが不安定なため、軽量workerのspeculative decodingと組み合わせる案を考えています。
DwarfStar4/DeepSeek-V4-Flashをctx 44kのorchestrator、Qwen3.6-27Bをctx 144kのworkerにした構成は使いやすい印象でした。単体モデルのagent化が進むDwarfStarのcommitが増えたら、再度確認する予定です。
検証の目的
orchestrator/planner/coder/tester/reviewer/integratorの各ロールにモデルを割り当てます。orchestratorがターンごとに次の作業を判断します。
orchestratorでは、長い文脈のprefix cacheとctx windowのローリングを重視します。cache hitを保ちながら意味と構造を維持する役割で、workerほど生成速度だけが支配的ではありません。
構成
| 項目 | 内容 |
|---|---|
| Model | DeepSeek-V4-Flash-IQ2XXS-w2Q2K-AProjQ8-SExpQ8-OutQ8-chat-v2-imatrix.gguf |
| Runtime | DwarfStar4 (ds4-server) |
| GPU | NVIDIA RTX PRO 6000 Blackwell Max-Q 96GB x 2 |
| Node A | PID 5435 / GPU0 / port 8001 |
| Node B | PID 5543 / GPU1 / port 8002 |
| VRAM | 各 95.3 GiB / 95.6 GiB 使用 |
| Host RAM | 各 ~83.5 GB |
| Context | 98304 |
| Balancing | オーケストレーション層で起動した2ノードへ分散 |
2つのQuadletユニットは、--portとGPU割り当てだけを変えています。
  [Unit]
Description=familiar orchestrator backend (DwarfStar 4 / DeepSeek V4 Flash) node-a
After=network-online.target
Wants=network-online.target

[Container]
ContainerName=ds4-node-a
Image=registry.home.arpa/dwarfstar4:ad0209f
Pull=always
Network=host
AddDevice=nvidia.com/gpu=0
Volume=/mnt/data/models/.../snapshots/<rev>:/model:ro
Volume=/mnt/data/models/.../kv_cache:/kv
Exec=-m /model/DeepSeek-V4-Flash-IQ2XXS-w2Q2K-AProjQ8-SExpQ8-OutQ8-chat-v2-imatrix.gguf \
  --ctx 98304 --host 0.0.0.0 --port 8001 \
  --warm-weights --kv-disk-dir /kv/node-a --kv-disk-space-mb 4096 \
  --trace /kv/trace.node-a.log

[Service]
TimeoutStartSec=900
TimeoutStopSec=30
Restart=on-failure
RestartSec=30
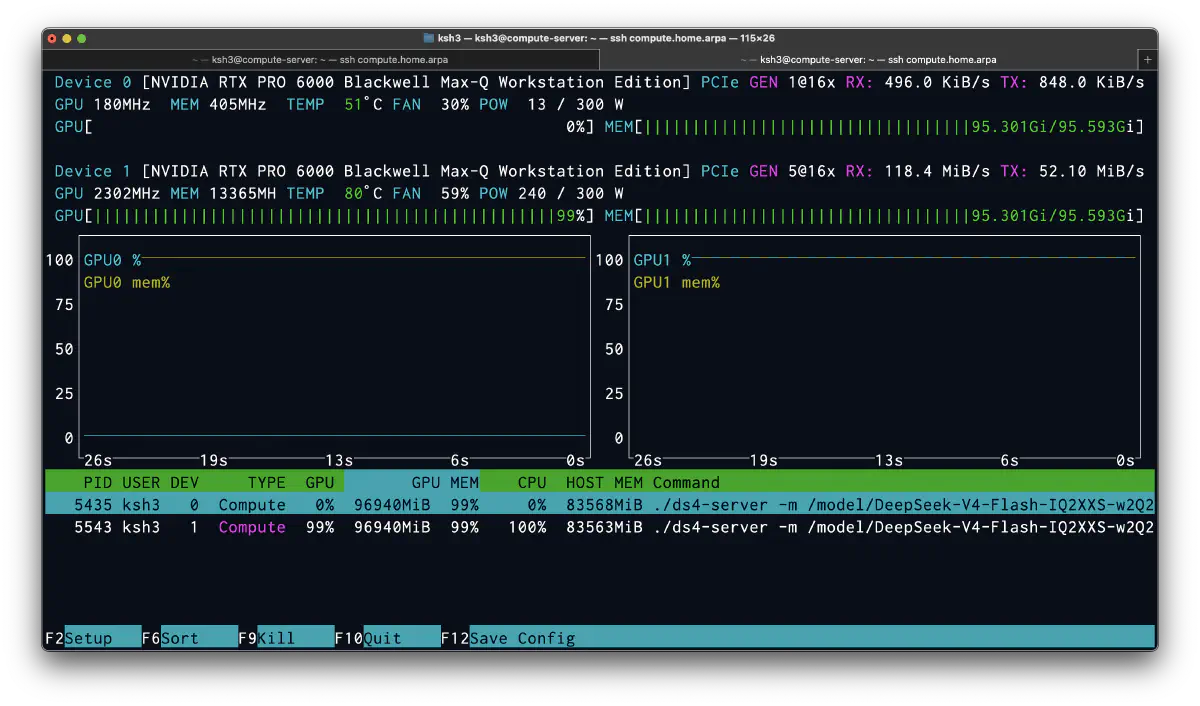
nvtopで各プロセスが別GPUを使い、それぞれ約96GBのVRAMを確保していると確認しました。
実測結果
生成スループット
decodeは31.7-35.8t/sでした。ツール応答後のTHINKINGと長い再計画では約35.7t/s、prefillは227-241t/sです。
観測時はGPU1が2302MHz/240W/99%でdecodeし、GPU0は180MHz/13Wで待機していました。逐次依存があるターンは片側に寄り、2ノードの効果は並行ターンやworkerがある場合に出ます。暑い時期に交互に使える点は良いと感じました。Broadcomの10GbE NICはlink downでも熱があり、Realtek 8127だったと思うNICは低温ですが、帯域を使い切るとSSHが不安定でした。
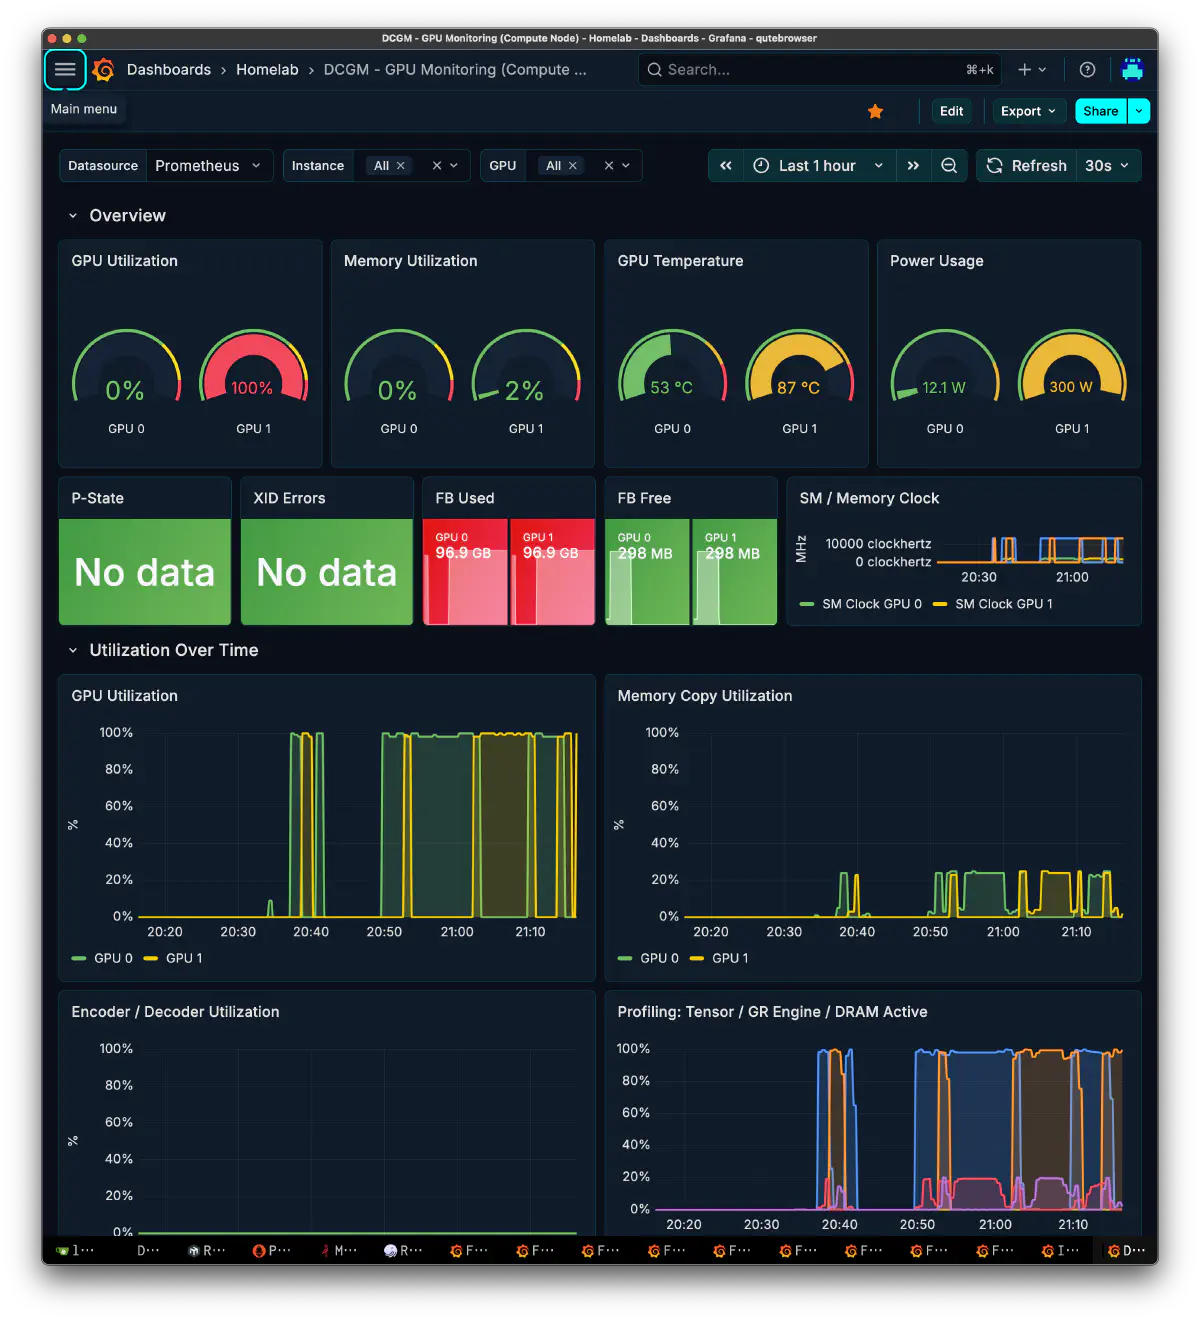
長い実装を出すworkerに使うと、1リクエストの待ち時間が大きくなります。
オーケストレーション結果
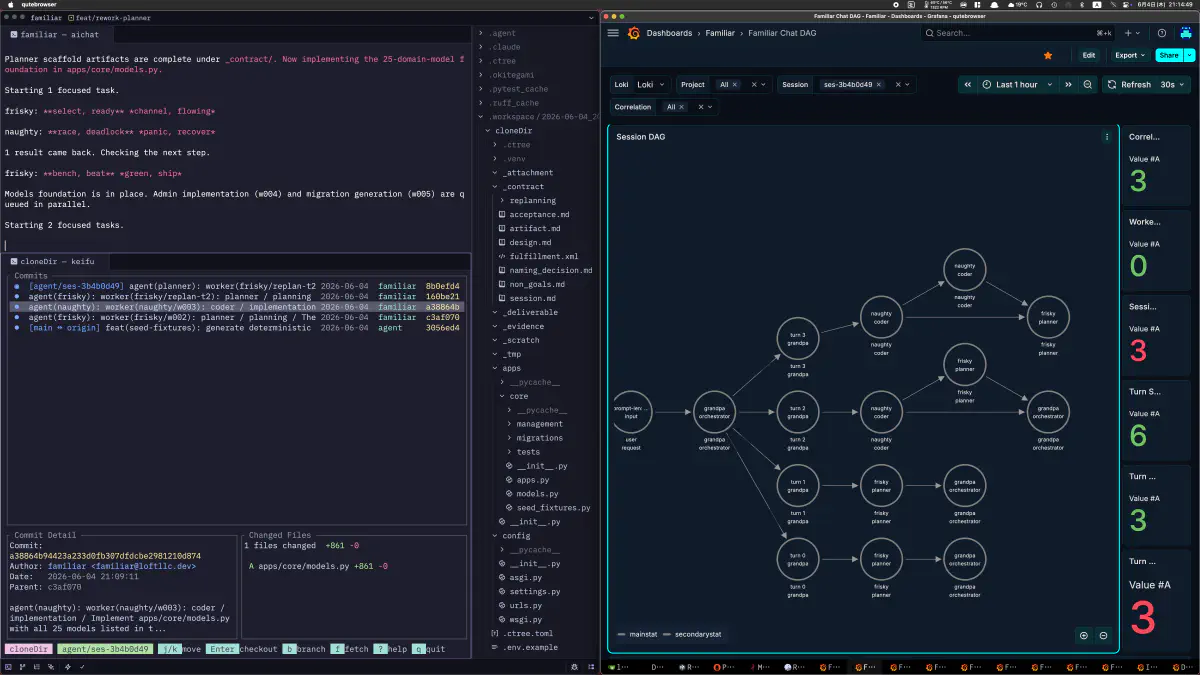
1セッション、3ターンの集計です。
| 指標 | 値 |
|---|---|
| orchestrator 判断回数 | 3 |
| planned worker | 5 |
| dependency block | 0 |
| worker failure rate | 33.3% |
| recovery | 2 |
5workerを計画し、1workerが失敗、再計画が2回ありました。replan-t2はfail、replan-t3はcapacityと依存でblockです。DAG構築、依存解決、再計画は動いていました。
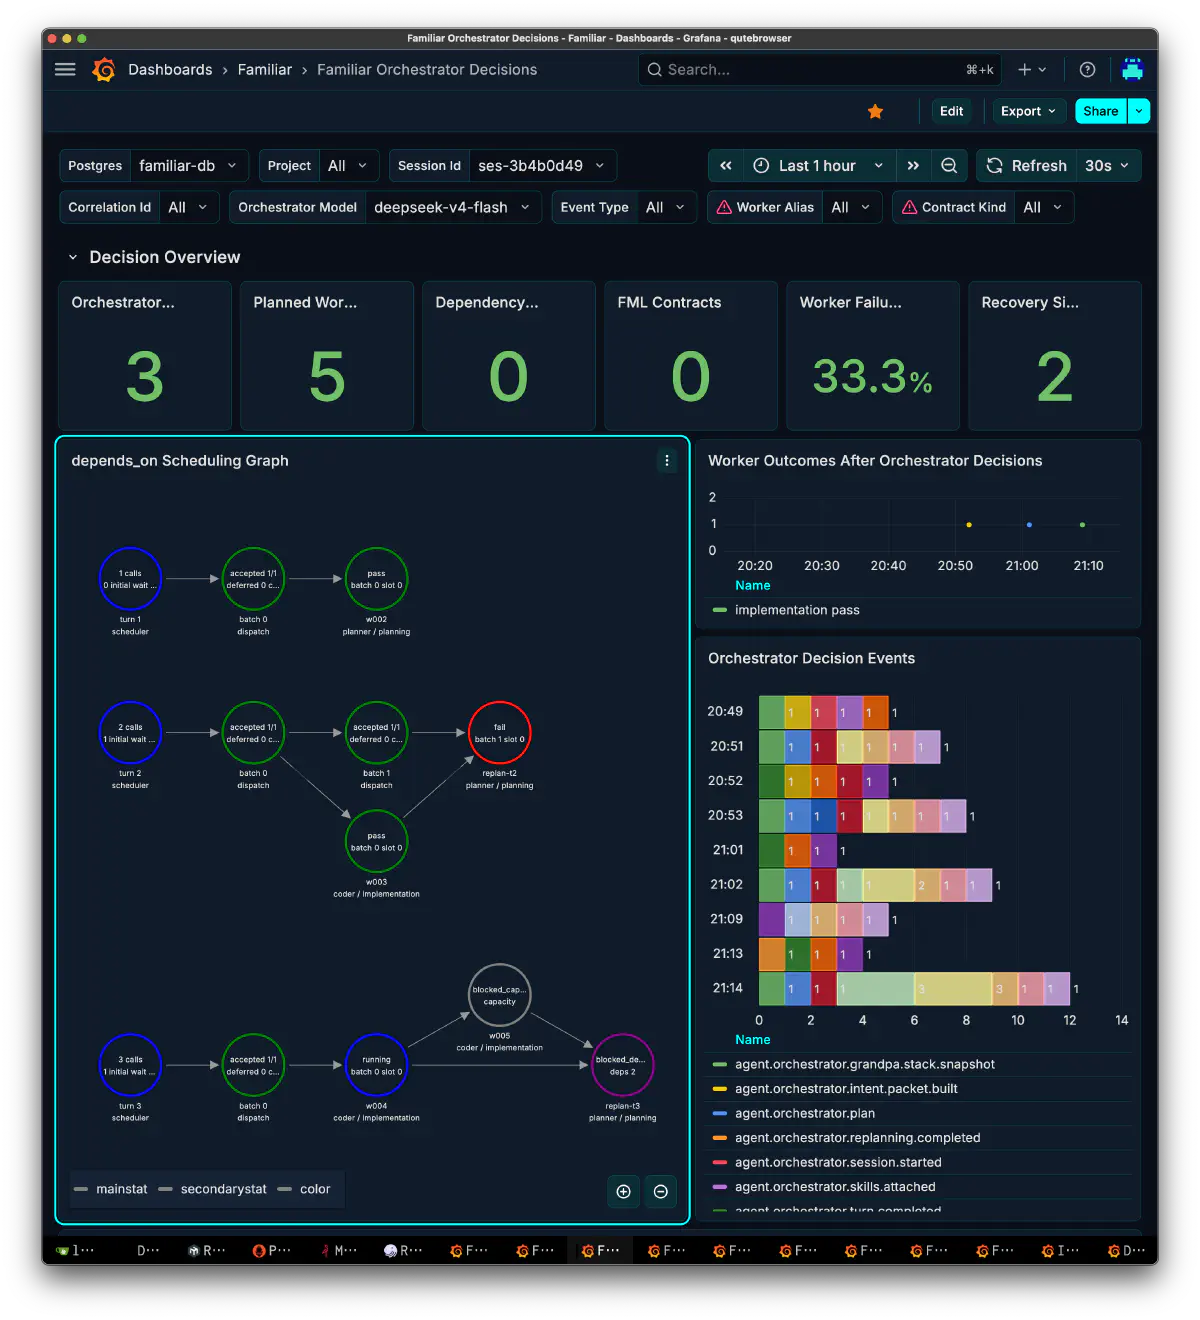
Chat DAGでも、user requestからplanner/coderへ分岐し、結果が戻る流れを確認できました。
ツール呼び出し
| 指標 | 値 |
|---|---|
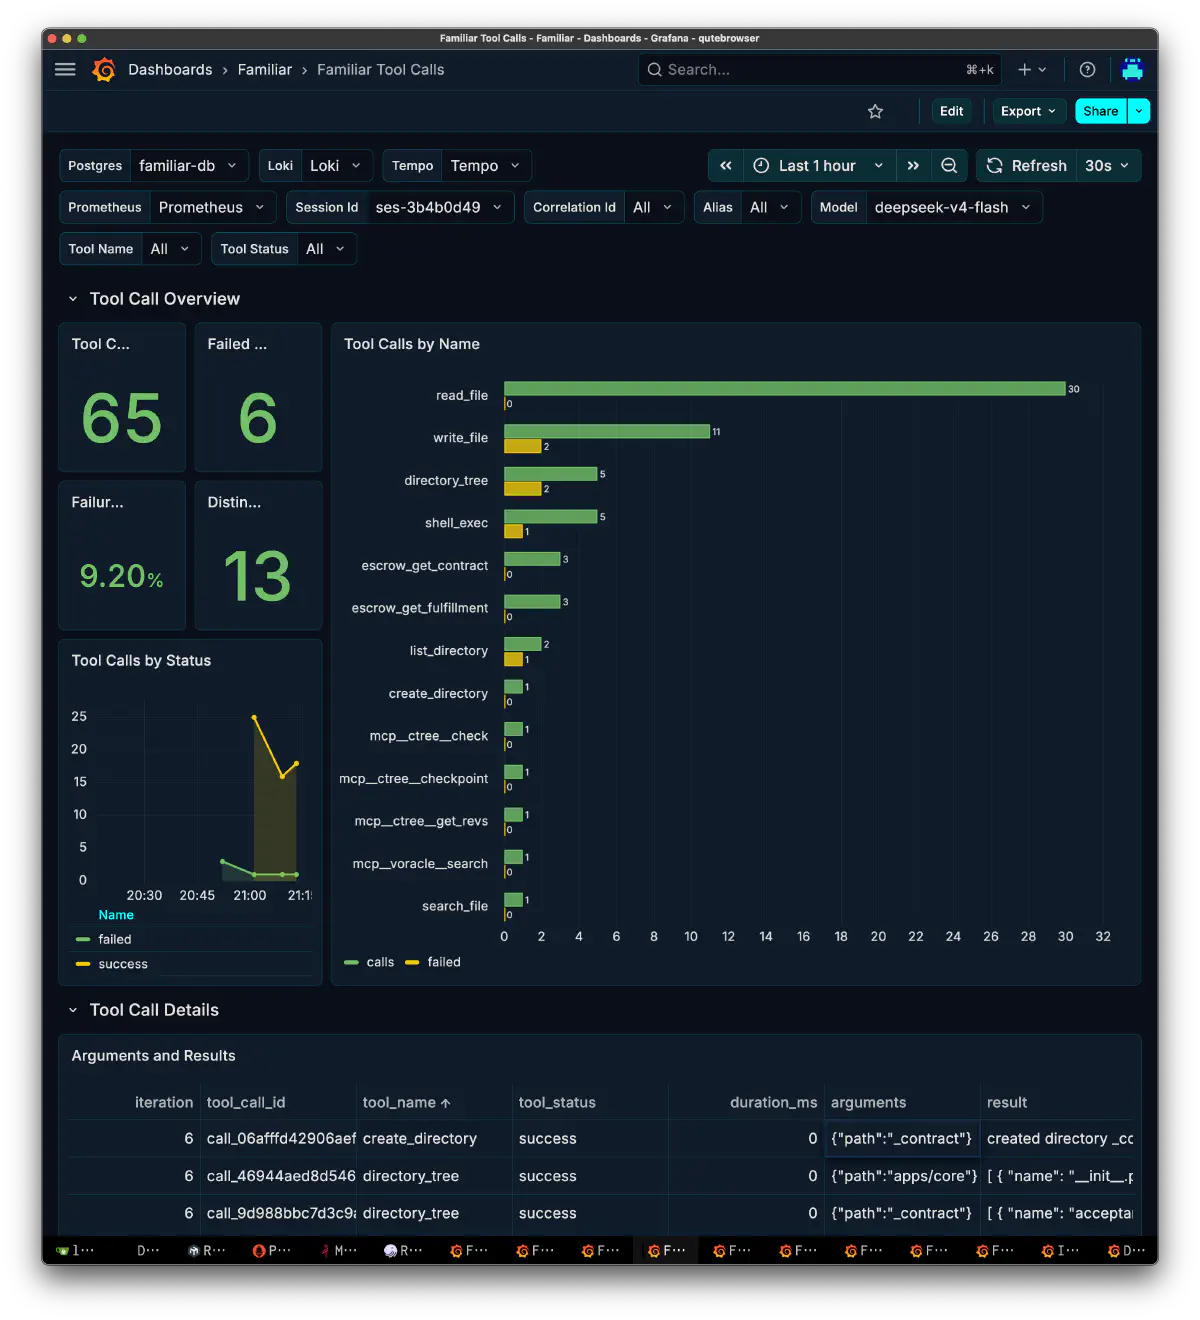
| tool call 総数 | 65 |
| failed | 6 |
| failure rate | 9.20% |
| distinct tool | 13 |
read_fileは30回、write_fileは11回、directory_treeとshell_execは各5回でした。失敗記録はwrite_fileが2回、directory_treeが2回、shell_execが1回、その他が1回です。読み取りは書き込みの約3倍でした。
失敗には独自ガードや論理判定の偽陽性も含みます。ツール自体の失敗率としては使わず、呼び出し量の参考にします。
実際に生成された成果物
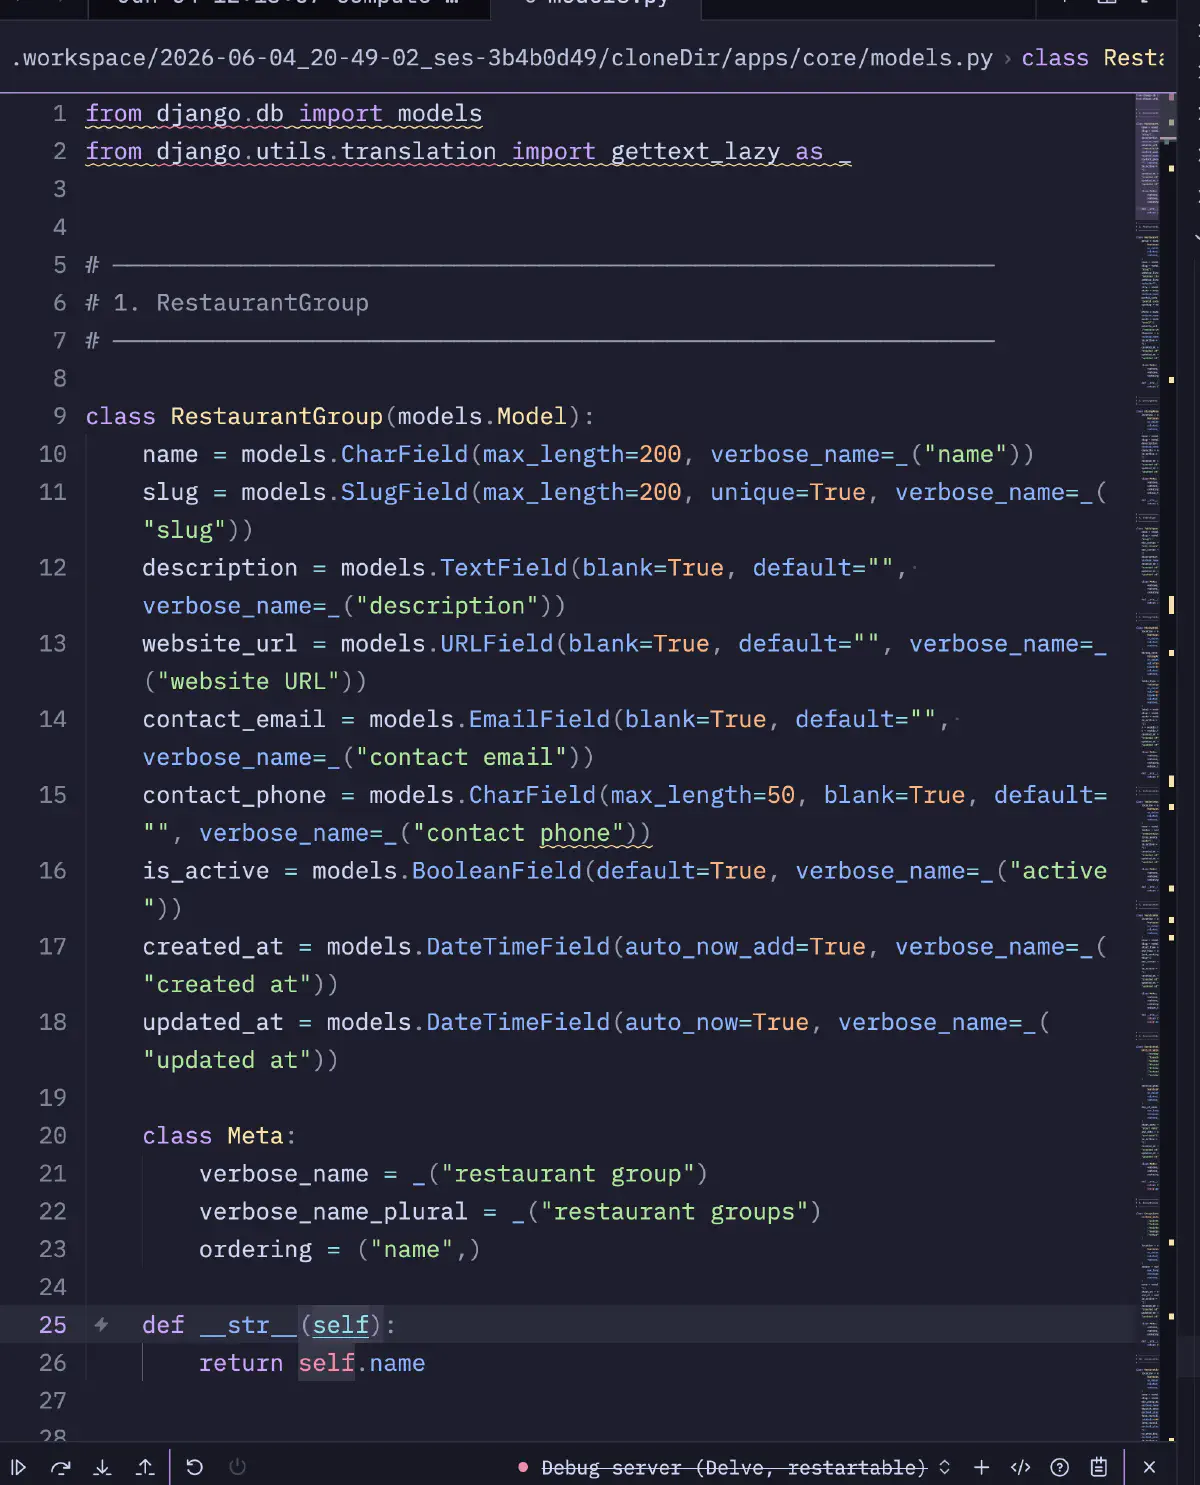
課題はDjangoの25ドメインモデルを、スキャフォールドからapps/core/models.pyへ実装するものでした。コミットa38864bの1ファイル、差分+861 -0です。
最初のRestaurantGroupを抜粋します。
  from django.db import models
from django.utils.translation import gettext_lazy as _


# ──────────────────────────────────────
# 1. RestaurantGroup
# ──────────────────────────────────────

class RestaurantGroup(models.Model):
    name = models.CharField(max_length=200, verbose_name=_("name"))
    slug = models.SlugField(max_length=200, unique=True, verbose_name=_("slug"))
    description = models.TextField(blank=True, default="", verbose_name=_("description"))
    website_url = models.URLField(blank=True, default="", verbose_name=_("website URL"))
    contact_email = models.EmailField(blank=True, default="", verbose_name=_("contact email"))
    contact_phone = models.CharField(max_length=50, blank=True, default="", verbose_name=_("contact phone"))
    is_active = models.BooleanField(default=True, verbose_name=_("active"))
    created_at = models.DateTimeField(auto_now_add=True, verbose_name=_("created at"))
    updated_at = models.DateTimeField(auto_now=True, verbose_name=_("updated at"))

    class Meta:
        verbose_name = _("restaurant group")
        verbose_name_plural = _("restaurant groups")
        ordering = ("name",)

    def __str__(self):
        return self.name
gettext_lazy、blank=Trueとdefault=""、Metaのverbose_name/ordering、__str__が揃い、25モデルで大きなぶれはありませんでした。Qwen3.6でも近い出力は得られるため、TG100超と30台の待ち時間も含めて選ぶ必要があります。
観測された失敗モード
再計画のplannerで、速度とは別に次の失敗がありました。
  invalid tool call returned as assistant text finish=stop
  [text_len=1864 saw_start=1 saw_end=1]
plannerは新しい成果物を宣言しないと判断し、write_fileのcontent内にwire protocolのXML宣言を入れました。saw_start=1 saw_end=1を検出しても、tool callではなくassistant textに戻っています。
  <...DSML...tool_calls>
<...DSML...invoke name="write_file">
<...DSML...parameter name="content" string="true"><familiar wire=....
    <thought>Re-planning pass: ... No deviations requiring corrective scope. ...</thought>
本来トップレベルに置く文書が引数内へ入り、パーサーが文脈を確定できなかったと考えています。
考えられる要因です。
- モデル挙動: 再計画時に成果物宣言とツール呼び出しの境界を取り違える
- パーサ厳格性: 入れ子の構造化マーカーを安全側にテキスト扱いする
DeepSeekの検証はまだ少なく、XMLへの影響は未確定です。Qwen系ではXMLのwire protocolで誤りが増え、TOMLにすると減った一方、XMLを学習した利点も失う印象でした。HTML方式も、学習データに多い構造として今後の候補です。
現時点の評価
約34t/sは長い実装を書くworkerには遅く感じます。短い判断を出すorchestrator、または緩いライセンスを活かす蒸留データ元として使う案です。
今回のDAG、依存解決、再計画と生成物は良好でした。IQ2XXSでも動いており、以前はGLM-5.1のsmol-IQ2KSも長く使いました。経験上、100B以下のQ4/5で崩れる場面もあります。量子化の評価はcalibrationとPPLにも依存します。
再計画のtool-call-as-textは、パーサーとモデルの組み合わせの課題として残ります。XMLへ引かれる可能性があります。
最近のcommitでも再検証しましたが、今回のfamiliarのorchestratorにはStep-3.7-Flashの方が使いやすい印象でした。