
DeepSeek-V4-Flashのローカル推論:llama.cppとBlackwell 96GB×2
DeepSeek-V4-Flash(284B MoE / 13B active)をBlackwell Max-Q 96GB×2とllama.cppのWIPブランチで動かしました。ローカルLLM導入に向けたFP4/FP8 GGUFの速度測定と、公式コード・GGUF変換で止まった点の記録です。
DeepSeek-V4-Flash を RTX PRO 6000 Blackwell Max-Q 96GB x 2 で動かしました。llama.cpp の WIP ブランチと community GGUF を使い、生成速度は TG 35 t/s 前後でした。
284B MoE / 13B active のモデルを、native FP4/FP8 GGUF で載せています。Flash Attention は無効で、DSV4 の処理も最適化途中です。以下は 2026-04-27 時点の結果です。
動画リンク: https://www.youtube.com/watch?v=Hjl4efNonxE
使用したモデルと速度
使ったのは nsparks/DeepSeek-V4-Flash-FP4-FP8-GGUF と、llama.cpp PR #22378 の wip/deepseek-v4-support ブランチです。Hugging Face の model card は 284B params、GGUF は deepseek4 architecture としています。
| 項目 | 値 |
|---|---|
| Model | DeepSeek-V4-Flash |
| Parameters | 284B MoE |
| Active parameters | 13B |
| Experts | 256 experts / 6 active |
| GGUF | nsparks/DeepSeek-V4-Flash-FP4-FP8-GGUF |
| Runtime | llama.cpp wip/deepseek-v4-support |
| Commit range | b8942-ba173dd08 |
| Quantization | native FP4 + FP8 |
| GGUF size | 146GB |
| BPW | 4.39 |
| GPUs | RTX PRO 6000 Blackwell Max-Q 96GB x 2 |
入力処理(PP)と生成(TG)の測定結果です。
| 指標 | 値 |
|---|---|
| Prompt eval (PP) | 36.5-39.4 t/s |
| Token generation (TG) | 34.1-41.7 t/s |
| PP average | 38.3 t/s |
| TG average | 35.7 t/s |
| VRAM | GPU0: 75.1GB, GPU1: 72.8GB |
| Offloaded layers | 44/44 |
| CPU mapped | 1010 MiB |
| Flash Attention | disabled |
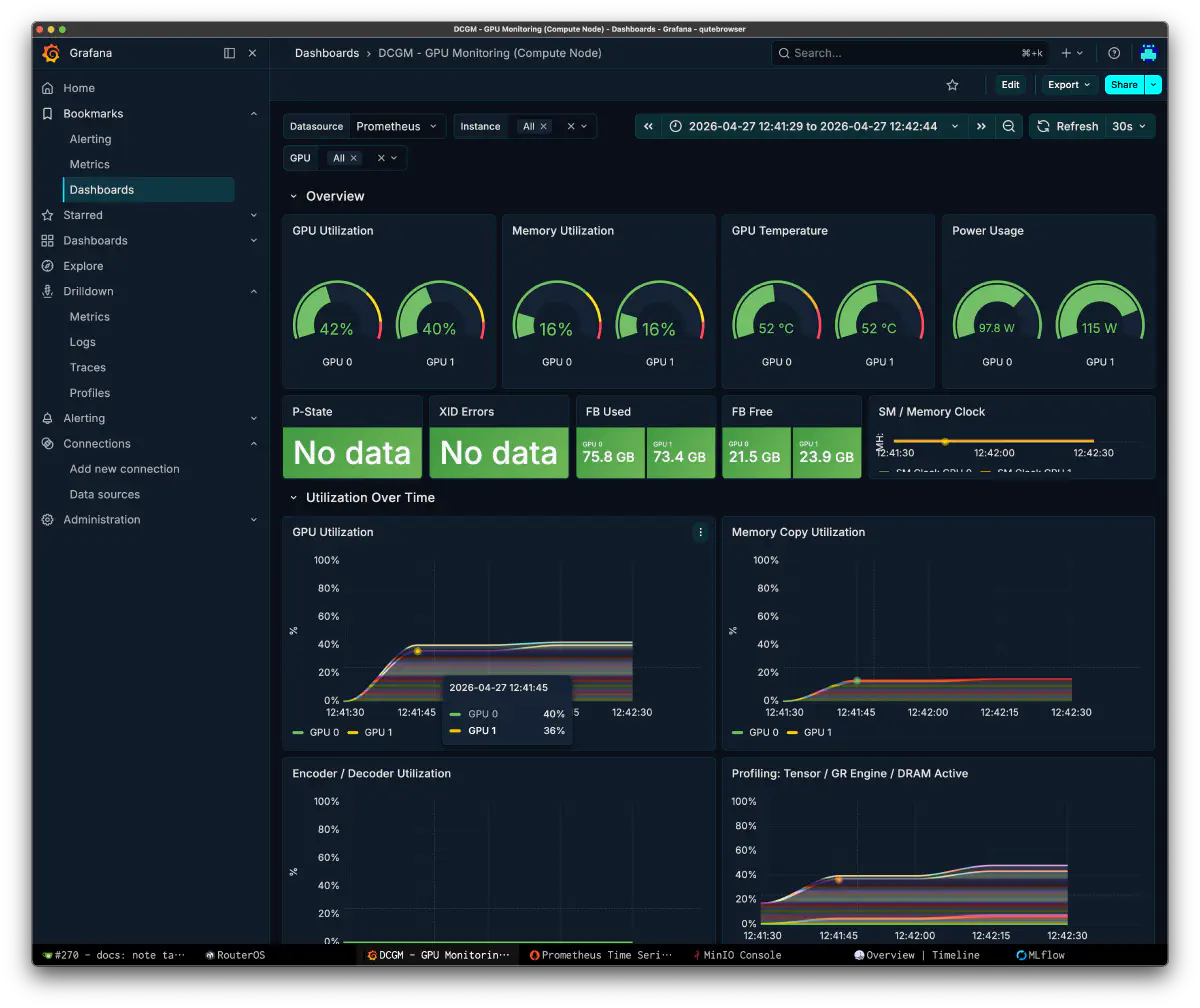
| GPU utilization | 30-40% burst |
| Peak power | GPU0: 97.8W, GPU1: 115W |
| Graph splits | 3 |
GPU 使用率は 30-40% の burst、消費電力は 100-115W 付近でした。300W TDP に対して低く、Flash Attention や expert dispatch graph の改善で速度が変わる余地はあると見ています。
起動コマンド
使った起動コマンドです。
  podman run --rm \
  -p 8000:8000 \
  --device nvidia.com/gpu=all \
  --shm-size 8g \
  -v /mnt/data/models/models--nsparks--DeepSeek-V4-Flash-FP4-FP8-GGUF:/models:Z \
  llama.cpp:deepseek-v4 \
  -s -m /models/snapshots/.../DeepSeek-V4-Flash-FP4-FP8-native.gguf \
  --n-gpu-layers 999 --threads 15 --threads-batch 24 \
  --ctx-size 8192 --parallel 1 -b 4096 -ub 2048 \
  --jinja --host 0.0.0.0 --port 8000 --alias deepseek-v4
llama-server に OpenAI 互換エンドポイントがあるため、公式 inference/ 用に作った API wrapper は不要になりました。
検証環境
| 項目 | 値 |
|---|---|
| GPU | NVIDIA RTX PRO 6000 Blackwell Max-Q 96GB x 2 |
| Compute Capability | sm_120 |
| Driver | 580.126.09 |
| CUDA | 13.0 |
| CPU | AMD EPYC 9175F |
| RAM | 768GB DDR5-6400 |
| Container | Podman |
| Native FP4 | BLACKWELL_NATIVE_FP4 enabled |
transformers で直接ロードした際は、GPU0/GPU1 とも VRAM を 80GB 前後使いました。初回 response は確認できましたが、prompt request で落ちました。公式推論コードも調べたあと、公開されていた GGUF に切り替えました。
リクエストごとの速度
短い prompt が中心です。長い入力での PP 性能を測った結果ではありません。
| # | 内容 | prompt tokens | PP (ms/t) | PP (t/s) | gen tokens | TG (ms/t) | TG (t/s) | total (s) |
|---|---|---|---|---|---|---|---|---|
| 1 | 日本語質問 | 14 | 26.7 | 37.4 | 41 | 27.1 | 36.9 | 1.5 |
| 2 | MoE説明 | 20 | 25.9 | 38.6 | 132 | 27.8 | 36.0 | 4.2 |
| 3 | FP4 vs FP8 | 19 | 25.9 | 38.7 | 125 | 27.7 | 36.1 | 4.0 |
| 4 | system prompt | 31 | 25.8 | 38.7 | 182 | 27.8 | 36.0 | 5.9 |
| 5 | マルチターン | 50 | 25.9 | 38.6 | 512 | 28.0 | 35.7 | 15.6 |
| 6 | Go code | 23 | 25.8 | 38.7 | 230 | 27.8 | 35.9 | 7.0 |
| 7 | 論理問題 | 23 | 25.9 | 38.7 | 207 | 27.8 | 35.9 | 6.4 |
| 8 | 比較分析 | 30 | 25.8 | 38.7 | 427 | 28.0 | 35.8 | 12.7 |
| 9 | JSON出力 | 26 | 27.4 | 36.5 | 122 | 29.3 | 34.1 | 4.3 |
| 10 | DSV4アーキテクチャ | 45 | 25.8 | 38.7 | 414 | 27.9 | 35.8 | 12.7 |
MoE 説明、コード生成、論理問題の短いテストでは、大きな破綻はありませんでした。ただし、日本語のストリーミングで 東東京圜 のような出力が何度かありました。テストブランチでの少数の試行なので、主に TG の目安として見ています。
Flash Attention は無効でした
ログでは、Flash Attention が自動で無効になっています。
  sched_reserve: layer 0 is assigned to device CUDA0 but the Flash Attention tensor is assigned to device CPU (usually due to missing support)
sched_reserve: Flash Attention was auto, set to disabled
DeepSeek-V4 は CSA、HCA、Indexer を含む独自の attention を使います。この WIP ブランチでは、対応する Flash Attention が実装途中に見えます。GPU 使用率が 30-40% に留まる主因ではないかと考えています。
Flash Attention 対応後は PP の改善を見込んでいます。一方、TG は 4.39 BPW の native FP4/FP8 GGUF を 2GPU に分散して読むため、メモリ帯域や expert dispatch の影響が大きいと見ています。
公式推論コードで止まった点
GGUF の前に、公式 repository の inference/*.py を試しました。generate.py でローカル生成する構成で、HTTP endpoint はありません。そこで tokenizer、model、distributed runtime を呼ぶ FastAPI + uvicorn の wrapper を作り、OpenAI 互換の /v1/chat/completions を用意しました。
weight 変換は MP=2 で成功しました。transformers 直ロードでは各 GPU に 80GB 前後を使い、公式 inference/*.py 経由でも初回 response を確認しました。起動時の nvtop では、GPU0/GPU1 それぞれの process が 79680MiB 程度を使い、VRAM 使用率は約 81% でした。
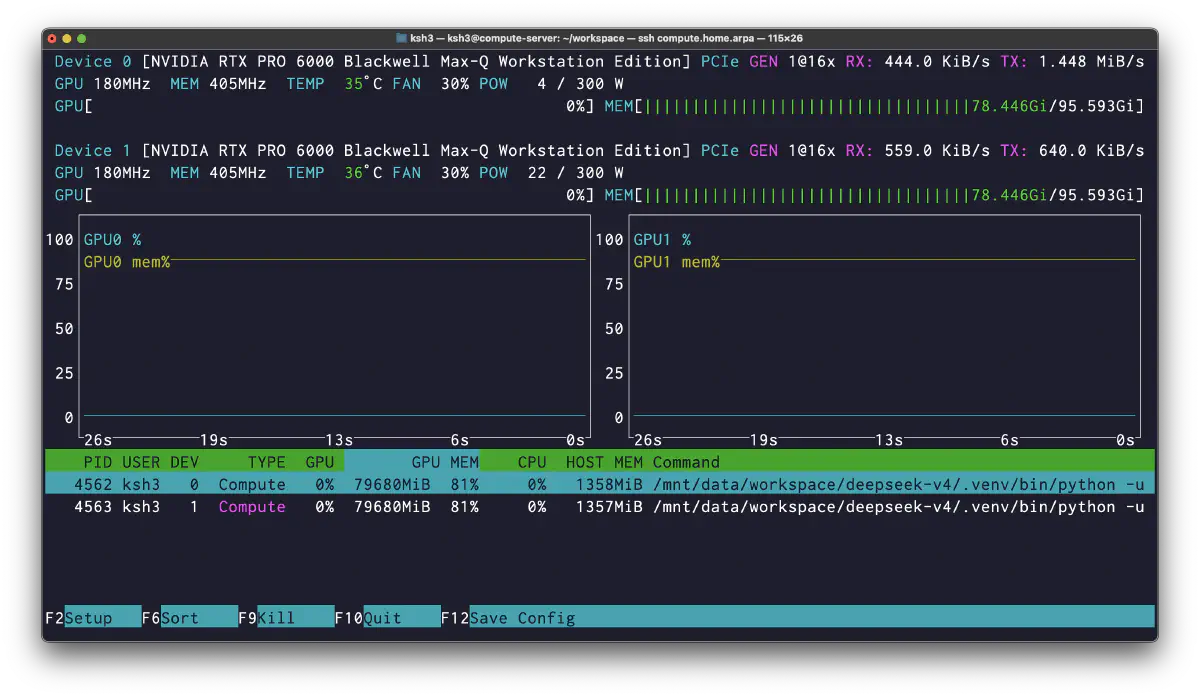
ただし、prompt request でプロセスが落ちました。次の問題を調べましたが、NGC コンテナの torch version と DSV4 の FP4 dtype 要件が最後まで残りました。
  python convert.py --hf-ckpt-path ${HF_CKPT_PATH} --save-path ${SAVE_PATH} \
  --n-experts 256 --model-parallel 2
  NCCL_NET_PLUGIN=none NCCL_IB_DISABLE=1 PYTHONPATH=. \
torchrun --standalone --nproc-per-node 2 main.py \
  --ckpt-path ${SAVE_PATH} --config ${CONFIG} --port 8000
調べた問題と対処です。
| 問題 | 状態 |
|---|---|
| NCCL segfault | broadcast 時に ncclNetPluginInit 周辺で segfault。NCCL_NET_PLUGIN=none NCCL_IB_DISABLE=1 で回避 |
| tilelang が CUDA を検出しない | ベアメタル側に CUDA toolkit がなく、container overlay から nvcc を symlink して回避 |
| sparse attention の shared memory | tilelang の CSA sparse attention kernel が 104KB dynamic shared memory を要求 |
| block size 調整 | sparse attention の block size を 64 -> 32 に落として shared memory 側は回避 |
| NGC torch が古い | nvcr.io/nvidia/pytorch:25.04-py3 は torch 2.7.0 |
| DSV4 FP4 dtype | DeepSeek-V4-Flash が使う torch.float4_e2m1fn_x2 は torch 2.11+ 前提 |
Blackwell は 228KB/SM まで dynamic shared memory を使えます。tilelang の sparse attention kernel が求める 104KB は、ハードウェア上は収まるはずです。実際には block size を 64 -> 32 に下げると、この問題を越えられました。
NGC コンテナは torch 2.7.0 に固定され、DSV4 が使う float4_e2m1fn_x2 に対応していませんでした。依存関係の制約もあり、単純な差し替えでは解決しません。公式 inference/*.py の試行はここで止め、native FP4/FP8 GGUF の検証に移りました。
GGUF の自前変換
nsparks の WIP ブランチにある convert_hf_to_gguf.py でも変換を試しました。
  python3 convert_hf_to_gguf.py ${HF_SNAP} \
  --outtype native \
  --torch-threads 16 \
  --outfile dsv4-flash-native.gguf
変換では、次の問題がありました。
| 段階 | 結果 |
|---|---|
| torch 2.6 | F8_E8M0 KeyError |
| torch 2.11 CPU | F8_E8M0 は通る |
| transformers | deepseek_v4 model_type 未認識 |
| tokenizer | PreTrainedTokenizerFast への差し替えで一部回避 |
| pre-tokenizer | joyai-llm 未対応で断念 |
この時点で community GGUF が公開されていたため、自前変換を続けず、推論を試すことにしました。
使用した GGUF の変換方法
nsparks/DeepSeek-V4-Flash-FP4-FP8-GGUF の model card は、元のモデルを deepseek-ai/DeepSeek-V4-Flash としています。掲載されている変換コマンドです。
  python3 convert_hf_to_gguf.py /mnt/models/hf/DeepSeek-V4-Flash \
  --outtype moe-f8-e4m3-mxfp4 \
  --torch-threads 96 \
  --outfile DeepSeek-V4-Flash-FP4-FP8-native.gguf
DeepSeek 公式の Hugging Face repository は MIT License です。
2026-04-27 時点の upstream
2026-04-27 時点では、llama.cpp 本家の DeepSeek-V4 対応は WIP でした。
| PR / Discussion | 内容 |
|---|---|
| llama.cpp PR #22378 | wip/deepseek-v4-support。runtime graph、FP4/FP8 support、performance hot path を含む draft PR |
| llama.cpp PR #22359 | DeepSeek-V4 GGUF conversion script |
| Discussion #22376 | DeepSeek-V4 support discussion |
| nsparks GGUF | native FP4/FP8 GGUF |
| official HF | official DeepSeek-V4-Flash weights |
PR #22378 では、FP4/FP8 support、DeepSeek4 runtime state save、F8 decode tuning、TOP_K fast path、RMSNorm/copy kernel tuning が進んでいました。TG が -ot exps=CPU 時に近づく可能性もあります。
用途と長い文脈への期待
35 t/s なら、SFT、DPO 用の蒸留データやパイプライン、バッチ処理に使えると考えています。
自作エージェントでは GLM-5.1、Kimi-k2.6、Qwen3.5-397B をオーケストレーターの候補としていました。DeepSeek-V4-Flash も ik_llama.cpp や llama.cpp の最適化が進めば、CPU/GPU hybrid 構成の候補になりそうです。
KV cache を約 90% 減らすという情報から、GPU に全体を載せたまま長い ctx を扱う用途にも期待しています。
DeepSeek の公称値では、DSV4 の attention は V3.2 比で KV cache を 93%、FLOPs を 90% 減らします。
元の記録にある VRAM 使用量です。
- VRAM 合計: 192GB
- モデル: GPU0 75.1GB + GPU1 72.8GB = 147.9GB
- 空き: GPU0 21.5GB + GPU1 23.9GB = 45.4GB
KV cache が通常の 7% で済むなら、32-45GB の空き VRAM で大きな文脈を扱える可能性があります。複数モデルを役割ごとに動かして ctx を管理していた処理を、単一モデルにまとめられるかに関心があります。実現すれば、オーケストレーションの一部を減らせるかもしれません。