
DeepSeek V4 Flash Q2のDwarfStar 4実測
DeepSeek V4 Flash 284B Q2-imatrixをBlackwell 96GB 1枚で動かし、短文43.6 tok/s、50K contextで31.4 tok/sを測りました。ローカルLLM導入向けにKV cacheとagent実行を確認します。
antirez の DwarfStar 4(ds4.c)で、DeepSeek V4 Flash 284B の Q2-imatrix を RTX PRO 6000 Blackwell Max-Q Workstation Edition 96GB 1枚に載せました。生成速度は短文で43 tok/s、50K context で31 tok/s台でした。
alpha 版の、2026-05-14 時点の初期検証です。head / tail を指定するようなロール制御ができ、自作 agent の orchestrator として確認しています。今回の用途では32K–64Kが扱いやすく、96Kも候補です。128Kでは起動しましたが余裕が少ないため、当面は96Kを上限と考えています。
動画リンク: https://www.youtube.com/watch?v=A4aGNHEdrxE
測定結果
| 項目 | 値 |
|---|---|
| Model | DeepSeek V4 Flash |
| Parameters | 284B MoE / 13B active |
| Runtime | DwarfStar 4 (ds4.c) |
| Build | cuda-generic |
| Quant | IQ2_XXS + Q2_K routed expert, Q8 attention/shared/output |
| GGUF | DeepSeek-V4-Flash-IQ2XXS-w2Q2K-AProjQ8-SExpQ8-OutQ8-chat-v2-imatrix |
| GPU | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition |
| GPU memory | 96GB GDDR7 ECC |
| Memory bandwidth | 1,792 GB/s |
| Model tensor cache | 80.76 GiB |
| Peak observed VRAM | 93,142 MiB / 95,593 MiB |
| Short generation | 43.6 tok/s |
| 50K context generation | 31.4 tok/s |
| 20K prefill | 262 tok/s |
前回は llama.cpp の WIP DeepSeek-V4 branch で GPU 2枚を使いました。今回はモデル専用の ds4.c で、80GiB 級 Q2-imatrix GGUF を GPU 1枚に載せています。
50K context でも tool call の生成は31 tok/s以上で、複数ターンの agent session が完走しました。
DwarfStar 4 の設計
DwarfStar 4 は DeepSeek V4 Flash 専用の推論エンジンです。公式 README では、モデル読み込み、prompt rendering、tool calling、RAM / disk KV state、server API を専用実装していると説明されています。
単一モデルを対象に、logit、長文 context、agent integration を検証しています。エンジン、量子化、API、tool calling を合わせて確認する設計です。
CUDA backend を含め、alpha quality とされる実装です。今回の数値は完成版の性能上限を示すものではありません。
検証環境
| 項目 | 内容 |
|---|---|
| GPU | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition |
| GPU architecture | SM_120 (Blackwell) |
| VRAM | 96GB GDDR7 ECC |
| Memory bandwidth | 1,792 GB/s |
| CPU | AMD EPYC 9175F |
| RAM | 755 GiB |
| Storage | NVMe 3.5T (xfs) |
| OS | Ubuntu 24.04 |
| CUDA | 13.2.1 |
| Container | Podman rootless |
| Model | DeepSeek-V4-Flash-IQ2XXS-w2Q2K-AProjQ8-SExpQ8-OutQ8-chat-v2-imatrix |
| Engine | DwarfStar 4 (cuda-generic build) |
GPU は96GB GDDR7 ECC、メモリ帯域1,792 GB/sです。MoE decode で、GPU 1枚の帯域を使う構成を確認しました。
ビルドと起動
次のターゲットで CUDA 版をビルドしました。
make cuda-generic
grandpa 用の container image は CUDA 13.2.1 devel をもとに、ds4 の clone と cuda-generic build を行います。
  FROM docker.io/nvidia/cuda:13.2.1-cudnn-devel-ubuntu24.04

RUN apt-get update && apt-get install -y --no-install-recommends \
    git make gcc g++ ca-certificates && \
    rm -rf /var/lib/apt/lists/*

WORKDIR /app
RUN git clone --depth 1 https://github.com/antirez/ds4.git . && \
    make cuda-generic -j$(nproc)

EXPOSE 8000
ENTRYPOINT ["./ds4-server"]
Build と push の手順です。
  podman build -t registry.home.arpa/dwarfstar4:latest .
podman push registry.home.arpa/dwarfstar4:latest
Blackwell SM_120 では -arch=native が architecture を選びました。Podman rootless、NVIDIA CDI passthrough、host networking で実行しています。
ログでは CUDA backend の初期化、80GiB 級 tensor cache の device load、NVMe からのモデル読み込みを確認しました。
  ds4: CUDA backend initialized on NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition (sm_120)
ds4: CUDA loading model tensors into device cache: 80.04 GiB
ds4: CUDA startup model cache prepared 80.76 GiB of tensor spans in 16.198s
NVMe からの model cache の準備は約16.2秒でした。
Q2-imatrix 量子化
使用した GGUF は、routed expert を強く圧縮する非対称量子化です。
| Tensor class | Quant |
|---|---|
| routed expert up/gate | IQ2_XXS |
| routed expert down | Q2_K |
| shared experts | Q8_0 |
| attention projections | Q8_0 |
| output head | Q8_0 |
| router / embedding / auxiliary blocks | F16 / F32 |
サイズの大半を占める routed expert を圧縮し、router、attention projection、shared expert、output head は高めの精度を保ちます。284B を80GiB 級に収めながら、coding agent 用途の品質を保つ狙いです。
生成速度
生成速度は短文43.6 tok/s、50K context で31.4 tok/sでした。
| Context / generation | 生成速度 | 備考 |
|---|---|---|
| 短文 約100 tokens | 43.6 tok/s | Thinking mode |
| 中程度 約400 tokens 生成 | 41.7 tok/s | Thinking mode |
| 長文 4,058 tokens 生成 | 平均 38.5 tok/s / 最低 37.3 tok/s | Thinking to Text |
| 20K context | 36.3 tok/s | Tool calling 有効 |
| 33K context | 35.3 tok/s | 安定 |
| 50K context | 31.4 tok/s | 非常に安定 |
context が長くなると TG は低下しましたが、50Kでも31 tok/s台を保ちました。
この用途では32K–64Kを候補にしています。設計上は256Kの長文も扱えますが、agent では prefix の再利用と session 管理も必要です。
Prefill
prefill は2048 token の chunk ごとに進み、長い context でも245 tok/s以上でした。
| Token count | Prefill 速度 |
|---|---|
| 13K tokens | 267 tok/s |
| 20K tokens | 262 tok/s |
| 30K+ tokens incremental | 245-251 tok/s |
20K context の prefill は262 tok/sでした。チューニング中の GLM-5.1 は TG23、PP700程度で、orchestrator では prefill の差が気になります。repository には MTP 関連 PR があり、使えますが、現状では大きな効果は確認できていません。
VRAM 使用量
VRAM はほぼ使い切っています。
GPU MEM: 93,142 MiB / 95,593 MiB (95%)
tensor cache は80.76 GiBで、さらに context buffer と計算用 pool を使います。CPU offload はなく、GPU 1枚で動きます。
モデル、runtime、context を GPU 1枚に置き、Zed や自作 agent から OpenAI 互換 API で接続します。ローカルLLM導入時の構成を、GPU 2枚や hybrid 推論より小さくできます。
Disk KV Cache
disk KV cache は、DeepSeek V4 Flash の圧縮 KV を NVMe に保存・再利用する機能です。LMCache に近い使い方を想定できます。高速な外付け M.2 を専用にする案もありますが、熱への効果は未検証です。
evict 時の KV 保存は、ログでは200–370ms程度でした。
  kv cache stored tokens=3405  size=67.56 MiB  save=198.9 ms  reason=evict
kv cache stored tokens=54163 size=734.07 MiB save=371.9 ms  reason=evict
cold、continued、evict の trigger pattern と prefix reuse を確認しました。
| 実行 | 応答時間 |
|---|---|
| 初回実行 | 0.148 s |
| 再実行 | 0.073 s |
再利用した応答は、ほぼ半分の時間でした。長い system prompt や repository context を繰り返す agent では、TTFT に影響します。
自作 agent のマルチセッション context manager は、そのままでは KV reuse と合いませんでした。専用 context manager と adapter を追加し、single-session に近い前提を吸収しました。
他プラットフォームとの比較
同一条件の比較ではありません。公開値と手元の値では、メモリ帯域が高い環境ほど decode も速い傾向でした。
| Platform | Memory bandwidth | Generation | 備考 |
|---|---|---|---|
| DGX Spark GB10 | 273 GB/s | 10-14 tok/s | 参考値 |
| Mac Studio / Apple Silicon | 構成依存 | 16-36 tok/s | 参考値 |
| RTX PRO 6000 Blackwell Max-Q | 1,792 GB/s | 43.6 tok/s | 今回の実測 |
MoE decode は token ごとに expert weights を読みます。今回の GPU は1,792 GB/sで、43 tok/s台でした。Max-Q 以外なら PP が増える可能性はありますが、計測していません。
今後の改善候補です。
- CUDA backend が alpha 段階
- MTP対応
コーディングエージェント運用
Zed の AI Assistant を ds4-server の OpenAI 互換 API に接続し、coding task を実行しました。
DSML tool format の native support で、次の tool call を実行できました。
roots_listdirectory_treeread_fileterminalspawn_agent
builtin tools の read_text_file と list_directory が多く、ctree と pathfinder も使えました。terminal では _contract/architecture.md に grep -c を繰り返す挙動がありました。局所的な確認には使えますが、構造把握を ctree / pathfinder に寄せる余地があります。
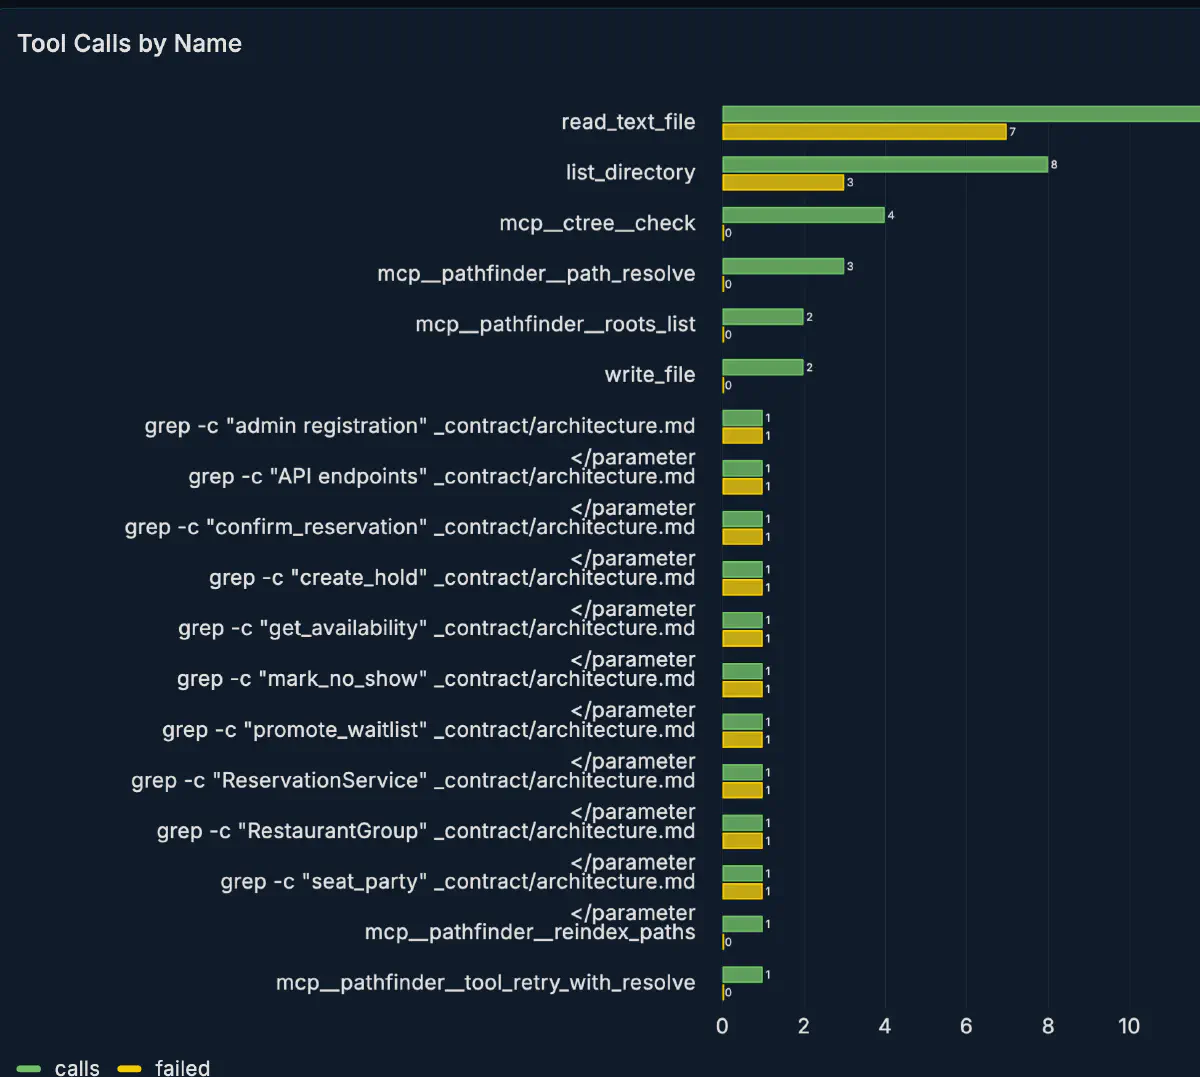
50K context で tool call は31 tok/s以上を保ち、複数ターンの session が完走しました。公式 sampling 値を、orchestrator 用に微調整しています。
挙動は Codex / Claude に近く感じましたが、置き換えを判断できるほどの検証はしていません。
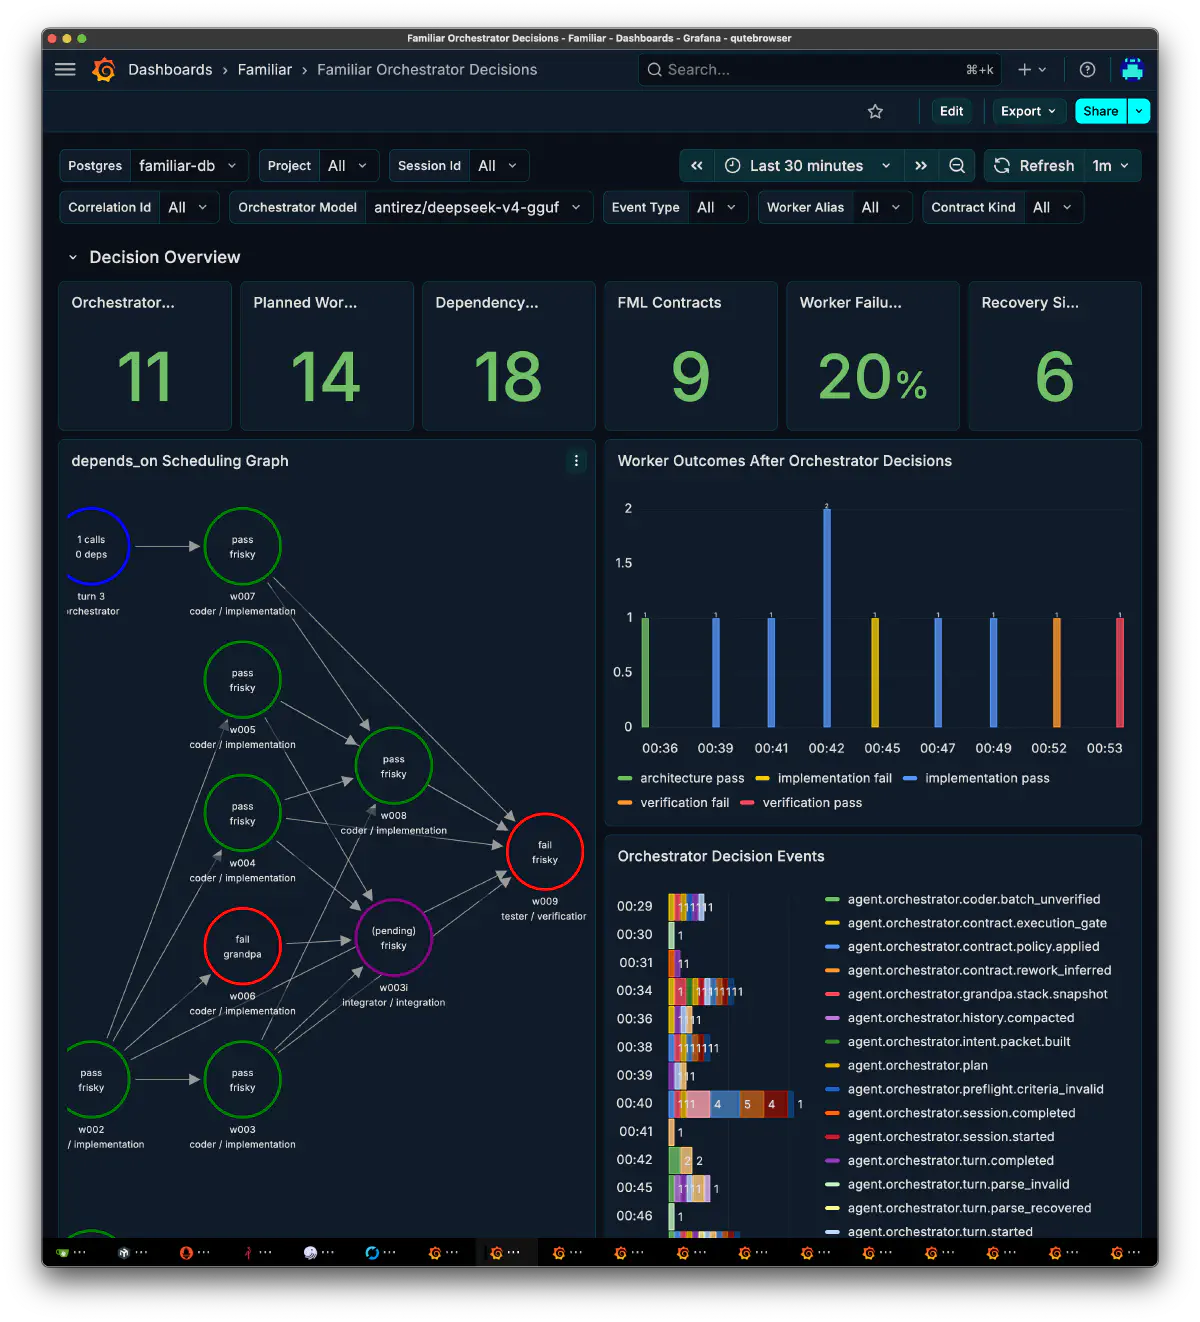
自作 agent に組み込み、初期検証を始めました。速度と context の確認が中心で、本格的な品質評価はこれからです。
orchestrator向けの設定
model=deepseek-chatで non-thinking mode を選べる--warm-weightsで初回推論時の stutter を減らせる--dir-steering-fileと--dir-steering-ffn -1で verbosity steering を当てられる-n 4096のように default output budget を絞れる- disk KV cache で長い orchestration session の prefix reuse を維持できる
コードレビュー用 worker は thinking と長い context、orchestrator は model=deepseek-chat の non-thinking で dispatch を担当させる案です。
ヘルプでは non-thinking の選択条件を次のように説明しています。
thinking={type:disabled}, think=false, or model=deepseek-chat selects non-thinking mode.
ds4-server の主なパラメータです。
| 分類 | パラメータ | 見立て |
|---|---|---|
| Model | -m, --model | ds4 専用 GGUF を指定する。汎用 GGUF runner ではない |
| MTP | --mtp, --mtp-draft, --mtp-margin | 投機デコード用。まだ experimental で、grandpa 常用では優先度低め |
| Context | -c, --ctx | 起動時に確保する context。grandpa は 32768 で十分、frisky は 131072 まで伸ばす余地あり |
| Output | -n, --tokens | max_tokens 省略時の default。grandpa は 4096 程度に絞る |
| CPU | -t, --threads | Tokenize / prompt rendering などの補助用。未指定でよい |
| Quality | --quality | 厳密カーネルに寄せる。品質評価や benchmark 用で、常駐 grandpa では基本不要 |
| Steering | --dir-steering-file, --dir-steering-ffn, --dir-steering-attn | grandpa は FFN 側に -1 を当てて簡潔方向を増幅。attention 側は実験用 |
| Warmup | --warm-weights | 常駐サービスなら付けておく。初回推論の page fault/stutter を減らす |
| Backend | --cuda, --metal, --cpu, --backend | RTX PRO 6000 では CUDA。CPU は診断用 |
| API | --host, --port | grandpa=8000, frisky=8001 のように role ごとに分ける |
| Trace | --trace | prompt、cache 判断、出力、tool call を human-readable に保存。fulfillment log や DPO データ化に使えるかもしれない |
| Thinking | reasoning_effort, thinking, think, model | grandpa は model=deepseek-chat で non-thinking。reviewer / frisky は thinking を使う価値あり |
| Disk KV | --kv-disk-dir, --kv-disk-space-mb, --kv-cache-* | grandpa は 4GB でも足りそう。長い review 履歴を持つ worker は 16GB もあり |
| Tools | --disable-exact-dsml-tool-replay, --tool-memory-max-ids | tool calling を使わない grandpa ではほぼ無関係 |
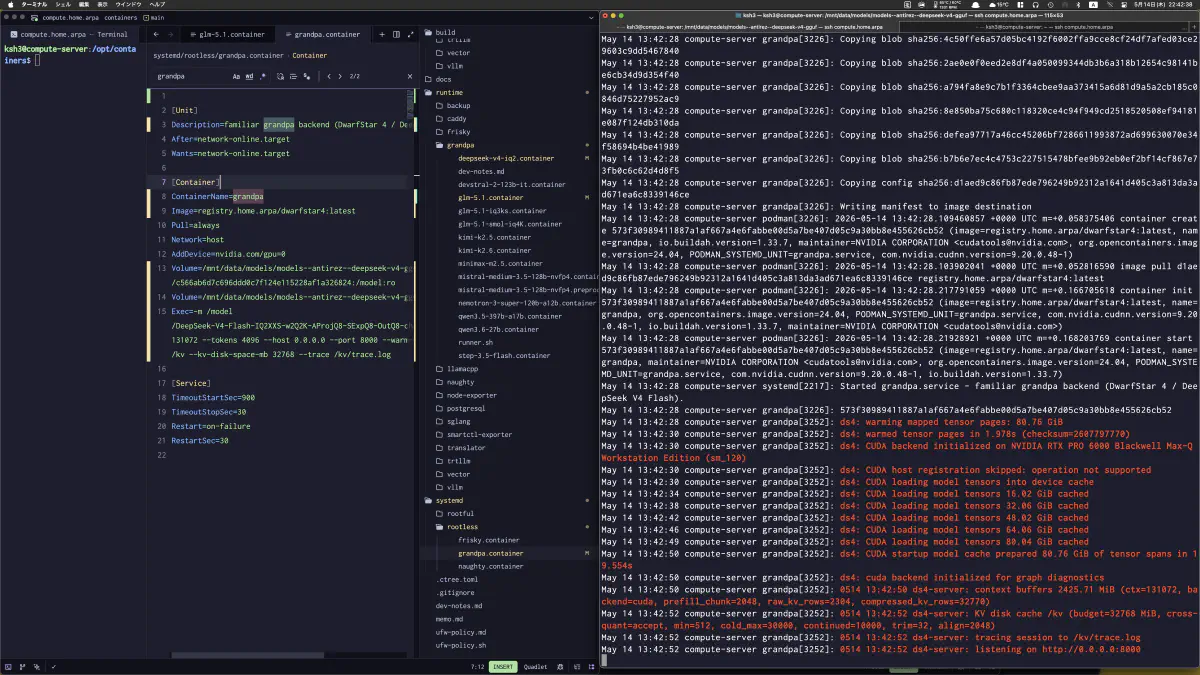
grandpa の常駐設定は --ctx 65536、--tokens 4096、disk KV 32GB、--trace を候補にしています。ツールなしの dispatch 専用なら --ctx 32768、disk KV 4GBまで減らす案です。
  [Container]
ContainerName=grandpa
Image=registry.home.arpa/dwarfstar4:latest
Pull=always
Network=host
AddDevice=nvidia.com/gpu=0
Volume=/mnt/data/models/models--antirez--deepseek-v4-gguf/snapshots/c566ab6d7c696ddd0c7f124e115228af1a326824:/model:ro
Volume=/mnt/data/models/models--antirez--deepseek-v4-gguf/kv_cache:/kv
Exec=-m /model/DeepSeek-V4-Flash-IQ2XXS-w2Q2K-AProjQ8-SExpQ8-OutQ8-chat-v2-imatrix.gguf --ctx 65536 --tokens 4096 --host 0.0.0.0 --port 8000 --warm-weights --kv-disk-dir /kv --kv-disk-space-mb 32768 --trace /kv/trace.log
同じ設定を一度確認するための podman run --rm -it です。
  podman run --rm -it \
  --device nvidia.com/gpu=0 \
  -v /mnt/data/models/models--antirez--deepseek-v4-gguf/snapshots/c566ab6d7c696ddd0c7f124e115228af1a326824:/model:ro,Z \
  -v /mnt/data/models/models--antirez--deepseek-v4-gguf/kv_cache:/kv:Z \
  --network host \
  registry.home.arpa/dwarfstar4:latest \
  -m /model/DeepSeek-V4-Flash-IQ2XXS-w2Q2K-AProjQ8-SExpQ8-OutQ8-chat-v2-imatrix.gguf \
  --ctx 65536 \
  --tokens 4096 \
  --host 0.0.0.0 \
  --port 8000 \
  --warm-weights \
  --kv-disk-dir /kv \
  --kv-disk-space-mb 32768 \
  --trace /kv/trace.log
steering vector は ds4 の dir-steering/ で生成し、mount して --dir-steering-file に渡します。verbosity.f32 は image に含まれないため、ホスト側で用意します。
  cd ~/src/ds4

python3 dir-steering/tools/build_direction.py \
  --ds4 ./ds4 \
  --model ds4flash.gguf \
  --good-file dir-steering/examples/succinct.txt \
  --bad-file dir-steering/examples/verbose.txt \
  --out dir-steering/out/verbosity.json \
  --component ffn_out \
  --ctx 512

ls -lh dir-steering/out/verbosity.f32
ik_llama.cpp は f_keep で cache を部分再利用します。ds4 は VRAM に live KV を1本持ち、session 切り替え時に disk へ evict save します。次の prefix が disk cache に hit すれば読み戻します。
Directional Steering
y = y - scale * direction[layer] * dot(direction[layer], y)
verbosity vector は43 layers × 4096 dimensions、約704KBです。scale で実行時の出力の詳しさを変えます。
| Scale | 挙動 |
|---|---|
-1 | 出力長を約半分へ圧縮 |
2 | 詳細説明を強化 |
例えば orchestrator に -1、reviewer に 2 を使い、fine-tuning せずにロールごとの詳しさを変える案があります。
まとめ
| 項目 | 内容 |
|---|---|
| Model | DeepSeek V4 Flash 284B |
| Runtime | DwarfStar 4 |
| GPU | RTX PRO 6000 Blackwell Max-Q 96GB x 1 |
| Quant | Q2-imatrix |
| Short generation | 43.6 tok/s |
| 50K context | 31.4 tok/s |
| Prefill | 245-267 tok/s |
| Model cache | 80.76 GiB |
| Peak VRAM | 93.1 GiB |
単一 GPU で短文43 tok/s、50K context で31 tok/s台を確認しました。EPYC 9175F の L3 512MB cache が影響した可能性もありますが、切り分けはしていません。
自作 agent では動作を確認できました。調整が進んだ GLM-5.1 と比べると回答内容はまだ粗く、最適化と品質評価を続ける段階です。
CUDA backend、disk KV cache、steering の改善を確認する予定です。候補のハードウェアとして AMD MI350P もリンクに載せていますが、適合性は未検証です。