
GLM-5.1のexpert配置とHybrid推論
GLM-5.1 IQ3_KSをBlackwell 96GB×2と768GB RAMで動かし、TG 17–19 tok/sを測りました。LLM導入向けにexpertの配置と、Qwen3.5とのorchestrator選定を検討します。
GLM-5.1 IQ3_KS(744B MoE、320 GiB)を RTX PRO 6000 Blackwell Max-Q 96GB×2 と768GB RAM で動かしました。ik_llama.cpp の CPU/GPU hybrid で TG は17–19 tok/sでした。familiar の常駐 orchestrator(grandpa)候補として、Qwen3.5-397B-A17B とも比較しています。
動画リンク: https://www.youtube.com/watch?v=1JRyuCUlFeI
Hardware
| Component | Spec |
|---|---|
| CPU | AMD EPYC 9175F (16C) |
| RAM | 768GB DDR5-6400 |
| GPU | NVIDIA RTX PRO 6000 Blackwell Max-Q 96GB × 2 |
Model
Zhipu の GLM 系 MoE です。起動ログは n_expert = 256、n_expert_used = 8 でした。
| Item | Value |
|---|---|
| Architecture | glm-dsa (MoE, 256 experts, 8 active) |
| Parameters | 753.864B |
| Quantization | IQ3_KS (3.65 BPW) |
| Model size | 320.216 GiB |
| Context | 65536 (max 202752) |
| GGUF | ubergarm/GLM-5.1-GGUF |
| Runtime | ik_llama.cpp |
GPUに置いたheadとtailのexpert
79 layer(blk.0–blk.78)で、blk.0–blk.2 は dense、blk.3–blk.78 は MoE です。
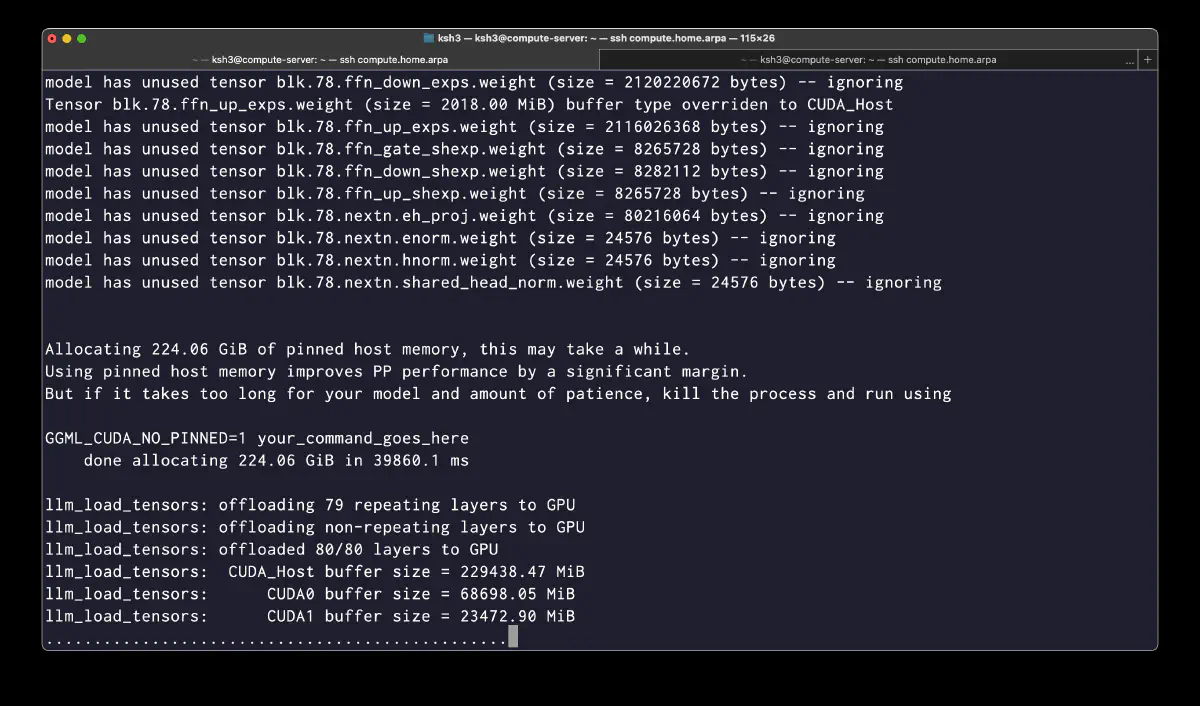
--cpu-moe で expert を CPU に置き、-ot で一部を GPU に戻します。今回は head 15層(blk.3–blk.17)を CUDA0、tail 4層(blk.74–blk.77)を CUDA1、中間56層を CUDA_Host の pinned host memory に置きました。
  OT_ARGS=""
for i in $(seq 3 17); do
  OT_ARGS="$OT_ARGS -ot blk.$i.ffn_gate_exps=CUDA0"
  OT_ARGS="$OT_ARGS -ot blk.$i.ffn_down_exps=CUDA0"
  OT_ARGS="$OT_ARGS -ot blk.$i.ffn_up_exps=CUDA0"
done
for i in $(seq 74 77); do
  OT_ARGS="$OT_ARGS -ot blk.$i.ffn_gate_exps=CUDA1"
  OT_ARGS="$OT_ARGS -ot blk.$i.ffn_down_exps=CUDA1"
  OT_ARGS="$OT_ARGS -ot blk.$i.ffn_up_exps=CUDA1"
done
1 MoE 層の exps は gate 1,225 + down 1,638 + up 1,225 = 4,088 MiBです。配置結果は次のとおりです。
| Device | Role | Buffer Size |
|---|---|---|
| CUDA0 | blk.0–2 dense + blk.3–17 experts (head 15 層) + attn/KV | 68,698 MiB (~67.1 GiB) |
| CUDA1 | blk.74–77 experts (tail 4 層) + attn/KV | 23,473 MiB (~22.9 GiB) |
| CUDA_Host | 中間層 experts (56 層分) | 229,438 MiB (~224.1 GiB) |
GPU の19層は77,672 MiB(約75.9 GiB)、CPU の56層は228,928 MiBです。ログの CUDA_Host は229,438 MiBでした。全76層なら76 × 4,088 = 310,688 MiB(約303.4 GiB)で、今回は約76 GiBを GPU に移しました。
起動コマンド
  podman run --rm \
  --device nvidia.com/gpu=all \
  -p 8000:8000 \
  --cap-add=SYS_NICE \
  -v /mnt/data/models/models--ubergarm--GLM-5.1-GGUF:/models:ro,Z \
  registry.home.arpa/ik_llama.cpp:latest \
  -m /models/.../IQ3_KS/GLM-5.1-IQ3_KS-00001-of-00008.gguf \
  --ctx-size 65536 -ctk q8_0 -ctv q8_0 \
  --parallel 1 --threads 15 --threads-batch 24 \
  -b 8192 -ub 8192 -ngl 99 --cpu-moe \
  $OT_ARGS \
  -ger -muge -amb 512 --jinja \
  --host 0.0.0.0 --port 8000 \
  --warmup-batch --alias glm-5.1
主なフラグです。
--cpu-moe: expert を CPU 側にデフォルト配置-ot blk.N.ffn_*_exps=CUDAX: 個別の expert tensor を GPU に override-ger -muge: grouped expert routing + multi-GPU expert-amb 512: attention memory budget--warmup-batch: 起動時にバッチ warmup
Django アプリ生成
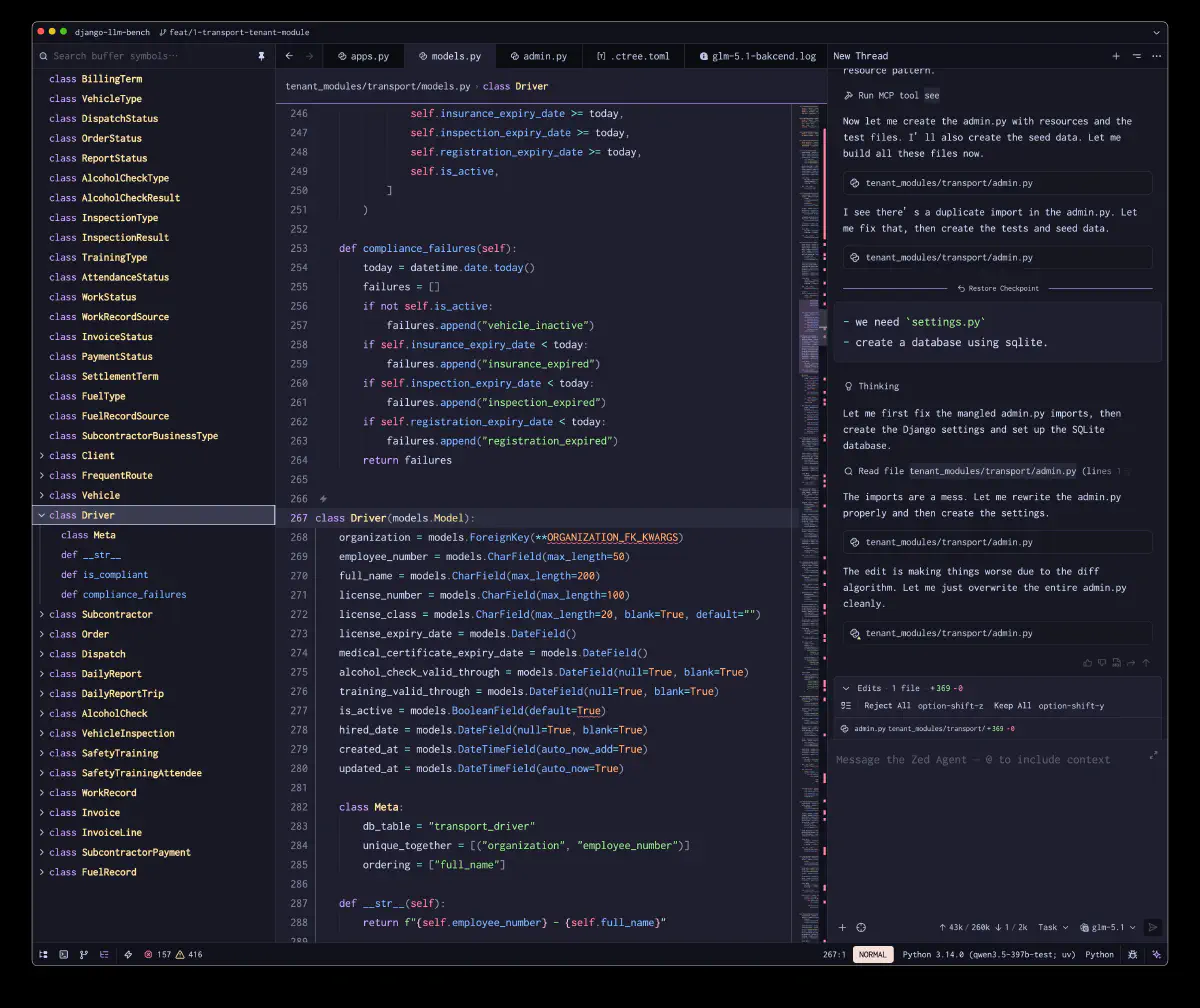
Zed agent で運送業のテナントモジュールを生成しました。モデル、admin、テスト、シードデータを一から作るタスクで計測しています。業務システム開発にローカルLLMを使う際の実行例です。
Token Generation (TG)
| Metric | Value |
|---|---|
| Requests | 46 |
| Total generated tokens | 16,092 |
| Total prompt tokens | 131,985 |
| TG min | 16.39 tok/s |
| TG max | 19.38 tok/s |
| TG median | 17.94 tok/s |
| TG mean | 17.77 tok/s |
| ms/token range | 52–61 ms |
最大の出力は8,884 tokensで、PP 435 tok/s、TG 17.26 tok/sでした。Django の models.py を約8.5分かけて生成しました。
TG の安定性
53k/64k ctx のセッションで、TG は序盤から終盤に約2 tok/s低下しました。
- 序盤 10 リクエスト: 18.23–18.97 tok/s (平均 18.74)
- 終盤 10 リクエスト: 16.39–16.86 tok/s (平均 16.69)
KV cache と context の増加が原因の可能性があります。TG は16 tok/sを割りませんでした。
Prompt Processing (PP)
| Prompt Size | PP Range |
|---|---|
| < 100 tokens | 19–37 tok/s |
| 100–1,000 | 54–143 tok/s |
| 1,000–5,000 | 114–280 tok/s |
| 5,000–10,000 | 235–572 tok/s |
初回の20,956 tokens の PP は571.94 tok/sでした。短い prompt では overhead の割合が大きくなります。
Cache Miss 問題
ログには prefix cache miss が26回ありました。
  Common part does not match fully
cache : ...<|assistant|><think></think>...
prompt: ...<|assistant|></think>...
<think> の有無・位置が変わると prefix が一致せず、7k–10k tokens を再評価します。TTFT が1秒台から40秒台に増える主な原因と考えています。
| Prompt Tokens | TTFT (est.) |
|---|---|
| 23 | 1.05 s |
| 7,487 | 17.25 s |
| 9,247 | 39.28 s |
| 9,761 | 40.87 s |
GPU メトリクス
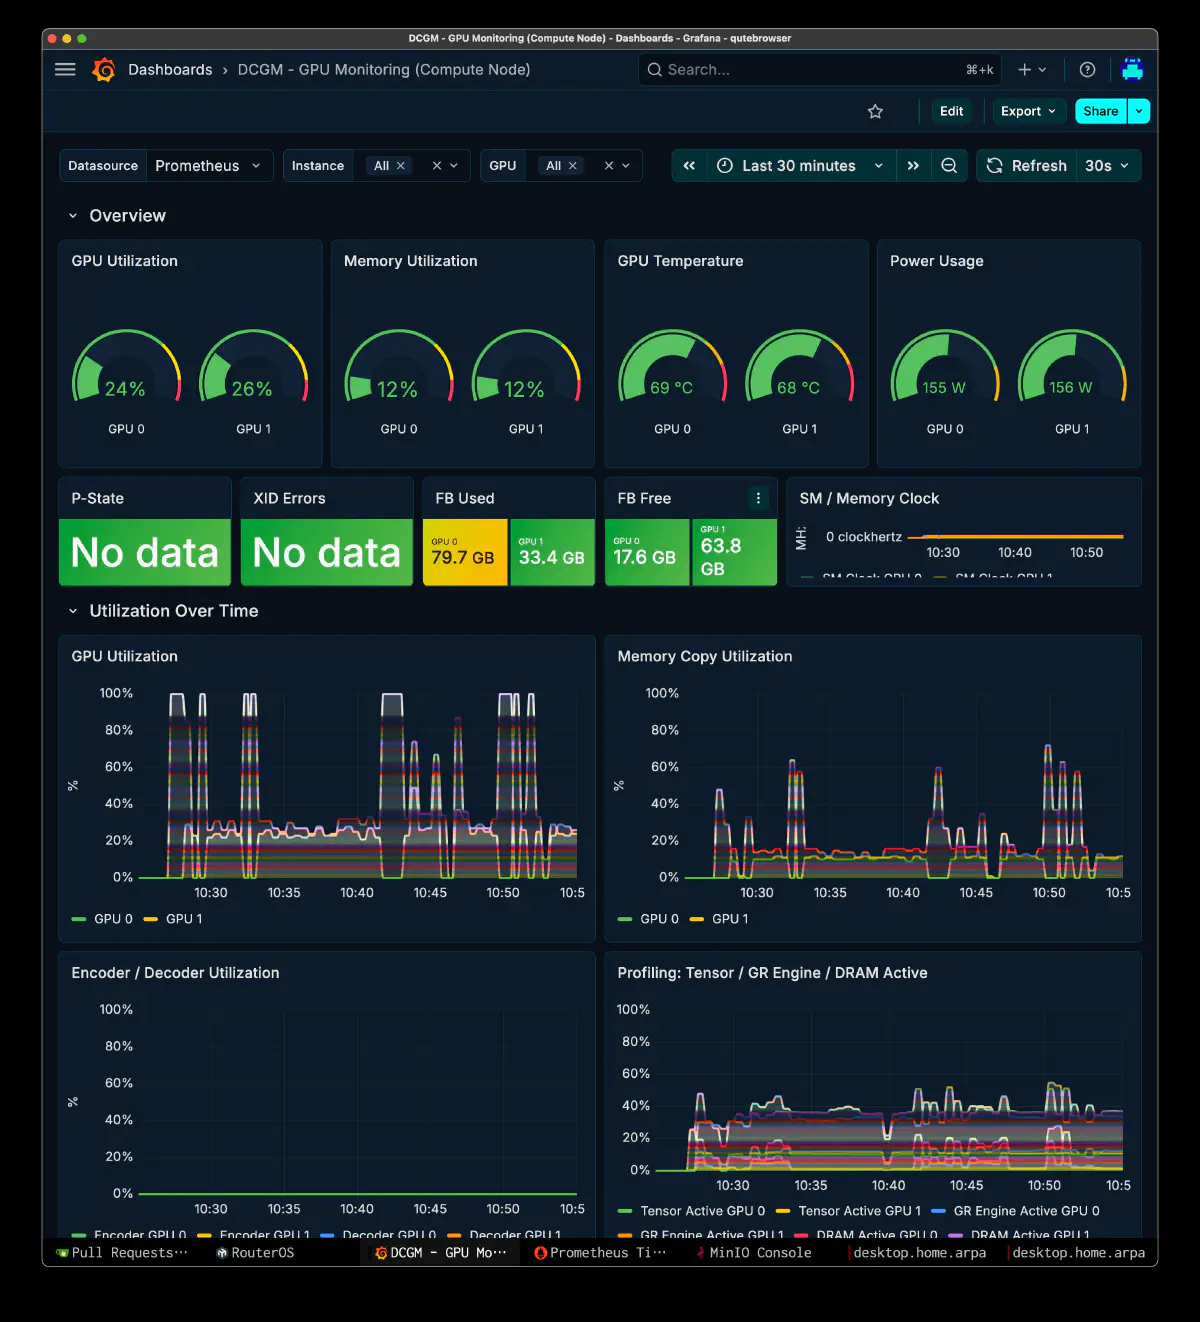
GPU utilization はリクエストごとに変動しました。hybrid では host expert の読み込みと GPU 計算が交互に進みます。
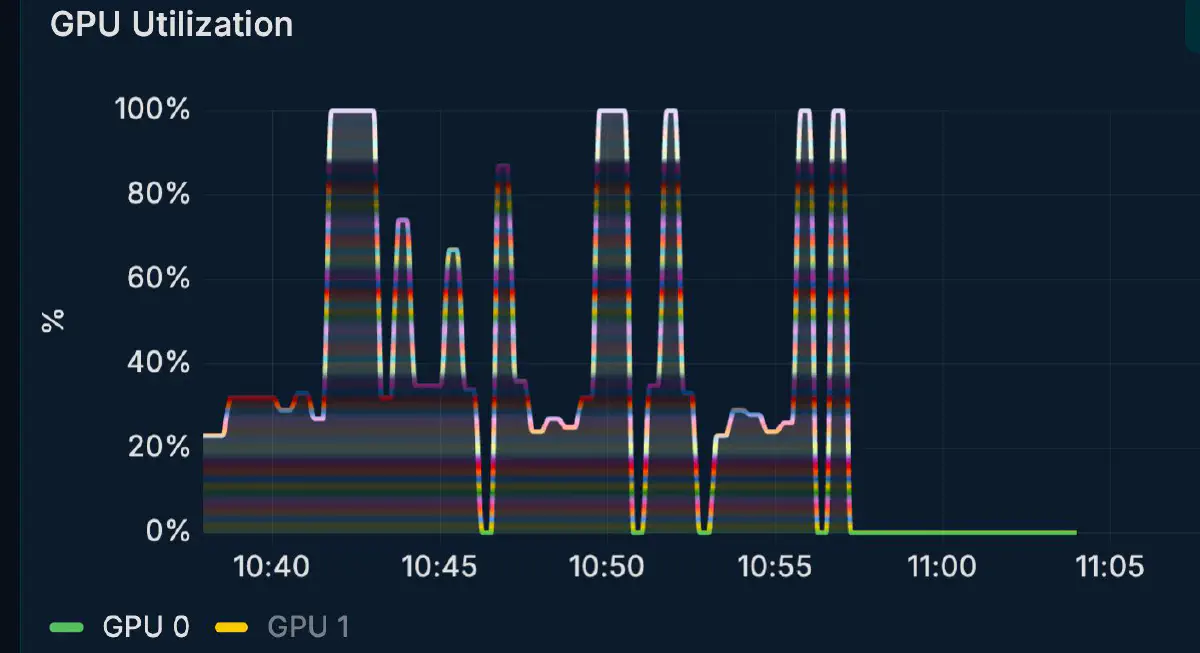
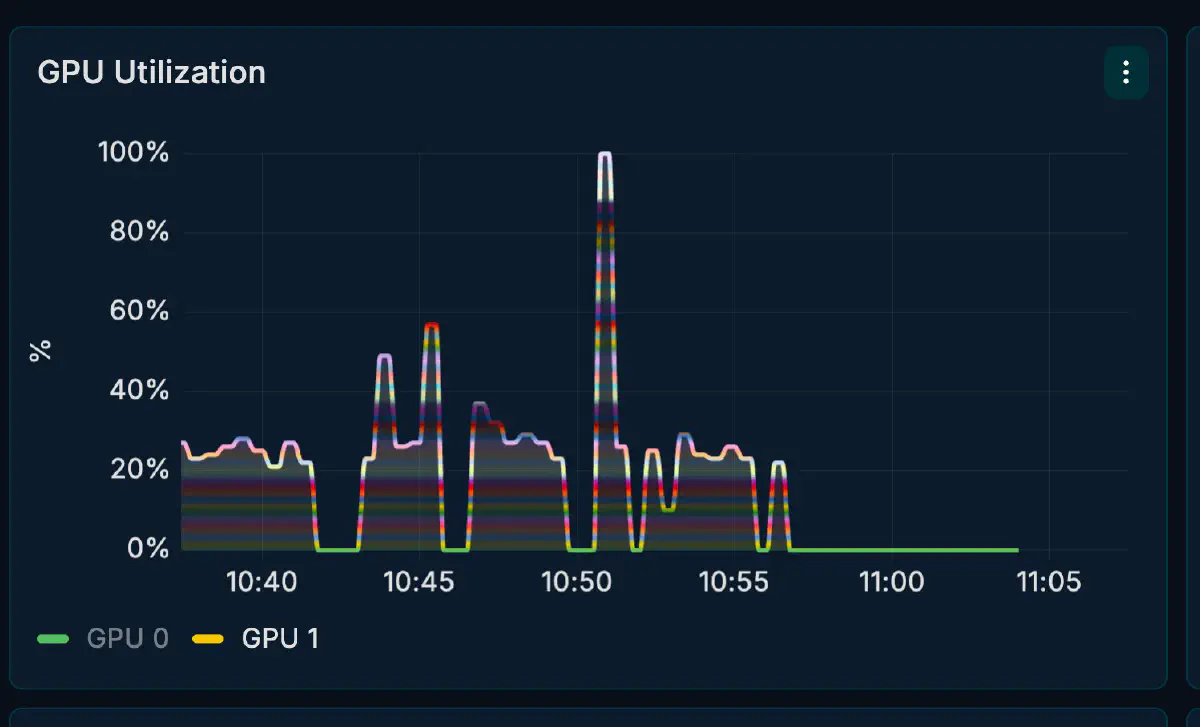
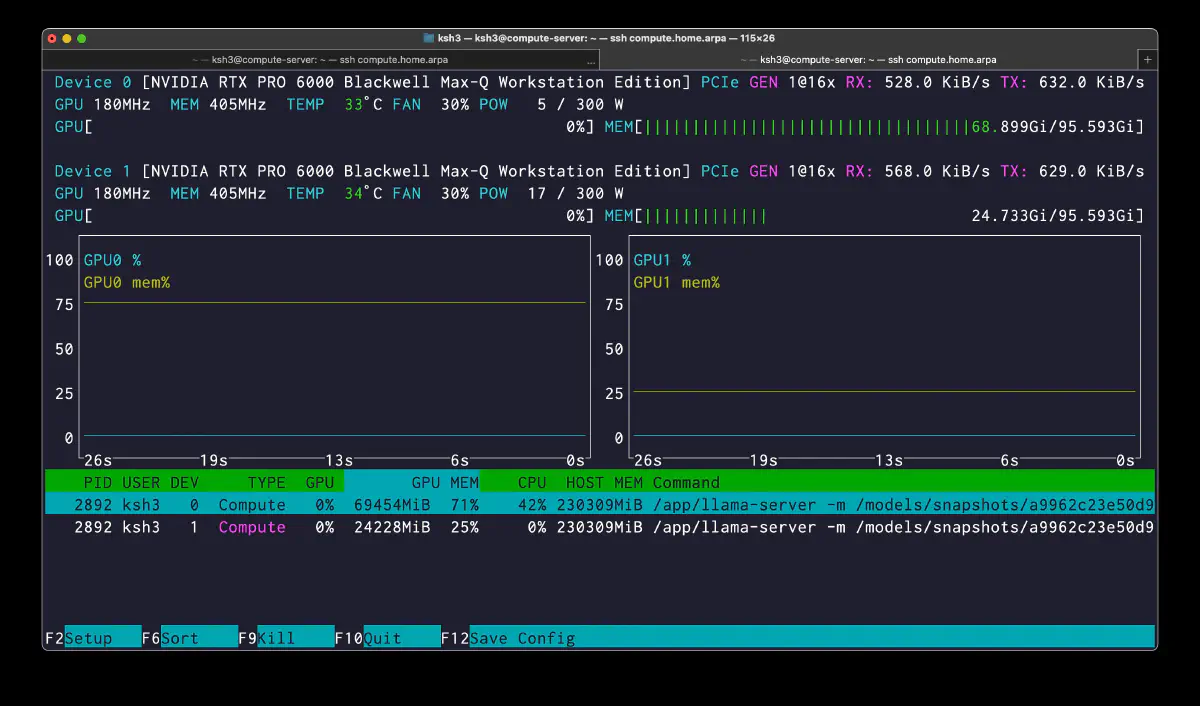
モデルバッファは CUDA0 が68.7 GiB、CUDA1 が23.5 GiBで、head 側の VRAM 使用量と利用率が高くなりました。CUDA1 には70 GiB以上の余裕があります。別モデルとの同居は今後の検証候補です。
CPU / Host Memory
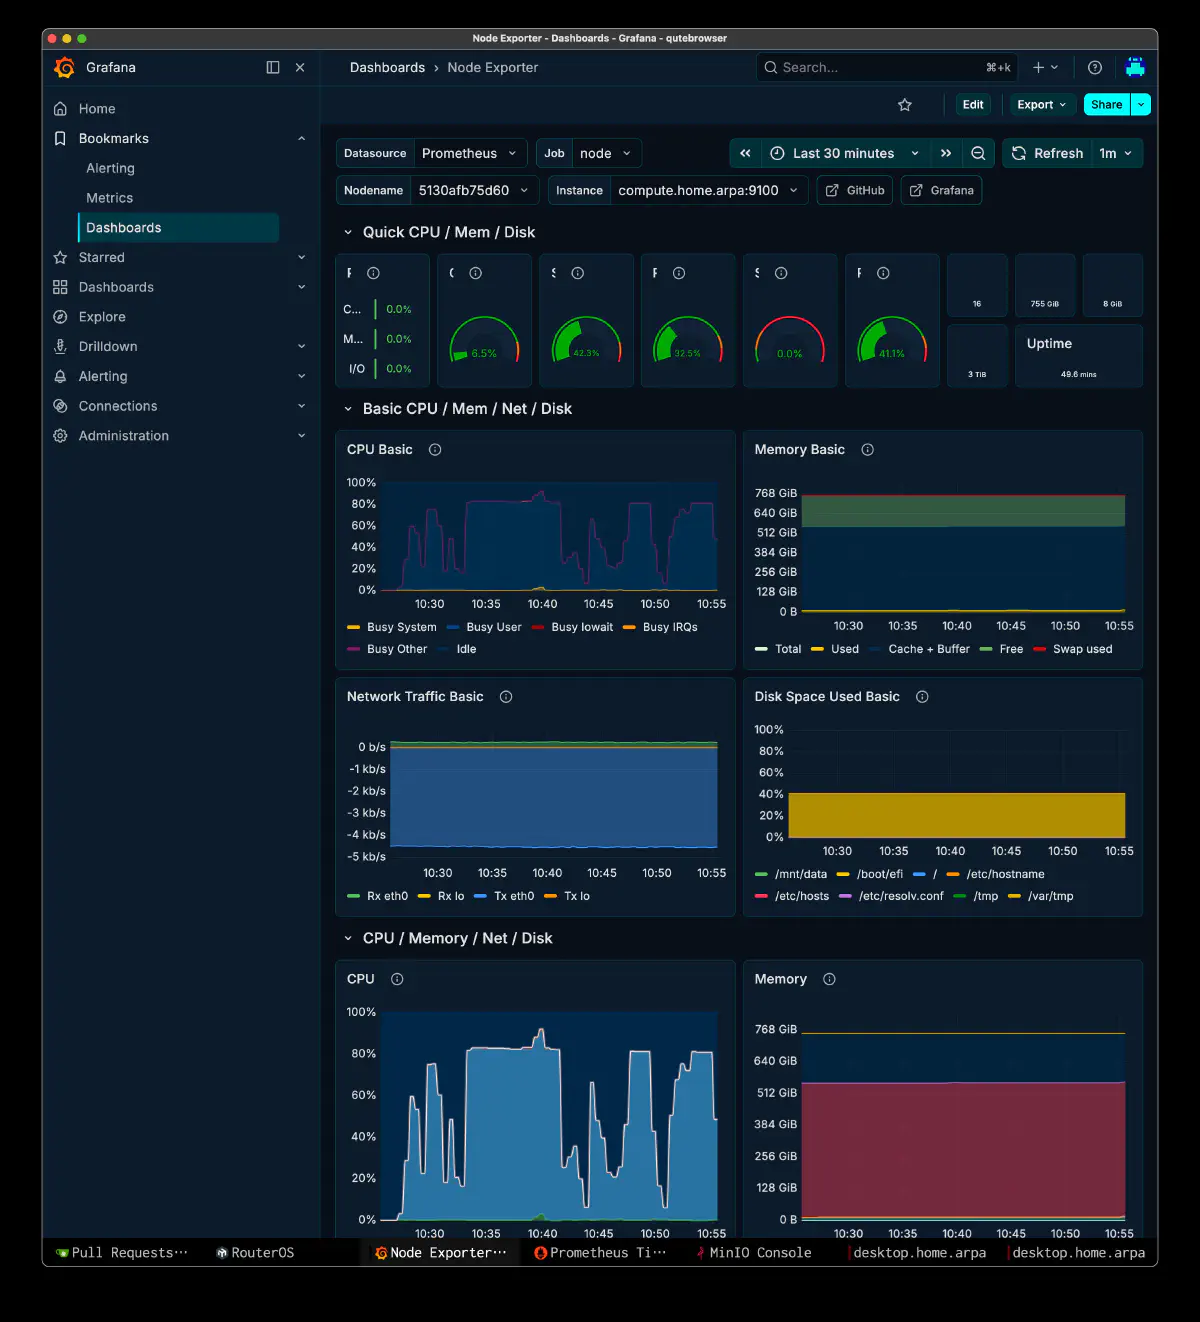
CPU は host expert tensor の供給と pinned memory の保持を担当します。利用率には DMA 転送と runtime の管理も含まれます。
4ノードの homelab で、compute.home.arpa は推論、storage.home.arpa は PostgreSQL / Prometheus / MinIO / Dagster / MLflow、desktop.home.arpa は Grafana を担当します。
Orchestrator 選定: GLM-5.1 vs Qwen3.5-397B
常駐 orchestrator(grandpa)候補は GLM-5.1(744B-A40B)と Qwen3.5-397B-A17B です。
grandpa はタスク分割、coder への委譲、出力評価、エラー回復を担当する想定です。2つの LLM バックエンドを調整し、状態と context を管理します。長文生成は coder に任せ、GPU は hot layer 用に dev01:25/25 GB程度を想定しています。
スペック比較
| GLM-5.1 | Qwen3.5-397B | |
|---|---|---|
| Total / Active params | 744B / 40B | 397B / 17B |
| Experts / Active | 256 / 8 | 512 / 10 |
| Quantization | IQ3_KS (3.65 bpw) | Q4_K_M mixed (4.93 bpw) |
| Model size | 320 GiB | 228 GiB |
| n_ctx_train | 202,752 | 262,144 |
| License | MIT | Apache-2.0 |
テスト構成の違い
2モデルの配置は異なるため、実測条件を分けて示します。
GLM-5.1: --cpu-moe + -ot で head 15 + tail 4層を GPU に置きました。19層で約76 GiB、CPU の56層で約224 GiB、ログの CUDA_Host は229,438 MiBです。orchestrator 専用ではなく coding bench 用の配置です。
Qwen3.5-397B(別セッション): --n-cpu-moe 15 で blk.0–blk.14 の15層の exps を CUDA_Host、blk.15–blk.59 の45層を GPU に置きました。full_attention_interval = 4 で attention は4層ごとに変わりますが、exps は全60層にあります。Layer sizes の Layer 3, 7, 11... にも3,839 MiBの exps が記録されています。非 exps(attention、SSM、dense、output)は graph split で GPU 2枚に分散し、CUDA_Split は176 GiBです。CUDA_Host は56,710 MiBで、15 × 3,712 = 55,680 MiBに近い値でした。
GLM は大半の expert、Qwen は先頭15層のみを CPU に置いています。どちらもフル CPU ではありません。orchestrator 用の比較には、両方の expert を CPU に置いた場合の VRAM を別に見積もります。
Expert 全 CPU 時の VRAM 要件
Layer sizes の非 exps に KV cache と compute buffer を加えた見積もりです。
| GLM-5.1 | Qwen3.5-397B | |
|---|---|---|
| Non-exps weight (attn+dense+output) | 6,518 MiB | 7,058 MiB |
| KV per 1k ctx (q8_0) | ~46 MiB | ~16 MiB |
| KV cache (ctx 65k, q8_0) | 2,984 MiB | ~1,040 MiB |
| KV cache (ctx 200k, q8_0, est.) | ~9,228 MiB | ~3,200 MiB |
| KV cache (ctx 262k, q8_0) | — | 4,080 MiB |
| Compute buffer | ~12 GiB | ~11 GiB |
| VRAM total (exps=CPU, ctx 65k) | ~22 GiB | ~19 GiB |
| VRAM total (exps=CPU, ctx 200k) | ~28 GiB | ~21 GiB |
| VRAM total (exps=CPU, ctx 262k) | — | ~22 GiB |
Qwen の KV は16 MiB/1k、GLM は46 MiB/1kです。GLM は MLA 相当の attention を持ちますが、head 数と dim が大きく、ctx 200kでは約7 GiB多く使う見積もりです。
CPU Pinned Host の差
| GLM-5.1 | Qwen3.5-397B | |
|---|---|---|
| Exps per layer | 4,088 MiB | 3,712 MiB (+一部 3,839 MiB) |
| Exps 保持層数 | 76 (blk.3–blk.78) | 60 (全層) |
| Total exps (全 CPU 時、理論値) | ~303 GiB | ~218 GiB |
| 本テストでの CPU pinned | 229 GiB (56 層) | 55 GiB (15 層) |
| Pinned alloc time (test) | 40s | 9s |
推論速度の比較
| GLM-5.1 | Qwen3.5-397B | |
|---|---|---|
| TG (序盤) | 18–19 t/s | 55–59 t/s |
| TG (終盤、ctx 充填時) | 16–17 t/s | 17–18 t/s |
| PP max | 572 t/s | 1,500 t/s |
| Cache restore | N/A | 14–18 ms (checkpoint) |
| Cache miss | <think> タグ不整合で頻発 | checkpoint restore で安定 |
長い session では、TG は両方17–18 t/sに近づきました。orchestrator は短い委譲やルーティングを返すため、判断の品質も比較する必要があります。
Qwen の PP は約3倍速く、cache miss 後の再評価時間を減らせます。GLM の <think> 由来の miss は、thinking off で改善する可能性がありますが、未検証です。
判断品質に残る検証
Qwen は PP、CPU pinned 容量、ctx 262k、cache の安定性で有利でした。一方、orchestrator のタスク分割、状態管理、ctx 管理の品質は、速度だけでは判断できません。
GLM は active 40B、Qwen は active 17Bです。GLM の判断力に期待していますが、parameter 数だけで品質は決められません。常駐する運用では、実際の委譲と回復を観測する必要があります。記事時点では Qwen が運用しやすいという感触です。
RAGと長いcontextの運用案
n_ctx_train は GLM 202k、Qwen 262kです。最大の70%を実効上限と仮定すると、約141k / 183kになります。次の2つの使い方を検討しています。
GLM-5.1 + RAG shaping (ctx ~64k 運用):
Gitea のコードを ColBERT + maxsim reranker で索引化し、argus(Gitea symbol DB)と voracle(Obsidian vault semantic search)の MCP tool から必要な情報を取得する方針です。ctx 64kなら KV は約3 GiBに収まり、TTFT と TG の劣化を抑えられると見積もっています。
unified memory の Mac Studio でも、ctx を絞った運用は候補です。動作は未確認です。
Qwen3.5 + power play (ctx ~183k):
会話、tool 結果、コードを ctx に入れる方針です。active 17Bで適切に情報を選べるかは未確認です。KV 容量上は YaRN で1M ctxに伸ばす余地がありますが、品質維持は別に検証が必要です。
選定の方向性
記事時点では Qwen3.5-397B-A17B を grandpa に使う方向 で検討しています。GLM の active 40Bにも期待がありますが、常駐と他モデルとの同居では Qwen の構成が適していると考えています。
- ctx 262kとKV容量: 16 MiB/1kで、長い入力や画像を含む処理の候補になります
- PP 1,500 t/s: cache miss後の再評価は GLM-5.1 の3倍の速度です。system prompt や messages[] を頻繁に変える orchestrator では、再評価の時間に影響します
- ライセンスと学習費用: MIT / Apache-2.0で、SFT/DPO/LoRA の反復学習の候補です。GLM-5.1 は規模による費用負担が大きく、Qwen3.5-397B-A17B の方を試行可能な候補と考えています
開発で確認する点
開発開始から約2か月、平日は週2日ほどと週末に、claude / codex と MCP ツールを開発しています。主な検討項目は、小さく必要な情報をまとめた ctx と、その投入時期、モデル間の協調です。
残る検証
head 側の GPU 配置が hit に有利という仮説はありますが、未検証です。GLM の active 40Bを RAG と小さい ctx で使う構成も候補に残しています。
次は委譲成功率、リカバリ回数、セッション長を計測します。Qwen の cache checkpoint restore を含め、常駐に適するかを確認しながらデータ収集とツール調整を進める予定です。