
GLM-5.1のexpert配置と生成速度
GLM-5.1 IQ3_KSのCPU/GPU配置を測り、21.75 t/sまで改善した記録です。AIシステム開発の並列エージェント基盤として、Qwen3-Coder-NextとのVRAM配分と未検証の常駐案を整理しました。
familiarのorchestratorとして使うGLM-5.1 IQ3_KSのexpert配置と生成速度を測りました。Qwen3-Coder-Nextのworkerと同じGPUに常駐させる構成は計画段階です。grandpaが計画、レビュー、収束を判断するため、その生成速度もターンの所要時間に影響します。AIシステム開発の並列エージェントに向け、VRAMの配分を検討します。
全expertを--cpu-moeでCPUに置くと、GPUを2枚にしてもほぼ速くなりませんでした。-otでhead 12層とtail 10層を2GPUに置くと、53.09ms/token -> 45.98ms/token、18.84 t/s -> 21.75 t/sへ改善しました。実運用ではQwen3-Coder-Next Q4_0 --parallel 2のworker 2本とVRAMを分ける必要があります。
測定結果と常駐構成
結果の要点です。
| 論点 | 確定した判断 |
|---|---|
| CPU ボトルネック | expert FFN の CPU 評価が 45-50ms/token 程度で全体の 85-90% を占める |
| 2GPU の意味 | cpu-moe 全載せでは 2GPU は 1GPU と同等で、53.09 vs 53.03 ms/token と差が出ない |
| 改善の本体 | n-cpu-moe 64 で +5.7%、-ot head12+tail10 で +15.3% |
| Hot layer | tail 14 層だけより head+tail 22 層の方が効き方が大きく、head 側が明らかに hot |
| ctx 耐性 | TG は 61t: 53ms から 4096t: 54-55ms 程度で、長出力でもほぼ崩れない |
-ger | CPU expert 処理を 1-2% 改善し、L3 locality 改善の方向に効いている |
-sm graph | GLM-DSA では非対応で layer にフォールバックする |
| thinking | orchestrator 用途では不要。61 tokens の本回答に 294 tokens の思考を足すと 4.6s -> 19.1s に悪化する |
単独の最速はhead+tailの22層でした。workerも常駐させる案では、Qwen3-Coder-Nextの品質と処理量を優先し、GLMのGPU expertを20層前後にする方針です。
測定から確認したこと
CPU が支配的
- expert FFN の CPU 評価が
45-50ms/tokenで全体の大半を占める - cpu-moe 全載せ時の GPU utilization は
17-19%程度 - PCIe 転送は支配項ではない。activation はおおよそ
12KB/層で、79 層合計でも転送時間は19μs級にしかならない - 2GPU layer-split は cpu-moe 全載せではほぼ意味がなく、1GPU と 2GPU で TG は等価だった
GPUはCPUのexpert評価を待っていると考えられます。
Expert 配置による TG 改善
| 構成 | GPU expert層 | ms/token | TG (t/s) | 改善 |
|---|---|---|---|---|
| cpu-moe 全載せ (expert 0) | 0 | 53.0 | 18.8 | baseline |
| n-cpu-moe 64 | 14 | 50.2 | 19.9 | +5.7% |
-ot head12+tail10 | 22 | 46.0 | 21.8 | +15.3% |
head配置の改善幅
- tail 14 層だけを GPU に載せた時の改善は
+5.7% - head 12 層 + tail 10 層の 22 層構成では
+15.3% - GPU に載せた層数は
1.57xなのに改善幅は2.5x近く、head 側の activation 密度が高いと見るのが自然
高 ctx 耐性
61tの短い出力でも4096tの長い出力でも TG はほぼ一定MLAにより32k ctx時の KV cache は約1.5GBに収まる- ボトルネックが CPU expert 側なので、ctx 増加の影響が二重に小さい
-ger の効果
50.55 -> 50.16 ms/tokenと小さいが一貫した改善- expert routing のグループ化が
EPYC 9175Fの巨大 L3 cache にやや有利に働いている可能性が高い
-sm graph は GLM-DSA 非対応
- 明示的に指定しても自動で
layerにフォールバックする - このモデルで最適化対象にすべきは split mode ではなく expert の物理配置だった
Thinkingによる所要時間の増加
61 tokensの出力に対し294 tokensの思考を挟むと、所要時間は4.6sから19.1sまで膨らんだ--reasoning-budget 0またはchat_template_kwargs.enable_thinking=falseを前提にした方がよい
背景
ロールの分担です。
| Role | 用途 | モデル |
|---|---|---|
| grandpa | orchestrator のレビュー、判定、契約整合性確認 | GLM-5.1 IQ3_KS |
| naughty-worker | 実コード生成、修正、ファイル出力 | Qwen3-Coder-Next |
workerはコード品質、grandpaは十分な品質と低い生成時間を優先します。両方を載せるため、まずGLM-5.1のexpert配置を測りました。
ハードウェア構成
  GPU:  NVIDIA RTX PRO 6000 Blackwell Max-Q 96GB × 2
CPU:  AMD EPYC 9175F (16コア)
RAM:  768GB DDR5 6400MT/s
今回は2GPUの帯域より容量が重要です。expertをGPUへ戻すと、1枚では収まらない構成が出ます。
GLM-5.1 モデル概要
起動ログのモデル情報です。
  llm_load_print_meta: arch                 = glm-dsa
llm_load_print_meta: model type           = 744B.A40B
llm_load_print_meta: model ftype          = IQ3_KS - 3.1875 bpw
llm_load_print_meta: model params         = 753.864 B
llm_load_print_meta: model size           = 320.216 GiB (3.649 BPW)
llm_load_print_meta: n_layer              = 79
llm_load_print_meta: n_expert             = 256
llm_load_print_meta: n_expert_used        = 8
llm_load_print_meta: n_layer_dense_lead   = 3
内部の層構成です。
layer 0-2: denselayer 3-77: MoElayer 78: nextn predictionlayer 79: output
MoEは75層あり、重みは次のサイズでした。
  gate_exps = 1225 MiB
down_exps = 1638 MiB
up_exps   = 1225 MiB
1層のexpertは約4.1GB、合計は約307GBです。CUDA_Hostのpinned memoryに置くとRAM消費が増えます。GPU側はnon-expert約14.5GB、KV約1.5GB、compute buffer約5.4GBです。
ベースコマンド
ik_llama.cppの起動コマンドです。
  podman run --rm \
  --device nvidia.com/gpu=1 \
  -p 8000:8000 \
  --cap-add=SYS_NICE \
  -v /mnt/data/models/models--ubergarm--GLM-5.1-GGUF:/models:ro,Z \
  registry.home.arpa/ik_llama.cpp:latest \
  -m /models/snapshots/.../IQ3_KS/GLM-5.1-IQ3_KS-00001-of-00008.gguf \
  --merge-qkv --ctx-size 32768 -ctk q8_0 -ctv q8_0 \
  --parallel 1 --threads 15 --threads-batch 24 \
  -b 8192 -ub 8192 -ngl 999 \
  --cpu-moe -muge -mla 3 -amb 512 \
  --jinja --host 0.0.0.0 --port 8000 \
  --warmup-batch --alias GLM-5.1
主要オプションの意味:
--cpu-moe: 全 MoE expert 重みを CPU 側の pinned memory に配置-muge:ffn_upとgate_expsのマージ-mla 3: Multi-Latent Attention 最適化レベル 3-amb 512: attention max batch size-ctk q8_0 -ctv q8_0: KV cache の量子化
テスト方法
TG比較には2本のリクエストを使いました。
- 短い JSON 生成
- 長い OpenAPI spec 生成
短いJSONはレビューとcontract判定、長いOpenAPI specは長出力の安定性を見る課題です。thinkingあり・なしで、timings.predicted_ms / predicted_nとllama.cppのeval timeを比較しました。
  # 短い出力テスト
curl -s -w "\n\nTotal time: %{time_total}s\n" \
 http://compute.home.arpa:8000/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
"model": "GLM-5.1",
"messages": [
{"role": "user", "content": "Write a JSON object with 5 fields describing a software project. Include name, language, version, description, and license."}
],
"max_tokens": 256,
"temperature": 0.7,
"top_p": 0.95,
"top_k": 45,
"min_p": 0.01,
"chat_template_kwargs": {"enable_thinking": false}
}'
  # 長い出力テスト
curl -s -w "\n\nTotal time: %{time_total}s\n" \
 http://compute.home.arpa:8000/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
"model": "GLM-5.1",
"messages": [
{"role": "user", "content": "Write a detailed OpenAPI 3.0 specification in JSON for a task management API. Include endpoints for CRUD operations on projects and tasks, with request/response schemas, error responses, and authentication via Bearer token."}
],
"max_tokens": 2048,
"temperature": 0.7,
"top_p": 0.95,
"top_k": 45,
"min_p": 0.01,
"chat_template_kwargs": {"enable_thinking": false}
}'
CPUが律速する根拠
expert評価時間とCPU/GPUの使用率から確認しました。
expert 計算がほぼ全て
- baseline の TG は
53ms/token - そのうち
45-50ms/tokenが CPU 上の expert 評価コスト - GPU 側の non-expert、KV、compute はその残差しかない
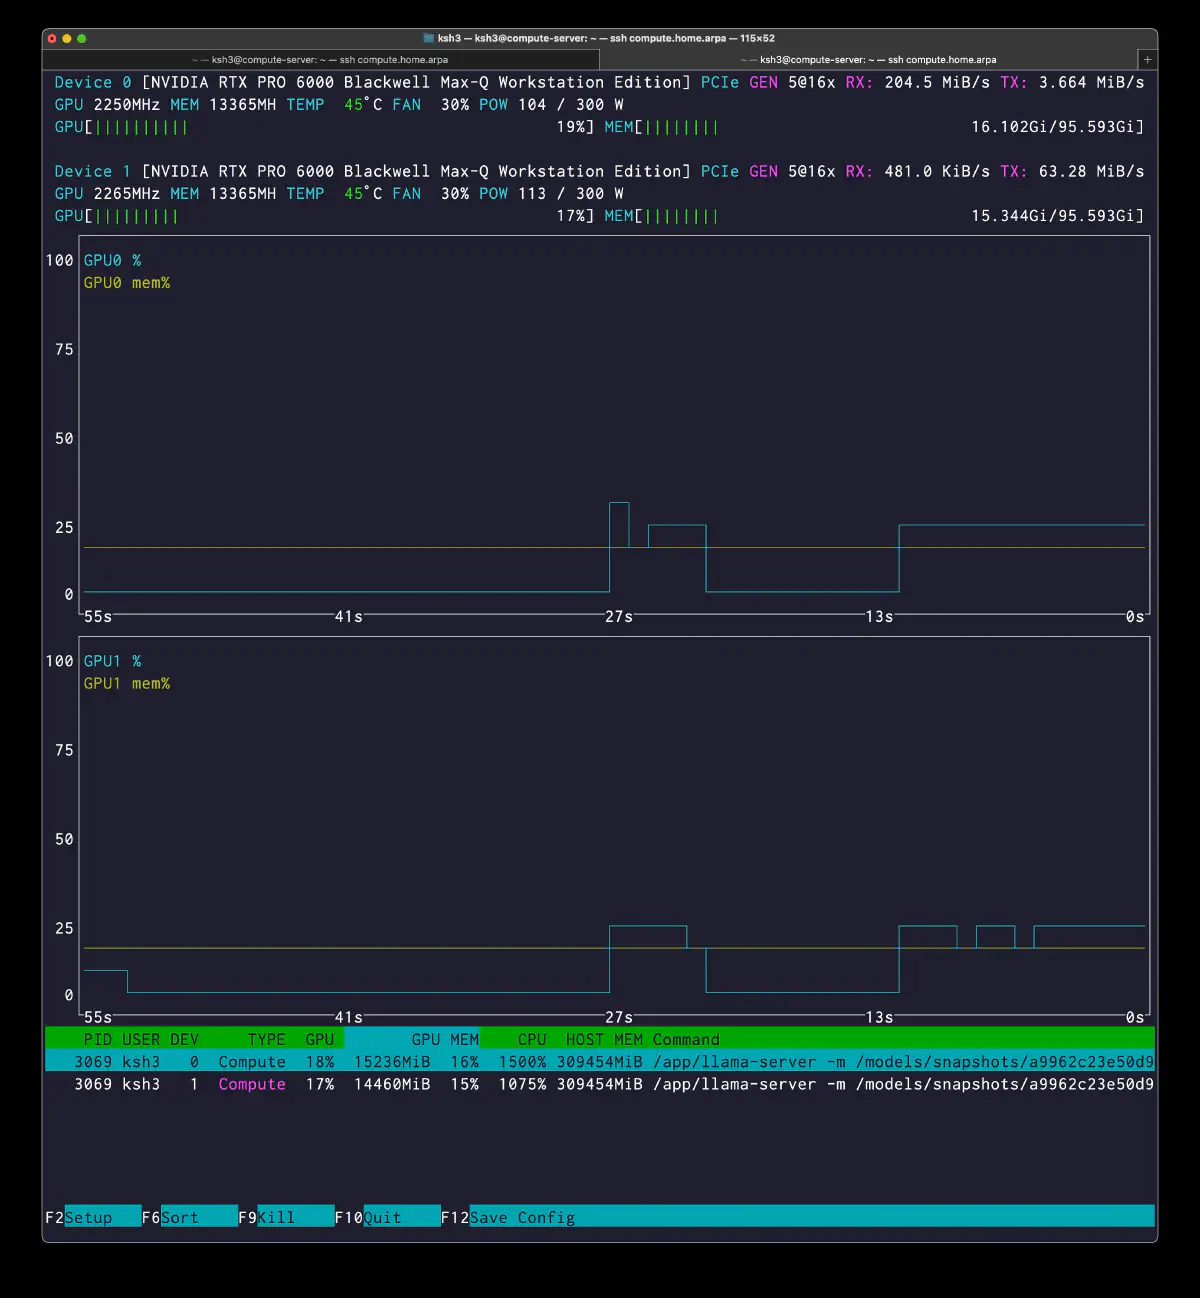
GPUは17-19%、CPUは1500%まで上がり、時間の内訳とも一致します。
PCIe転送の見積もり
activation転送量から計算します。
- activation は約
12KB/層 - 全
79層を跨いでも転送量はごく小さい - 転送時間の見積もりは
19μs級
見積もりの転送時間はTG 53msより小さく、CPUでのexpert評価が支配的でした。
出力長を変えた結果
61、2048、4096 tokenでもTGはほぼ一定でした。MLAで32k ctxのKVは約1.5GBに収まり、CPU expertが先に律速します。denseやGPUのみのモデルとは異なる条件です。
構成1: hybrid -ot exps=CPU, 2GPU layer-split
全expertを-ot exps=CPUでCPUへ置いた最初の測定です。
  podman run --rm \
  --device nvidia.com/gpu=all \
  -p 8000:8000 \
  --cap-add=SYS_NICE \
  -v /mnt/data/models/models--ubergarm--GLM-5.1-GGUF:/models:ro,Z \
  registry.home.arpa/ik_llama.cpp:latest \
  -m /models/snapshots/a9962c23e50d9c352e09fe0d9cb131026f4e6441/IQ3_KS/GLM-5.1-IQ3_KS-00001-of-00008.gguf \
  --merge-qkv --ctx-size 32768 -ctk q8_0 -ctv q8_0 --parallel 1 --threads 15 --threads-batch 24 -b 8192 -ub 8192 -ngl 99 -ot exps=CPU -muge -mla 3 -amb 512 -sm graph --jinja --host 0.0.0.0 --port 8000 --warmup-batch --alias GLM-5.1
起動時の設定です。
  Split mode 'graph' is not supported for this model
  => changing split mode to 'layer'

llm_load_tensors:  CUDA_Host buffer size = 307110.47 MiB
llm_load_tensors:      CUDA0 buffer size =  7378.05 MiB
llm_load_tensors:      CUDA1 buffer size =  7120.90 MiB

llama_init_from_model: grouped er    = 0
llama_init_from_model: graph splits = 190
TGのベースラインです。
  # 短い出力 thinking無し
prompt eval time =    1323.95 ms /    30 tokens (   44.13 ms per token,    22.66 tokens per second)
       eval time =    3238.59 ms /    61 tokens (   53.09 ms per token,    18.84 tokens per second)

# 長い出力 thinking無し
prompt eval time =    1831.66 ms /    43 tokens (   42.60 ms per token,    23.48 tokens per second)
       eval time =  111609.04 ms /  2048 tokens (   54.50 ms per token,    18.35 tokens per second)

# 長い出力 thinking有り
prompt eval time =    2459.53 ms /    43 tokens (   57.20 ms per token,    17.48 tokens per second)
       eval time =  226282.06 ms /  4096 tokens (   55.24 ms per token,    18.10 tokens per second)
nvtopの状態です。
  PID USER DEV     TYPE  GPU        GPU MEM    CPU  HOST MEM
3069 ksh3   0  Compute  19%  15236MiB  16%  1500% 309454MiB
3069 ksh3   1  Compute  17%  14460MiB  15%  1075% 309454MiB
構成2: hybrid --cpu-moe, 2GPU
同じ2GPUで--cpu-moeへ変え、-ot exps=CPUと比較しました。
  podman run --rm \
  --device nvidia.com/gpu=all \
  -p 8000:8000 \
  --cap-add=SYS_NICE \
  -v /mnt/data/models/models--ubergarm--GLM-5.1-GGUF:/models:ro,Z \
  registry.home.arpa/ik_llama.cpp:latest \
  -m /models/snapshots/a9962c23e50d9c352e09fe0d9cb131026f4e6441/IQ3_KS/GLM-5.1-IQ3_KS-00001-of-00008.gguf \
  --merge-qkv --ctx-size 32768 -ctk q8_0 -ctv q8_0 --parallel 1 --threads 15 --threads-batch 24 -b 8192 -ub 8192 -ngl 99 --cpu-moe -muge -mla 3 -amb 512 -sm graph --jinja --host 0.0.0.0 --port 8000 --warmup-batch --alias GLM-5.1 --temp 0.7 --top-k 45 --top-p 0.95 --min-p 0.01
値は同じでした。
  Split mode 'graph' is not supported for this model
  => changing split mode to 'layer'

llm_load_tensors:  CUDA_Host buffer size = 307110.47 MiB
llm_load_tensors:      CUDA0 buffer size =  7378.05 MiB
llm_load_tensors:      CUDA1 buffer size =  7120.90 MiB

llama_init_from_model: graph splits = 190
PP/TGも構成1と一致しました。
  # 短い出力 thinking無し
prompt eval time =    1323.95 ms /    30 tokens (   44.13 ms per token,    22.66 tokens per second)
       eval time =    3238.59 ms /    61 tokens (   53.09 ms per token,    18.84 tokens per second)

# 長い出力 thinking無し
prompt eval time =    1831.66 ms /    43 tokens (   42.60 ms per token,    23.48 tokens per second)
       eval time =  111609.04 ms /  2048 tokens (   54.50 ms per token,    18.35 tokens per second)
このモデルとbuildでは、-ot exps=CPUと--cpu-moeの配置と性能は同じです。以下ではcpu-moe全載せと呼びます。
構成3: hybrid --cpu-moe, 1GPU
layer-splitの影響を見るため、dev1の1GPUでも測りました。
  podman run --rm \
  --device nvidia.com/gpu=1 \
  -p 8000:8000 \
  --cap-add=SYS_NICE \
  -v /mnt/data/models/models--ubergarm--GLM-5.1-GGUF:/models:ro,Z \
  registry.home.arpa/ik_llama.cpp:latest \
  -m /models/snapshots/a9962c23e50d9c352e09fe0d9cb131026f4e6441/IQ3_KS/GLM-5.1-IQ3_KS-00001-of-00008.gguf \
  --merge-qkv --ctx-size 32768 -ctk q8_0 -ctv q8_0 --parallel 1 --threads 15 --threads-batch 24 -b 8192 -ub 8192 -ngl 999 --cpu-moe -muge -mla 3 -amb 512 --jinja --host 0.0.0.0 --port 8000 --warmup-batch --alias GLM-5.1 --temp 0.7 --top-k 45 --top-p 0.95 --min-p 0.01
1GPUの起動値です。
  llm_load_tensors:  CUDA_Host buffer size = 307110.47 MiB
llm_load_tensors:      CUDA0 buffer size = 14498.95 MiB

llama_kv_cache_init:      CUDA0 KV buffer size = 1491.79 MiB
llama_init_from_model:    CUDA0 compute buffer size = 5418.03 MiB
llama_init_from_model: graph splits = 152

Allocating 299.91 GiB of pinned host memory
done allocating 299.91 GiB in 46485.7 ms
性能差は小さい結果でした。
  # 短い出力 thinking無し
prompt eval time =    1297.67 ms /    30 tokens (   43.26 ms per token,    23.12 tokens per second)
       eval time =    3340.94 ms /    63 tokens (   53.03 ms per token,    18.86 tokens per second)

# 長い出力 thinking無し
prompt eval time =    1823.10 ms /    43 tokens (   42.40 ms per token,    23.59 tokens per second)
       eval time =  110967.85 ms /  2048 tokens (   54.18 ms per token,    18.46 tokens per second)

# 長い出力 thinking有り
prompt eval time =    1696.37 ms /    43 tokens (   39.45 ms per token,    25.35 tokens per second)
       eval time =  222410.35 ms /  4096 tokens (   54.30 ms per token,    18.42 tokens per second)
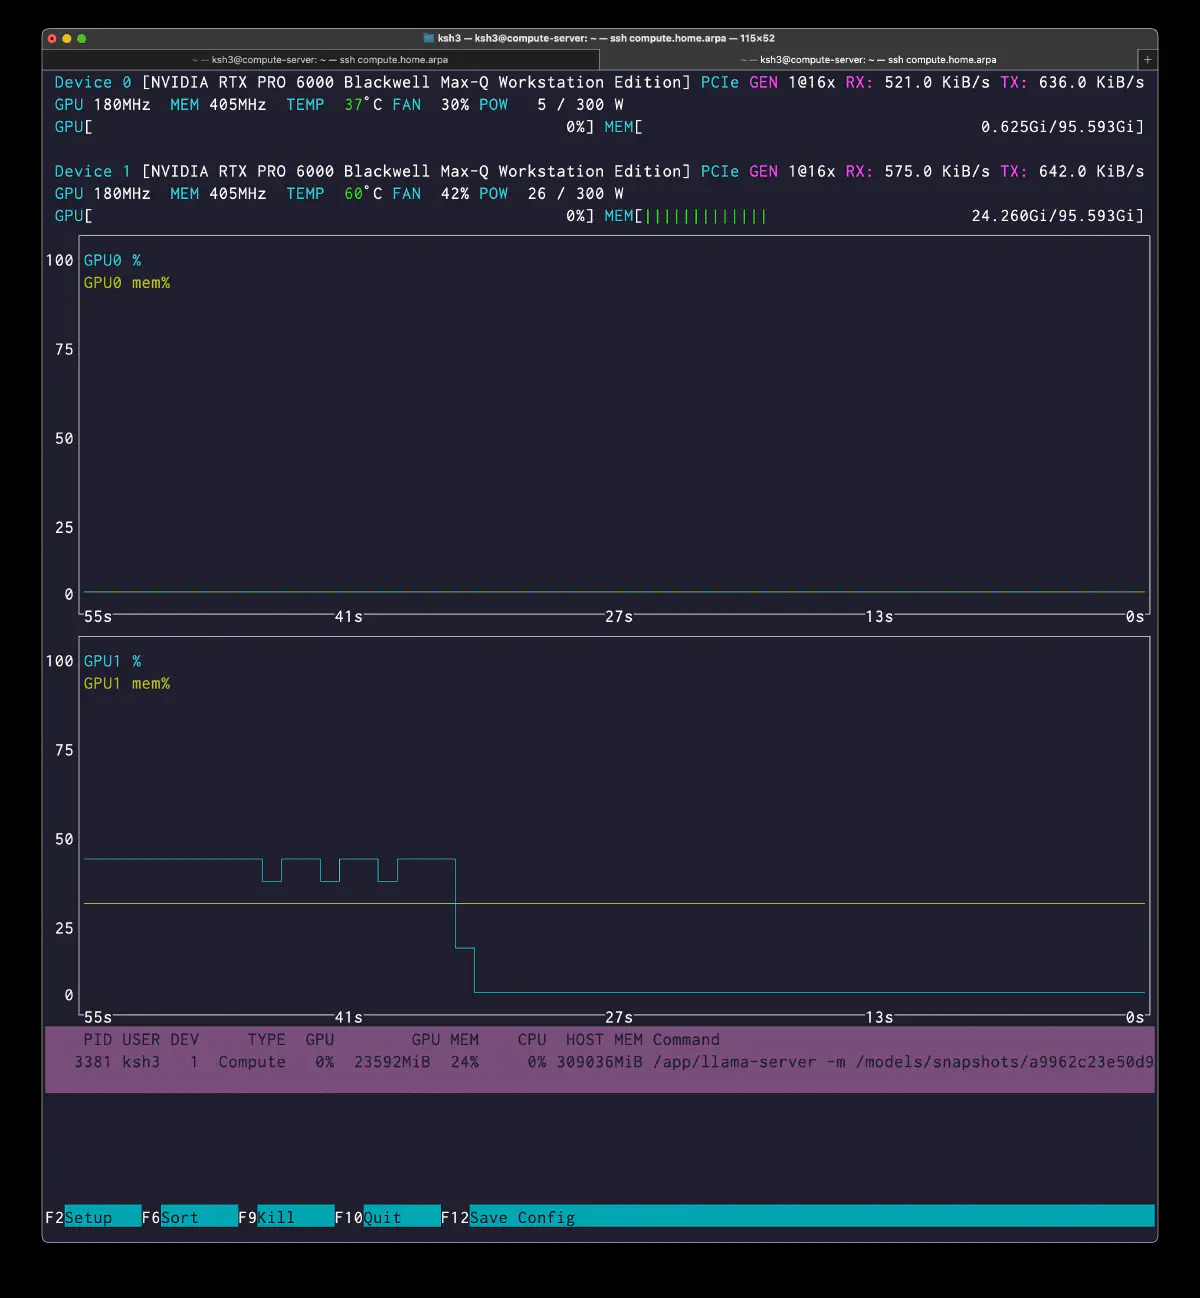
  PID USER DEV     TYPE  GPU        GPU MEM    CPU  HOST MEM
3381 ksh3   1  Compute   0%  23592MiB  24%     0% 309036MiB
確認した2点です。
graph splitsは190 -> 152に減っており、構造的には 1GPU の方が単純- それでも TG はほぼ据え置きで、CPU expert が律速である事実は変わらない
1GPUでもTGはほぼ変わらず、dev0をworker用に空けられます。
構成4: hybrid --n-cpu-moe 64, 1GPU, -ger
--n-cpu-moe 64で、前半をCPU、後半をGPUへ置きます。
  podman run --rm \
  --device nvidia.com/gpu=1 \
  -p 8000:8000 \
  --cap-add=SYS_NICE \
  -v /mnt/data/models/models--ubergarm--GLM-5.1-GGUF:/models:ro,Z \
  registry.home.arpa/ik_llama.cpp:latest \
  -m /models/snapshots/a9962c23e50d9c352e09fe0d9cb131026f4e6441/IQ3_KS/GLM-5.1-IQ3_KS-00001-of-00008.gguf \
  --merge-qkv --ctx-size 32768 -ctk q8_0 -ctv q8_0 --parallel 1 --threads 15 --threads-batch 24 -b 8192 -ub 8192 -ngl 999 --n-cpu-moe 64 -muge -mla 3 -amb 512 --jinja --host 0.0.0.0 --port 8000 --warmup-batch -ger --alias GLM-5.1 --temp 0.7 --top-k 45 --top-p 0.95 --min-p 0.01
配置は次のとおりです。
blk.3-63: CPU 側blk.64-77: GPU 側- 実質的に tail 14 層だけ GPU に戻した構成
Allocating 244.02 GiB of pinned host memory
TGが改善しました。
  # 短い出力 thinking無し
prompt eval time =    1173.39 ms /    30 tokens (   39.11 ms per token,    25.57 tokens per second)
       eval time =    3109.75 ms /    62 tokens (   50.16 ms per token,    19.94 tokens per second)

# 長い出力 thinking無し
prompt eval time =    1690.07 ms /    43 tokens (   39.30 ms per token,    25.44 tokens per second)
       eval time =  103526.50 ms /  2048 tokens (   50.55 ms per token,    19.78 tokens per second)

# 長い出力 thinking有り
prompt eval time =    1664.97 ms /    43 tokens (   38.72 ms per token,    25.83 tokens per second)
       eval time =  207284.39 ms /  4096 tokens (   50.61 ms per token,    19.76 tokens per second)
nvtopでも使用率とVRAMが増えています。
  PID USER DEV     TYPE  GPU        GPU MEM    CPU  HOST MEM
4153 ksh3   1  Compute  41%  80804MiB  83%  1432% 251746MiB
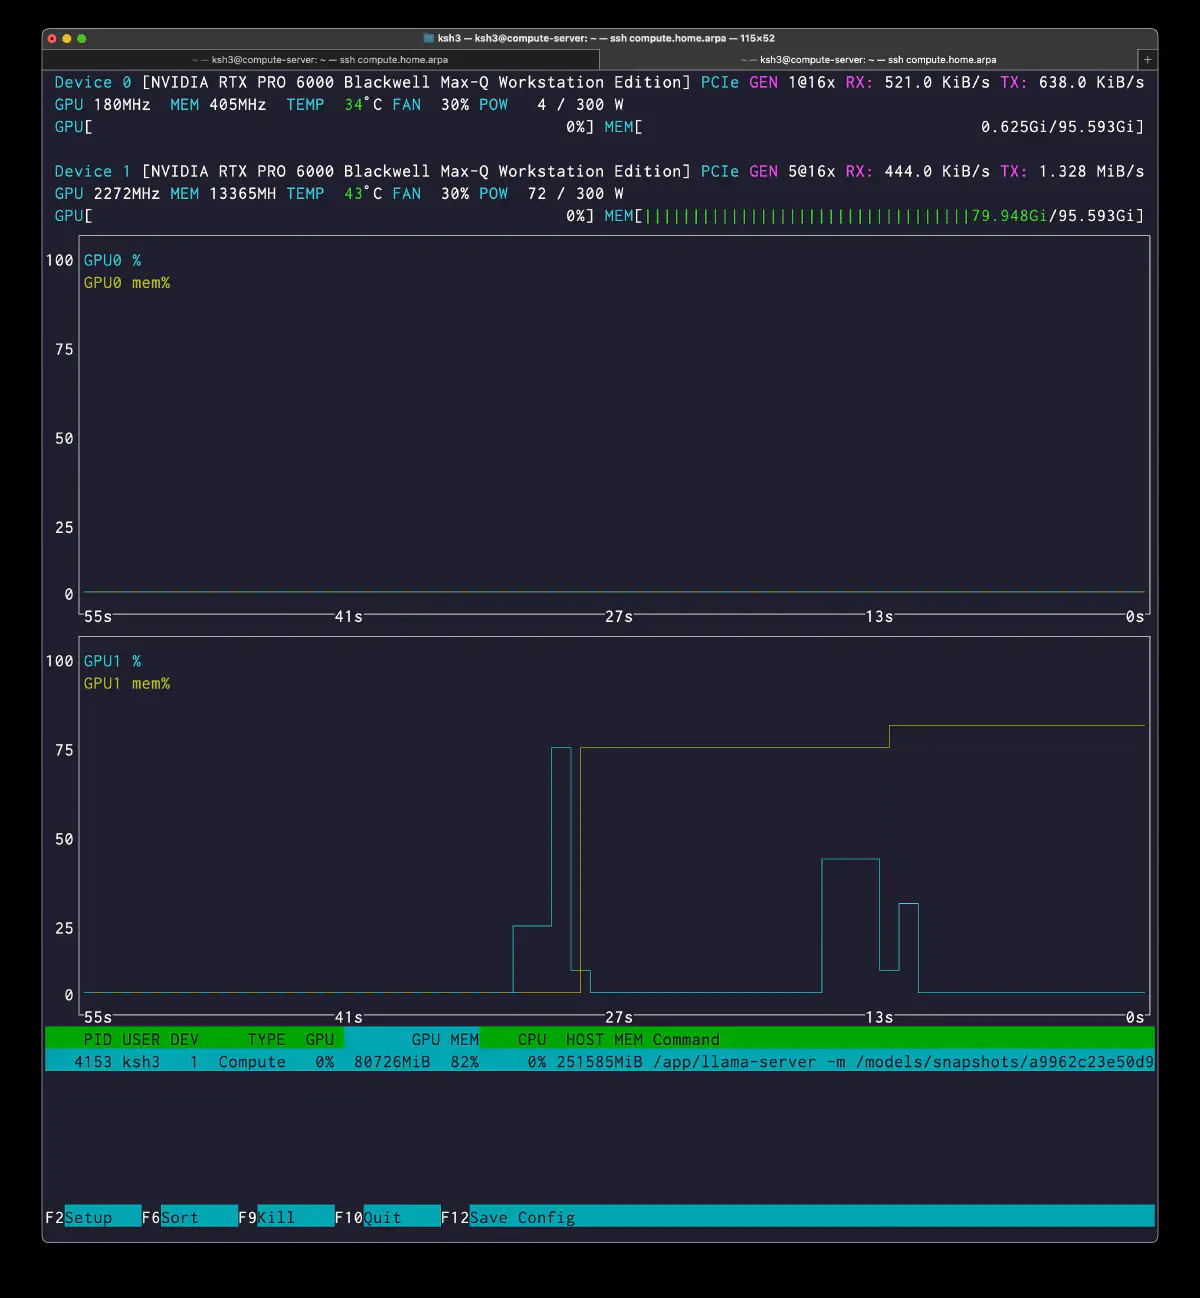
改善は+5.7%でした。
失敗: hybrid --n-cpu-moe 58, 1GPU -> OOM
約20層を1GPUへ置く--n-cpu-moe 58はOOMでした。
  podman run --rm \
  --device nvidia.com/gpu=1 \
  -p 8000:8000 \
  --cap-add=SYS_NICE \
  -v /mnt/data/models/models--ubergarm--GLM-5.1-GGUF:/models:ro,Z \
  registry.home.arpa/ik_llama.cpp:latest \
  -m /models/snapshots/a9962c23e50d9c352e09fe0d9cb131026f4e6441/IQ3_KS/GLM-5.1-IQ3_KS-00001-of-00008.gguf \
  --merge-qkv --ctx-size 32768 -ctk q8_0 -ctv q8_0 --parallel 1 --threads 15 --threads-batch 24 -b 8192 -ub 8192 -ngl 999 --n-cpu-moe 58 -muge -mla 3 -amb 512 --jinja --host 0.0.0.0 --port 8000 --warmup-batch -ger --alias GLM-5.1 --temp 0.7 --top-k 45 --top-p 0.95 --min-p 0.01
  ggml_backend_cuda_buffer_type_alloc_buffer: allocating 5418.03 MiB on device 0: cudaMalloc failed: out of memory
ggml_gallocr_reserve_n: failed to allocate CUDA0 buffer of size 5681217536
llama_init_from_model: failed to allocate compute buffers
20層のexpertだけで約82GBになり、non-expert、KV、computeを加えると収まりません。
構成5: hybrid -ot head12+tail10, 2GPU, -ger
最良だったのは、-otでheadとtailを別GPUへ置く配置です。
  OT_ARGS=""
for i in $(seq 3 14); do
  OT_ARGS="$OT_ARGS -ot blk.$i.ffn_gate_exps=CUDA0"
  OT_ARGS="$OT_ARGS -ot blk.$i.ffn_down_exps=CUDA0"
  OT_ARGS="$OT_ARGS -ot blk.$i.ffn_up_exps=CUDA0"
done
for i in $(seq 68 77); do
  OT_ARGS="$OT_ARGS -ot blk.$i.ffn_gate_exps=CUDA1"
  OT_ARGS="$OT_ARGS -ot blk.$i.ffn_down_exps=CUDA1"
  OT_ARGS="$OT_ARGS -ot blk.$i.ffn_up_exps=CUDA1"
done

podman run --rm \
  --device nvidia.com/gpu=all \
  -p 8000:8000 \
  --cap-add=SYS_NICE \
  -v /mnt/data/models/models--ubergarm--GLM-5.1-GGUF:/models:ro,Z \
  registry.home.arpa/ik_llama.cpp:latest \
  -m /models/snapshots/a9962c23e50d9c352e09fe0d9cb131026f4e6441/IQ3_KS/GLM-5.1-IQ3_KS-00001-of-00008.gguf \
  --merge-qkv --ctx-size 32768 -ctk q8_0 -ctv q8_0 \
  --parallel 1 --threads 15 --threads-batch 24 \
  -b 8192 -ub 8192 -ngl 999 \
  --cpu-moe $OT_ARGS -ger \
  -muge -mla 3 -amb 512 \
  --jinja --host 0.0.0.0 --port 8000 \
  --warmup-batch --alias GLM-5.1
起動時の値です。
  Allocating 218045 MiB of pinned host memory

GPU0: 57190MiB (58%)
GPU1: 48756MiB (50%)
配置の内訳です。
- GPU0: head 12 層 + 前半 attention
- GPU1: tail 10 層 + 後半 attention
- CPU: 中間 53 層の expert
今回の最良PP/TGです。
  # 短い出力 thinking無し
prompt eval time =    1111.85 ms /    30 tokens (   37.06 ms per token,    26.98 tokens per second)
       eval time =    2942.51 ms /    64 tokens (   45.98 ms per token,    21.75 tokens per second)

# 長い出力 thinking無し
prompt eval time =    2016.80 ms /    43 tokens (   46.90 ms per token,    21.32 tokens per second)
       eval time =   94650.69 ms /  2048 tokens (   46.22 ms per token,    21.64 tokens per second)

# 長い出力 thinking有り
prompt eval time =    1431.92 ms /    43 tokens (   33.30 ms per token,    30.03 tokens per second)
       eval time =  190089.65 ms /  4096 tokens (   46.41 ms per token,    21.55 tokens per second)
nvtopではCPU負荷も少し下がりました。
  PID USER DEV     TYPE  GPU        GPU MEM    CPU  HOST MEM
4483 ksh3   0  Compute  24%  64268MiB  66%  1355% 219523MiB
4483 ksh3   1  Compute  22%  55322MiB  57%  1194% 219523MiB
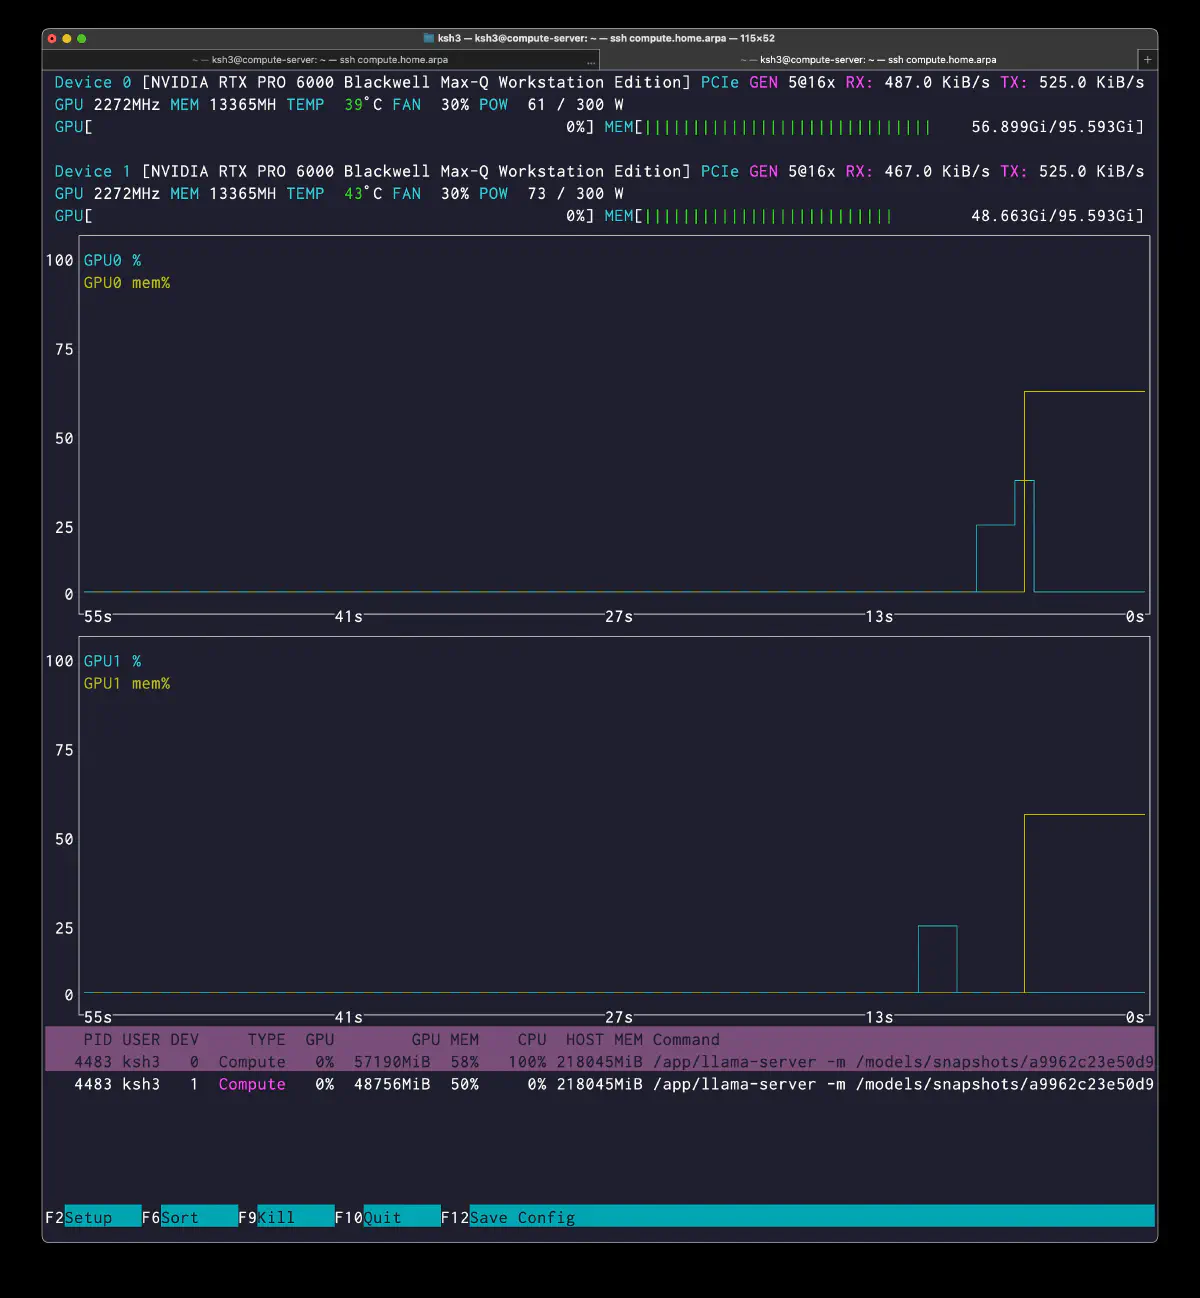
18.84 -> 21.75 t/s、+15.4%でした。22層のうちheadは12層です。tailだけの配置より改善し、headを置く案を支持する結果でした。
Grafana モニタリング
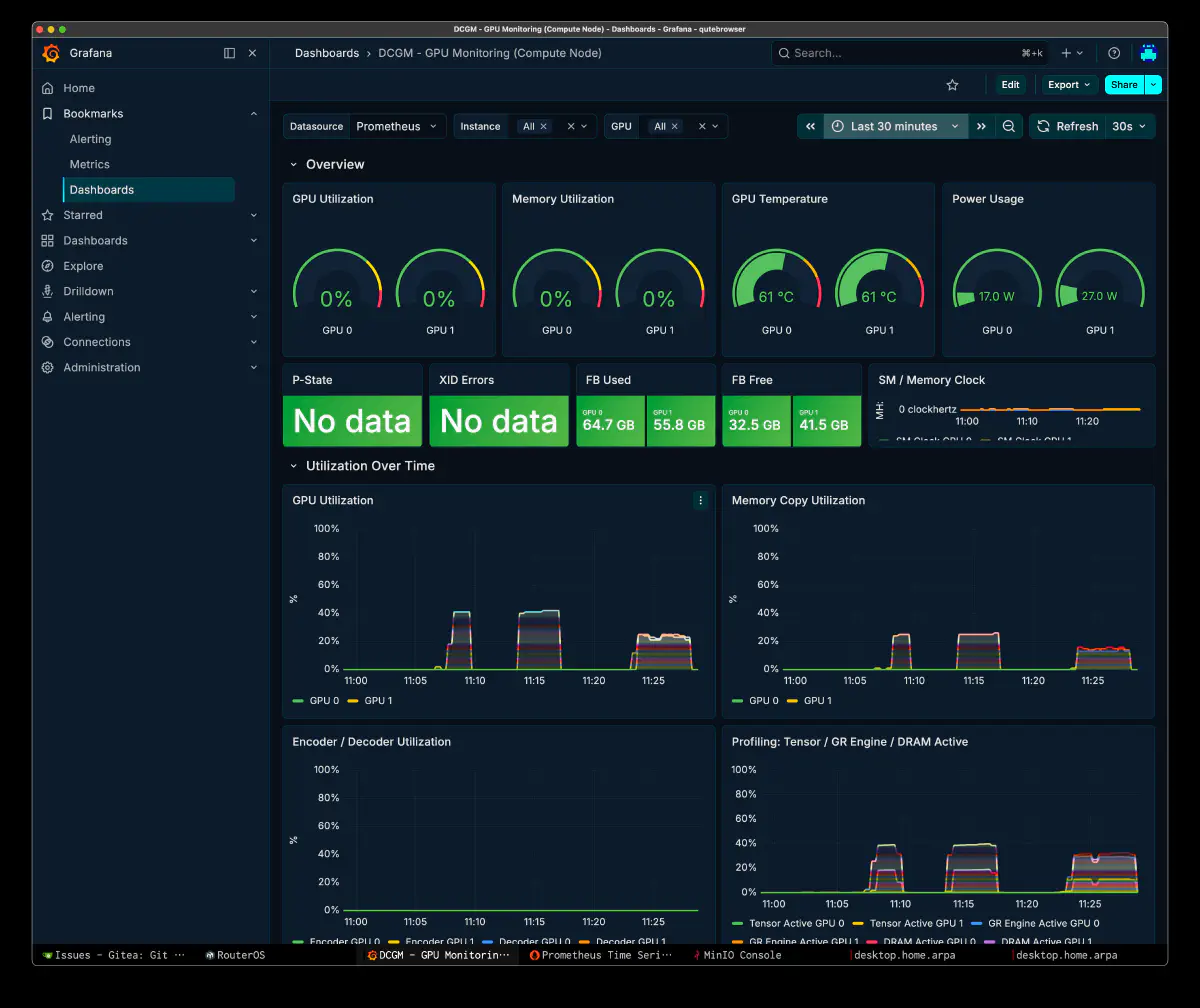
DCGM exporterでGPU使用率、memory copy、温度、電力を確認しました。
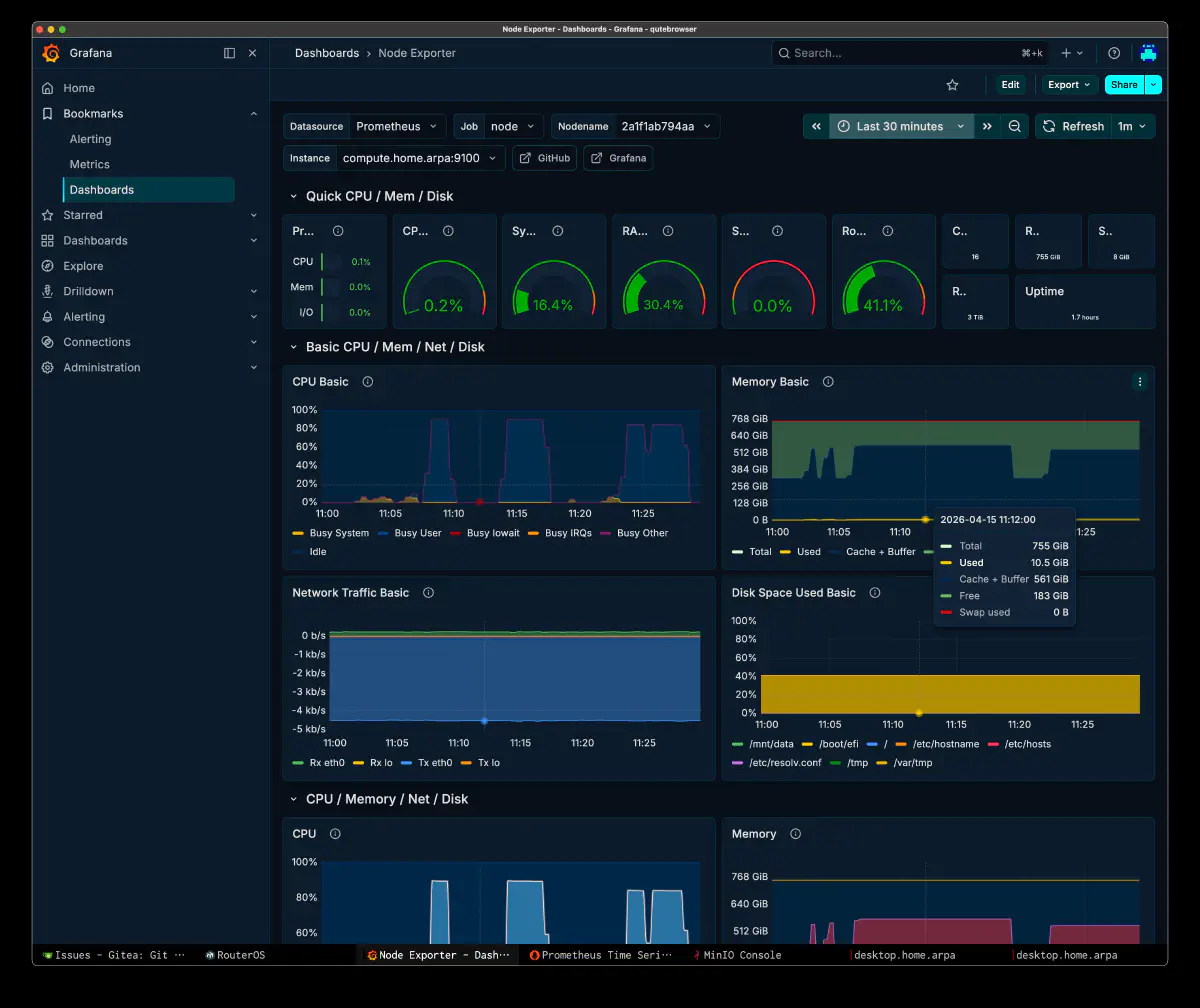
Node ExporterでCPU Busy Userとメモリも確認しました。
ベンチマーク比較サマリ
TG (eval) 比較
| # | 構成 | GPU数 | expert GPU層 | 短 TG | 2048t TG | 4096t TG | 改善 |
|---|---|---|---|---|---|---|---|
| 1 | hybrid -ot exps=CPU | 2 | 0 | 18.84 | 18.35 | 18.10 | baseline |
| 2 | hybrid --cpu-moe | 2 | 0 | 18.84 | 18.35 | 18.10 | ±0% |
| 3 | hybrid --cpu-moe | 1 | 0 | 18.86 | 18.46 | 18.42 | +0.1% |
| 4 | hybrid --n-cpu-moe 64 -ger | 1 | 14 (tail) | 19.94 | 19.78 | 19.76 | +5.8% |
| 5 | hybrid -ot head+tail -ger | 2 | 22 (h12+t10) | 21.75 | 21.64 | 21.55 | +15.4% |
PP (prompt eval) 比較
| # | 構成 | 短 PP | 長 PP | best PP |
|---|---|---|---|---|
| 1 | hybrid -ot exps=CPU 2GPU | 22.66 | 23.48 | 23.48 |
| 3 | hybrid --cpu-moe 1GPU | 23.12 | 23.59 | 25.35 |
| 4 | hybrid --n-cpu-moe 64 -ger | 25.57 | 25.44 | 25.83 |
| 5 | hybrid -ot head+tail -ger | 26.98 | 21.32 | 30.03 |
GPU リソース比較
| # | 構成 | VRAM dev0 | VRAM dev1 | GPU util | CPU% | pinned RAM |
|---|---|---|---|---|---|---|
| 1 | hybrid exps=CPU 2GPU | 15236MiB | 14460MiB | 17-19% | 1500% | 300GB |
| 3 | hybrid cpu-moe 1GPU | — | 23592MiB | 17-19% | 1500% | 300GB |
| 4 | hybrid n-cpu-moe 64 | — | 80804MiB | 41% | 1432% | 244GB |
| 5 | hybrid -ot head+tail | 57190MiB | 48756MiB | 22-24% x 2 | 1355% | 218GB |
改善率サマリ
  hybrid cpu-moe 全載せ (baseline):  18.84 tok/s
hybrid cpu-moe 1GPU:               18.86 tok/s  (+0.1%)
hybrid n-cpu-moe 64 -ger:          19.94 tok/s  (+5.8%)
hybrid -ot head12+tail10 -ger:     21.75 tok/s  (+15.4%)
考察
CPU expertの処理時間
EPYC 9175Fは16コアで、256 expertsのうち8 activeをtokenごとに計算します。TGの85-90%がCPU側にある構成では、GPUを追加するだけでは改善しません。
headとtailの配置
tail 14層に対し、head 12 + tail 10の改善が大きく、head側のactivation密度が高い可能性があります。層数の違いも含むため、頻度の計測は次の課題です。
2GPU の価値は容量
expertとQwen3-Coder-Nextを常駐させるには96GB x 2の容量を使います。cpu-moe全載せ時とはGPUの使い方が変わります。
Thinkingの費用
thinkingはTGより出力token数を増やします。短い判断と次ターンの指示では、追加時間を避けるため無効にする方針です。収束への影響はPhase 0で確認します。
-ger は小さいが無視しにくい
reviewを繰り返すなら1-2%も累積します。CPU expertが多く残るため、L3 locality改善の候補として-gerを使う方針です。
Qwen3-Coder-Next を含めた最終構成方針
ここからはnaughty-workerを2本常駐させる配置案です。
Qwen3-Coder-Next の KV 効率
Qwen3-Coder-NextはKV cacheが小さい構成です。
  48層: 36層 DeltaNet(KV cache不要) + 12層 Gated Attention(KV heads=2)
256k ctx: KV ~3GB
1M ctx (YaRN): KV ~11GB
長いctxを持つworkerを並べる際に有利です。
Naughty の --parallel 戦略
| parallel | per-slot ctx | coding 実用性 |
|---|---|---|
| 1 | 256k | 余裕はあるが throughput が低い |
| 2 | 128k | 実用ライン |
| 3 | 85k | heavy task で溢れやすい |
| 4 | 64k | agentic coding にはかなり厳しい |
--parallel 2を実用の下限とし、128k x 2の処理量を優先します。256k / slotやYaRNの1M ctxへの拡張は後の候補です。
Quant 選択: Qwen3-Coder-Next は Q4_0
| Quant | PPL | weights | grandpa expert 予算 |
|---|---|---|---|
IQ4_KSS | 8.31 | 39 GiB | 48GB/GPU |
Q4_0 | 8.25 | 45 GiB | 42GB/GPU |
PPL差は0.06ですが、workerのコード品質を優先しました。GLM expertの2-3層、1000 tokensあたり約1秒と交換する判断です。
最終構成
  dev0 (96GB):
  naughty-worker0: Q4_0, --parallel 2, 128k x 2
    weights 45GB + KV ~5.5GB + compute ~3GB = ~54GB
  grandpa expert (head側): ~42GB -> 10層

dev1 (96GB):
  naughty-worker1: Q4_0, --parallel 2, 128k x 2
    weights 45GB + KV ~5.5GB + compute ~3GB = ~54GB
  grandpa expert (tail+mid側): ~42GB -> 10層

grandpa non-expert/KV/compute: ~12GB/GPU (layer-split)
grandpa expert 合計: ~84GB -> 20層
CPU (768GB RAM): 残り55層の expert (~225GB pinned)
目標は~47ms/token、21+ t/sです。22層の46msより少し遅くても、worker 2本を維持する案です。実測した最良配置とは分けて考えます。
Expert 配置案(20層)
  GPU0 (head重点):
  blk.3,4,5,6,7,8,9,10  + blk.20,30 = 10層

GPU1 (tail重点):
  blk.70,71,72,73,74,75,76,77 + blk.50,60 = 10層
head 8、tail 8、mid 4の20層案です。22層の結果に近づけるかは、これから確認します。
オーケストレーター運用への影響
reviewを1000 tokensと仮定した時間です。
| 構成 | 所要時間 |
|---|---|
| cpu-moe baseline (18.8 t/s) | 53秒 |
| n-cpu-moe 64 (19.9 t/s) | 50秒 |
-ot head+tail (21.6 t/s) | 46秒 |
7秒の差も2、3ラウンドで積み重なります。一方22層ではworkerの常駐枠が減ります。Phase 0でgrandpaの速さとnaughtyの処理量のどちらが収束に効くかを見る予定です。
将来の最適化オプション
カスタム GGUF ビルド
hot layerだけ量子化精度を上げる案です。
  # GPU層 (head 8 + tail 8)
blk\.(3|4|5|6|7|8|9|10)\.ffn_down_exps\.weight=iq6_k
blk\.(3|4|5|6|7|8|9|10)\.ffn_(gate|up)_exps\.weight=iq5_ks
blk\.(70|71|72|73|74|75|76|77)\.ffn_down_exps\.weight=iq6_k
blk\.(70|71|72|73|74|75|76|77)\.ffn_(gate|up)_exps\.weight=iq5_ks

# CPU層 (middle)
blk\..*\.ffn_down_exps\.weight=iq4_ks
blk\..*\.ffn_(gate|up)_exps\.weight=iq3_ks
parse tierのstrict率を改善する可能性があります。16層で~19GB増えるため、workerのctxとの配分になります。
Expert Activation Profiling
--metricsとverbose loggingで層別activation頻度を測る案です。
IQ4_K への Quant 変更(GLM側)
IQ3_KS -> smol-IQ4_Kで指示追従を上げる案です。TGは-10-15%になる可能性がありますが、parse tierとconvergence rateの改善を合わせて評価します。
Raw Benchmark Appendix
実行コマンド、起動ログ、PP/TG値です。grepで確認できるよう原文を残しています。
A. -ot exps=CPU 2GPU
  ggml_cuda_init: found 2 CUDA devices:
  Device 0: NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, compute capability 12.0, VMM: yes, VRAM: 97247 MiB
  Device 1: NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, compute capability 12.0, VMM: yes, VRAM: 97247 MiB

Split mode 'graph' is not supported for this model
  => changing split mode to 'layer'

llm_load_print_meta: model type       = 744B.A40B
llm_load_print_meta: model ftype      = IQ3_KS - 3.1875 bpw
llm_load_print_meta: model params     = 753.864 B
llm_load_print_meta: model size       = 320.216 GiB (3.649 BPW)

llm_load_tensors:  CUDA_Host buffer size = 307110.47 MiB
llm_load_tensors:      CUDA0 buffer size =  7378.05 MiB
llm_load_tensors:      CUDA1 buffer size =  7120.90 MiB

llama_init_from_model: n_ctx         = 32768
llama_init_from_model: n_batch       = 8192
llama_init_from_model: n_ubatch      = 8192
llama_init_from_model: flash_attn    = 1
llama_init_from_model: mla_attn      = 3
llama_init_from_model: attn_max_b    = 512
llama_init_from_model: fused_moe     = 1
llama_init_from_model: grouped er    = 0
llama_init_from_model: fused_up_gate = 1
llama_init_from_model: fused_mmad    = 1
llama_init_from_model: graph_reuse   = 1

llama_kv_cache_init:      CUDA0 KV buffer size =   784.15 MiB
llama_kv_cache_init:      CUDA1 KV buffer size =   707.64 MiB
llama_init_from_model: KV self size  = 1491.75 MiB

llama_init_from_model:      CUDA0 compute buffer size =  5418.03 MiB
llama_init_from_model:      CUDA1 compute buffer size =  5032.00 MiB
llama_init_from_model:  CUDA_Host compute buffer size =   704.09 MiB
llama_init_from_model: graph nodes  = 10250
llama_init_from_model: graph splits = 190

Allocating 299.91 GiB of pinned host memory
done allocating 299.91 GiB in 51786.7 ms
  # 短い出力 thinking無し (61 tokens)
prompt eval time =    1323.95 ms /    30 tokens (   44.13 ms per token,    22.66 tokens per second)
       eval time =    3238.59 ms /    61 tokens (   53.09 ms per token,    18.84 tokens per second)
      total time =    4562.54 ms /    91 tokens

# 短い出力 thinking有り (355 tokens = 294 thinking + 61 content)
prompt eval time =      55.51 ms /     1 tokens (   55.51 ms per token,    18.02 tokens per second)
       eval time =   19024.07 ms /   355 tokens (   53.59 ms per token,    18.66 tokens per second)
      total time =   19079.58 ms /   356 tokens

# 長い出力 thinking無し (2048 tokens)
prompt eval time =    1831.66 ms /    43 tokens (   42.60 ms per token,    23.48 tokens per second)
       eval time =  111609.04 ms /  2048 tokens (   54.50 ms per token,    18.35 tokens per second)
      total time =  113440.71 ms /  2091 tokens

# 長い出力 thinking有り (4096 tokens)
prompt eval time =    2459.53 ms /    43 tokens (   57.20 ms per token,    17.48 tokens per second)
       eval time =  226282.06 ms /  4096 tokens (   55.24 ms per token,    18.10 tokens per second)
      total time =  228741.58 ms /  4139 tokens
B. --cpu-moe 1GPU
  ggml_cuda_init: found 1 CUDA devices:
  Device 0: NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, compute capability 12.0, VMM: yes, VRAM: 97247 MiB

llm_load_tensors:  CUDA_Host buffer size = 307110.47 MiB
llm_load_tensors:      CUDA0 buffer size = 14498.95 MiB

llama_kv_cache_init:      CUDA0 KV buffer size =  1491.79 MiB
llama_init_from_model:      CUDA0 compute buffer size =  5418.03 MiB
llama_init_from_model:  CUDA_Host compute buffer size =   704.09 MiB
llama_init_from_model: graph nodes  = 10250
llama_init_from_model: graph splits = 152

Allocating 299.91 GiB of pinned host memory
done allocating 299.91 GiB in 46485.7 ms
  # 短い出力 thinking無し (63 tokens)
prompt eval time =    1297.67 ms /    30 tokens (   43.26 ms per token,    23.12 tokens per second)
       eval time =    3340.94 ms /    63 tokens (   53.03 ms per token,    18.86 tokens per second)
      total time =    4638.61 ms /    93 tokens

# 長い出力 thinking無し (2048 tokens)
prompt eval time =    1823.10 ms /    43 tokens (   42.40 ms per token,    23.59 tokens per second)
       eval time =  110967.85 ms /  2048 tokens (   54.18 ms per token,    18.46 tokens per second)
      total time =  112790.94 ms /  2091 tokens

# 長い出力 thinking有り (4096 tokens)
prompt eval time =    1696.37 ms /    43 tokens (   39.45 ms per token,    25.35 tokens per second)
       eval time =  222410.35 ms /  4096 tokens (   54.30 ms per token,    18.42 tokens per second)
      total time =  224106.72 ms /  4139 tokens
C. --n-cpu-moe 64 -ger 1GPU
  ggml_cuda_init: found 1 CUDA devices:

# blk.3〜blk.63: CUDA_Host (55 MoE層 CPU)
# blk.64〜blk.77: GPU (14 MoE層)

Allocating 244.02 GiB of pinned host memory
  # 短い出力 thinking無し (62 tokens)
prompt eval time =    1173.39 ms /    30 tokens (   39.11 ms per token,    25.57 tokens per second)
       eval time =    3109.75 ms /    62 tokens (   50.16 ms per token,    19.94 tokens per second)
      total time =    4283.14 ms /    92 tokens

# 長い出力 thinking無し (2048 tokens)
prompt eval time =    1690.07 ms /    43 tokens (   39.30 ms per token,    25.44 tokens per second)
       eval time =  103526.50 ms /  2048 tokens (   50.55 ms per token,    19.78 tokens per second)
      total time =  105216.57 ms /  2091 tokens

# 長い出力 thinking有り (4096 tokens)
prompt eval time =    1664.97 ms /    43 tokens (   38.72 ms per token,    25.83 tokens per second)
       eval time =  207284.39 ms /  4096 tokens (   50.61 ms per token,    19.76 tokens per second)
      total time =  208949.37 ms /  4139 tokens
D. -ot head12+tail10 -ger 2GPU
  ggml_cuda_init: found 2 CUDA devices:

Allocating 218045 MiB of pinned host memory (HOST MEM)

# GPU VRAM:
GPU0: 57190MiB (58%)
GPU1: 48756MiB (50%)
  # 短い出力 thinking無し (64 tokens)
prompt eval time =    1111.85 ms /    30 tokens (   37.06 ms per token,    26.98 tokens per second)
       eval time =    2942.51 ms /    64 tokens (   45.98 ms per token,    21.75 tokens per second)
      total time =    4054.36 ms /    94 tokens

# 長い出力 thinking無し (2048 tokens)
prompt eval time =    2016.80 ms /    43 tokens (   46.90 ms per token,    21.32 tokens per second)
       eval time =   94650.69 ms /  2048 tokens (   46.22 ms per token,    21.64 tokens per second)
      total time =   96667.49 ms /  2091 tokens

# 長い出力 thinking有り (4096 tokens)
prompt eval time =    1431.92 ms /    43 tokens (   33.30 ms per token,    30.03 tokens per second)
       eval time =  190089.65 ms /  4096 tokens (   46.41 ms per token,    21.55 tokens per second)
      total time =  191521.57 ms /  4139 tokens
次の配置検証
今回の改善はGPU枚数よりexpert配置によるものでした。
次は21+ t/sとQwen3-Coder-Next Q4_0 --parallel 2のworker 2本を両立する構成を測ります。Phase 0ではparse tier、converged<=2round、force_accepted rateも確認し、速度と品質の配分を決めます。
GLM単独なら、GPU expert予算の約3割をheadとtailに割り当て、残りを中間層へ配る案もあります。両端だけでは中間層を取りこぼす可能性があり、これは未検証の仮説です。
edgeを固定し、中間層のodd優先とeven優先の2パターンを比較する案です。用途ごとの違いを確認し、詳細profiling前の簡易調整に使えるかを見ます。