
Kimi-K2.6のCPU / GPU配置とコード生成
Kimi-K2.6のIQ3_KとQ4_Xをik_llama.cppで比較。ローカルLLM導入のexpert配置、生成速度、Django業務システムの生成例を記録します。
Kimi-K2.6 は Moonshot AI の1T級MoEで、384 expertのうち8つを活性化する DeepSeek2 系モデルです。CPUメモリとGPUへ重みを分け、ローカルのcoding workerとして使えるか確認しました。
ubergarm/Kimi-K2.6-GGUF の IQ3_K と Q4_X を EPYC 9175F + RTX PRO 6000 Blackwell Max-Q 96GB x 2 で動かしました。ik_llama.cpp のMLAとexpert配置を使います。Vision未対応のためtext-generationのみです。mainlineは –no-cache でビルドしましたが、tool_call_parserで落ち、画像の確認は後日にしました。
動画リンク: https://www.youtube.com/watch?v=skTE19_JRYg
動画は、EPYC 9175F、768GB DDR5-6400、Blackwell Max-Q 96GBで配置を試し、IQ3_Kを選んだ後の記録です。ubergarm の IQ3_K(3.85 bpw、460 GiB)を中心に、head / tailの4〜10層だけGPU、残りをCPU pinned memoryへ置きました。
- TGは
17.9〜21 t/s、PP coldは223〜377 t/sで、-ubと-otによって変わりました。 14,707tokensの連続生成でも19.57 t/sでした。自作MCPの呼出しは多くないものの、ローカルGiteaにISSUE / MS / PRを作成できました。opus4.6のようなツール利用で、もう少しTGが上がればと感じます。256k qtv ctv f16でも、VRAMは150GB未満だった記憶があります。IQ3_Kは17.9〜20.9 t/s、Q4_Xは16.6〜19.0 t/sでした。同じAGENTS.mdでは動作の差が小さく見え、IQ3_Kを選びました。real_estate_salesはDjango v6対応の15 models / 772 linesを生成しました。- ライセンスはModified MITです。元のメモでは商用条件を月商30億または
100M MAU以下と整理しています。
検証環境
| 項目 | 構成 |
|---|---|
| CPU | AMD EPYC 9175F (16C/32T L3 512MB, Zen 5) |
| RAM | 768 GB DDR5-6400 ECC RDIMM |
| GPU | NVIDIA RTX PRO 6000 Blackwell Max-Q 96GB x 2 |
| OS | Ubuntu 24.04-LTS (minimal) |
| Runtime | ik_llama.cpp |
モデルの条件です。
| 項目 | 値 |
|---|---|
| モデル | Kimi-K2.6 |
| アーキテクチャ | DeepSeek2 系 MoE + MLA |
| 総パラメータ | 1T class |
| Experts / Active | 384 / 8 |
| 主な量子化 | IQ3_K (3.85 bpw), Q4_X (4.55 bpw) |
なぜ mainline llama.cpp ではなく ik_llama.cpp なのか
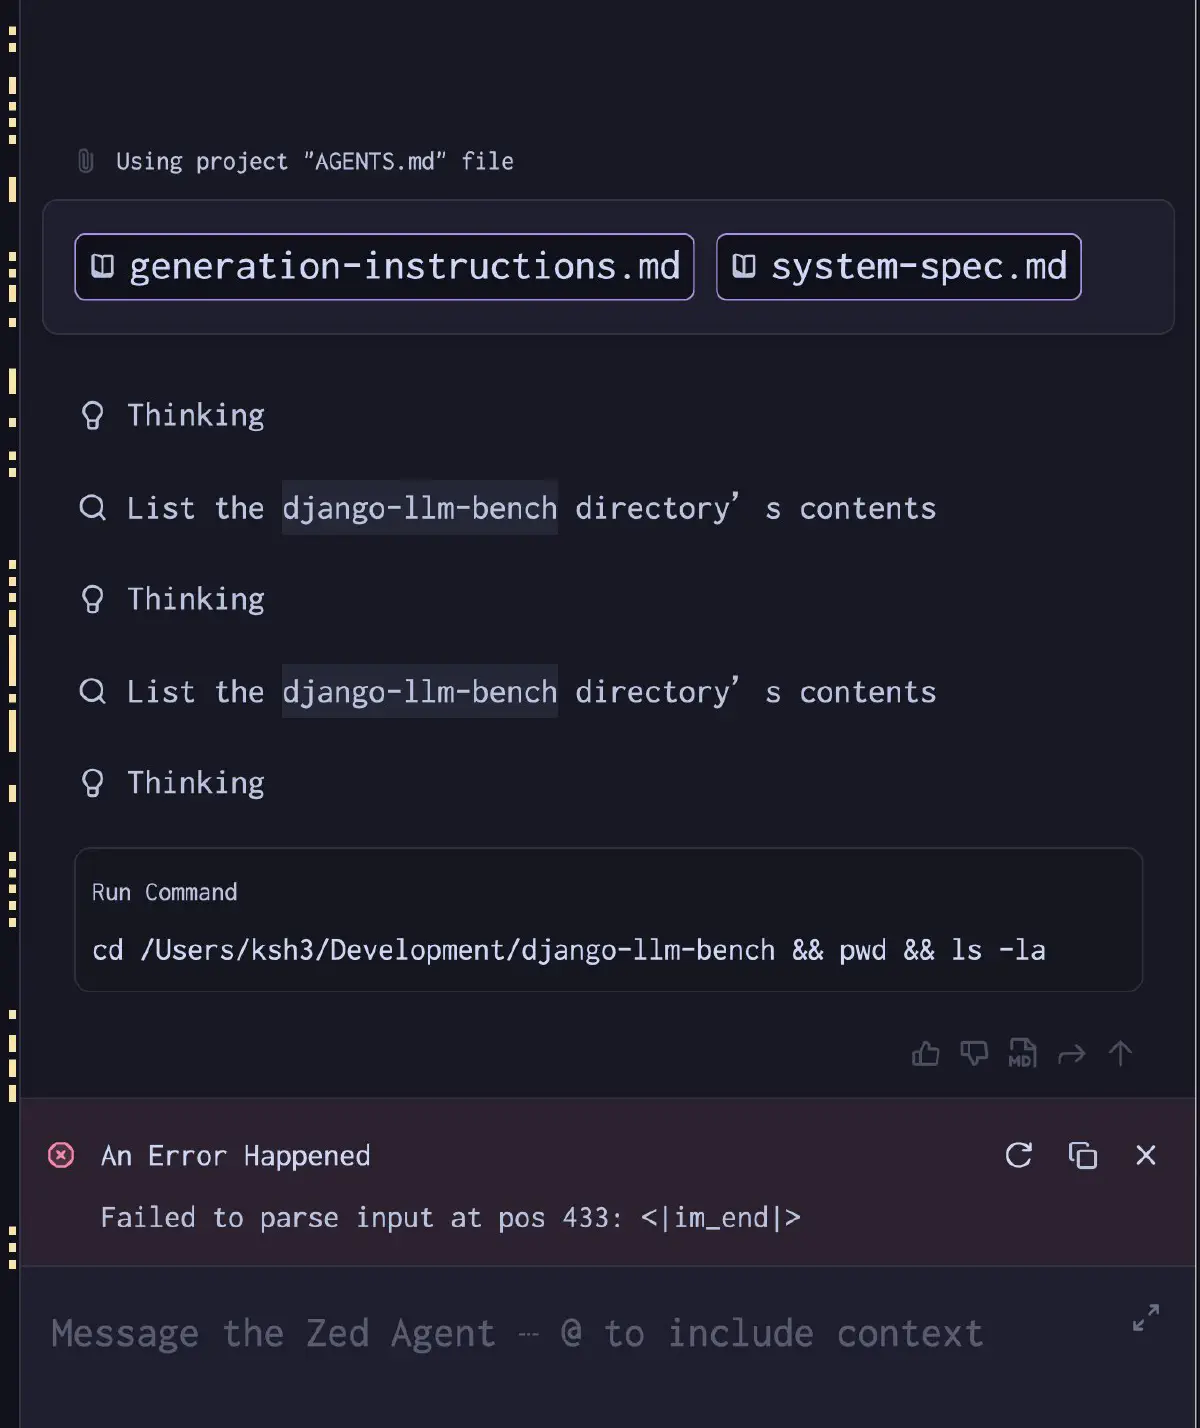
MLA(Multi-head Latent Attention)にはエンジン側の対応が必要です。2026/04/22のmainlineでは -mla 3 相当がなく、standard KV pathを使いました。peg-native parserは <|tool_call_begin|> を処理できず、tool_callを含む応答で Failed to parse input at pos 433: <|im_end|> を出して落ちました。–no-cache での再ビルドでも変わりません。template周りの問題と考え、後日再度試す予定です。
Failed to parse input at pos 433: <|im_end|>
Expert Tensor Placement が TG を決める
全expertをCPU pinned memoryに置くとdecodeが伸びませんでした。-ot でhead / tailのexpertをGPUへ戻し、中間層をCPUに残す配置を比べました。
ベンチ結果
| Config | Expert on GPU | TG avg (t/s) | PP cold (t/s) | VRAM/GPU |
|---|---|---|---|---|
Baseline (--cpu-moe) | 0 層 | 18.9 | 185 | ~11 GiB |
| 6-layer head/tail split | 6 層 (3+3) | 20.9 | 223 | ~52/60 GiB |
| 10-layer head-heavy | 10 層 (8+2) | 20.3 | 377 | ~43/44 GiB |
TGは6-layer balanced splitが最良でした。10-layer head-heavyと -ub 4096 はPPが速い一方、decodeは少し下がりました。
最終的に残した -ot 配置
  -ot "blk\.(1|2)\.ffn.*=CUDA0" \
-ot "blk\.(59|60)\.ffn.*=CUDA1" \
-ot "exps=CPU"
CUDA0にhead 2層(blk.1-blk.2)、CUDA1にtail 2層(blk.59-blk.60)、残り56層をCPU pinned memoryへ置きます。片側は39 GiB台後半、もう片側は35 GiB弱で、decodeは17-19 t/sでした。GPUを埋めずに常駐させる配置として選びました。
IQ3_K と Q4_X では向いている局面が違う
IQ3_K と Q4_X を比べます。
| Quant | BPW | Model Size | TG avg (t/s) | PP cold (t/s) | CUDA_Host |
|---|---|---|---|---|---|
| IQ3_K | 3.85 | 460 GiB | 20.9 | 223 | 368 GiB |
| Q4_X | 4.55 | 544 GiB | 18.6 | 567 | 455 GiB |
Q4_XはPPが速く、TGはIQ3_Kより遅い結果でした。重いexpert tensorの転送コストが影響すると考えています。数千tokenを生成する作業ではdecodeを優先し、RAMも87 GiB少ないIQ3_Kを選びました。
-mla の選び方
-mla の設定も速度に影響します。
| Flag | KV cache 方式 | VRAM 使用量 | 速度 |
|---|---|---|---|
-mla 0 | Standard KV | 最大 | 最遅 |
-mla 1 | Compressed latent KV | 最小 | 遅い |
-mla 3 | Absorbed MLA | 最大 | 最速 |
132k contextのKVは約8.9 GiBでした。VRAMを抑えるなら -mla 1、今回の96GB × 2ではTGを優先して -mla 3 を選びました。
実タスクで見えた品質
業務システム開発の例として、ZedからDjango tenant moduleを生成しました。IQ3_K、non-thinking mode、4~10-layer -ot の条件です。
massage_salon モジュール
約15分でGitea issueを作成し、.ctree.toml を調整して、Django v6の models/admin/apps を生成しました。15 models、839行です。
restaurant モジュール
10-layer head-heavyで、調達、収益、労務、売上、マスタをdomain別にモデル化しました。RestaurantSettings proxy、TextChoices、UniqueConstraint、MinValueValidator を使い分けていました。
real_estate_sales モジュール
3+3 splitで14,707 tokensを約12.5分、TG 19.57 t/s で生成しました。15 model classes、772行で、物件、査定、媒介契約、内覧、購入申込、ローン審査、売買契約、決済を扱っています。
自作の ctree MCPをsystem promptから使い、scopeを切り替えながら生成した点が印象に残りました。学習データにはないツールです。500Bを超えるモデルには推論能力の違いを感じますが、これは複数モデルを使った主観的な印象です。
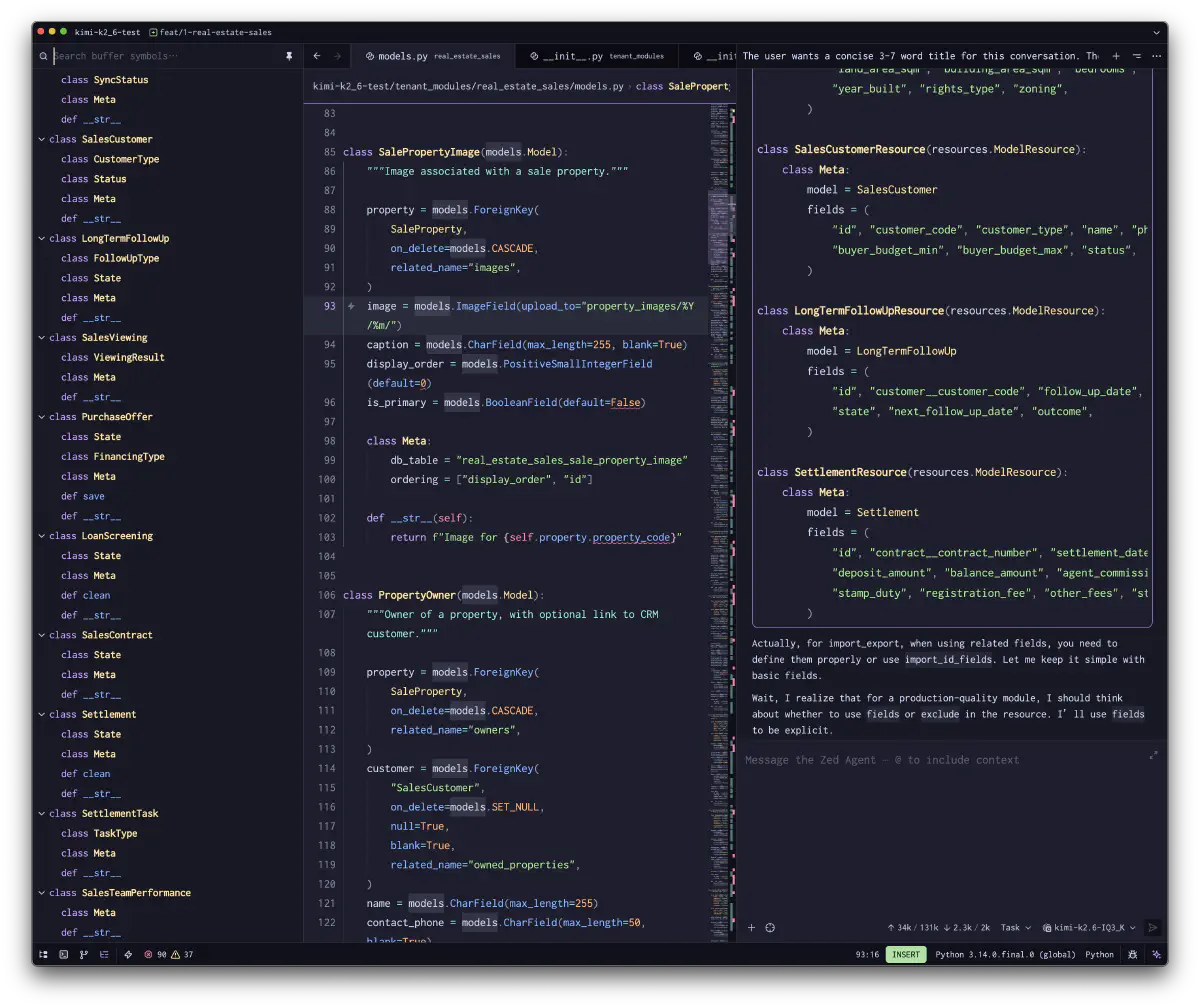
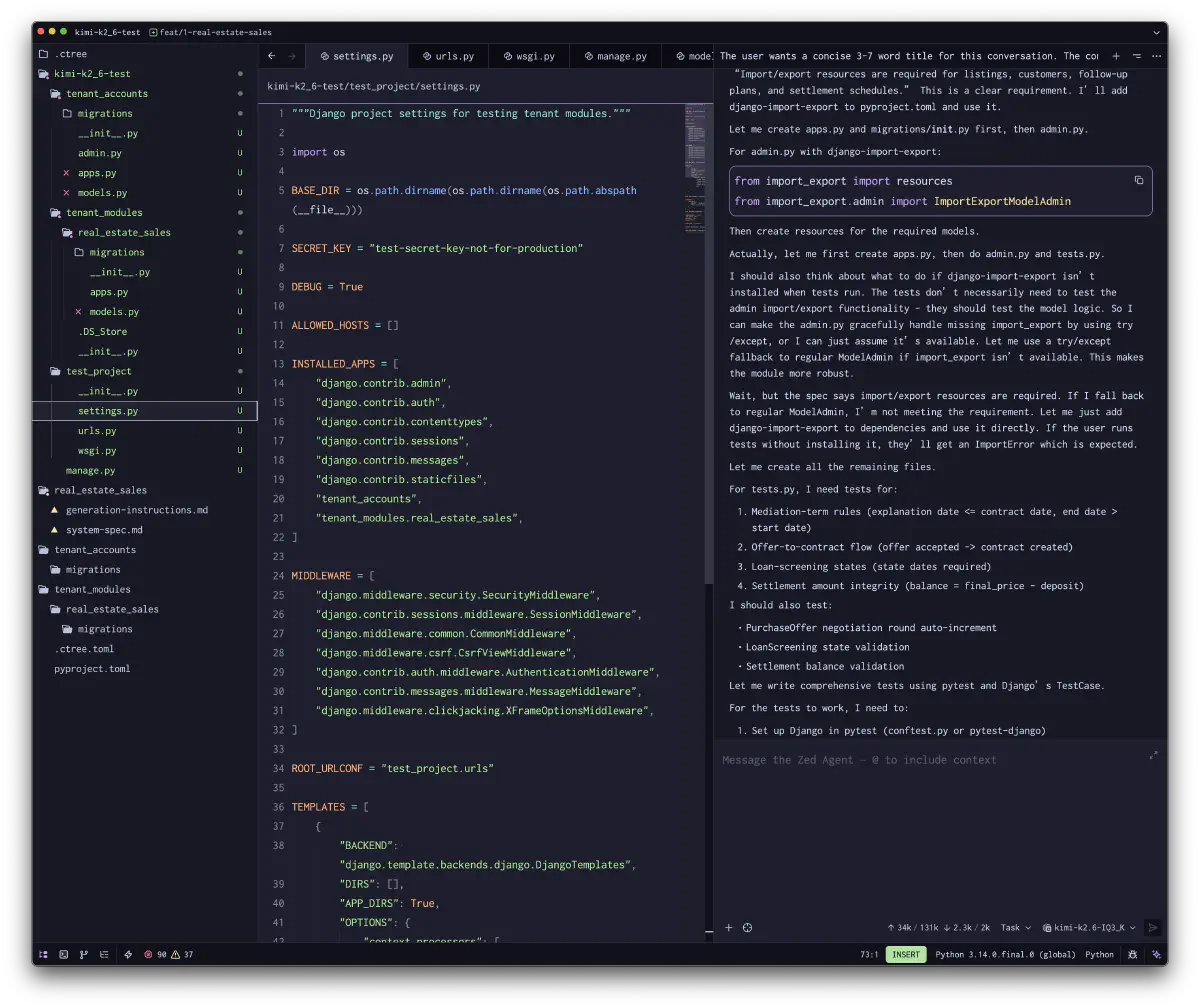
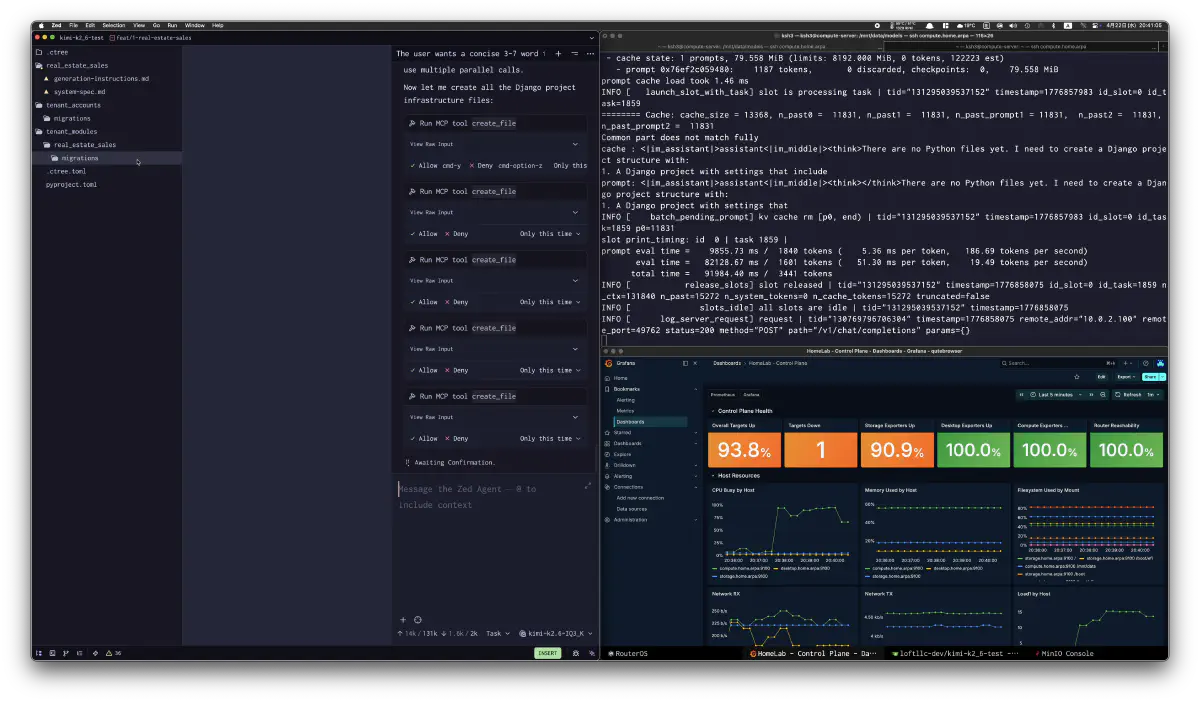
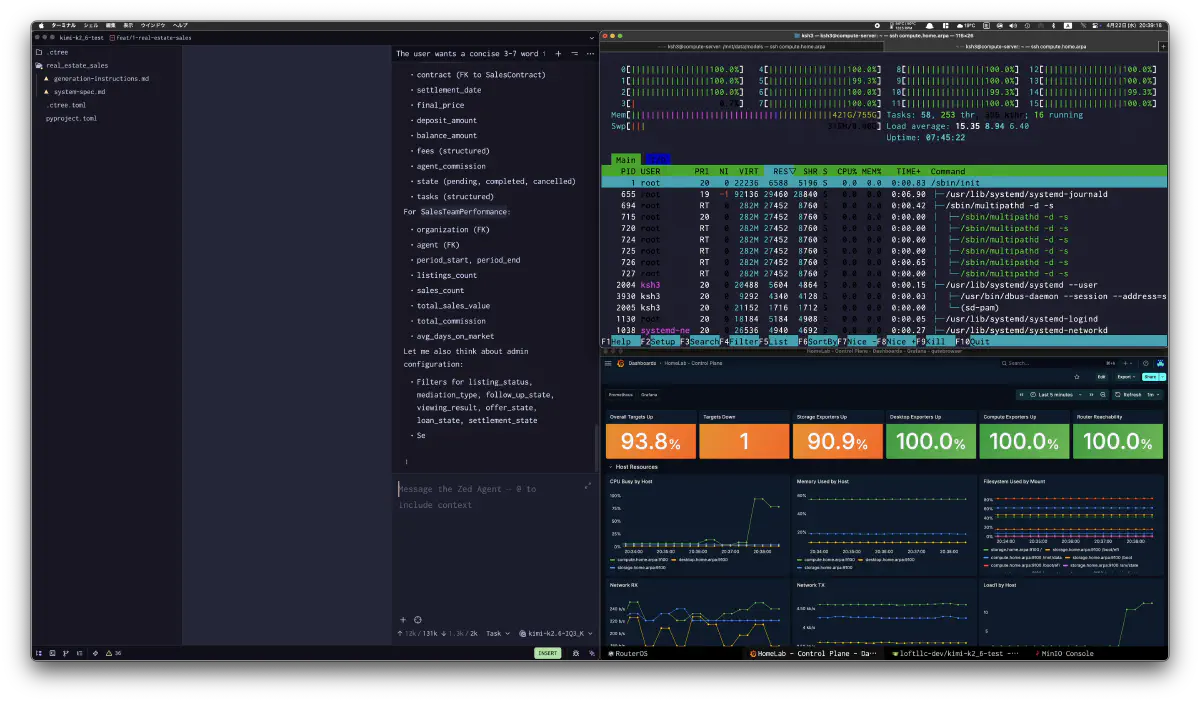
今回の長い作業では、複数ファイルの生成、テスト観点の列挙、MCP toolの呼出しを続けても崩れにくい結果でした。
ik_llama.cpp と mainline llama.cpp の比較
同じハードウェアでの比較です。
| Engine | Quant | TG (t/s) | PP cold (t/s) | Tool call |
|---|---|---|---|---|
| ik_llama.cpp | IQ3_K | 20.9 | 223 | OK |
| ik_llama.cpp | Q4_X | 18.6 | 567 | OK |
| llama.cpp (mainline) | Q4_X | 15.4 | 188 | Crash |
mainlineはtool-callで落ちました。Visionも確認したいので後日再ビルドする予定です。画像不要のcodingでは、-mla 3、複数 -ot、--jinja、tool_call が使える ik_llama.cpp を選びます。
参考: HFのcommunityで見た single-GPU ベンチ
HFの ubergarm/Kimi-K2.6-GGUF discussion #3 に、Q4_X、単一RTX PRO 6000、EPYC 9355、DDR5-6400の aiperf 結果がありました。16-turn conversation simulationの平均です。
| Engine | TG avg (t/s) | TTFT avg (ms) | Request latency avg (ms) |
|---|---|---|---|
| ik_llama.cpp | 18.85 | 8,563 | 22,480 |
| llama.cpp (mainline) | 16.03 | 12,526 | 28,872 |
この投稿でも ik_llama.cpp が全指標で上回っていました。-muge が逆効果になる場合も報告されており、fork側の設定を参考にしました。
実際に残した起動コマンド
  podman run --rm \
  --device nvidia.com/gpu=all \
  -p 8000:8000 \
  --cap-add=SYS_NICE \
  -v /mnt/data/models/models--ubergarm--Kimi-K2.6-GGUF:/models:ro,Z \
  registry.home.arpa/ik_llama.cpp:latest \
  -m /models/snapshots/${REF}/IQ3_K/Kimi-K2.6-IQ3_K-00001-of-00012.gguf \
  --ctx-size 131768 \
  --parallel 1 \
  --threads 15 \
  --threads-batch 32 \
  -b 8192 \
  -ub 4096 \
  -ngl 999 \
  -mla 3 \
  -ger \
  --special \
  -amb 512 \
  --jinja \
  --host 0.0.0.0 \
  --port 8000 \
  --warmup-batch \
  --alias kimi-k2.6-IQ3_K \
  -ot "blk\.(1|2)\.ffn.*=CUDA0" \
  -ot "blk\.(59|60)\.ffn.*=CUDA1" \
  -ot "exps=CPU" \
  --temp 0.6 \
  --chat-template-kwargs '{"thinking":false}'
OpenAI互換APIとして公開し、Zedと自作エージェントから使います。
今後の使い方
| 項目 | 値 |
|---|---|
| Model | Kimi-K2.6 (1T MoE, 384×8 active) |
| Quant | IQ3_K が実運用の本命 |
| Engine | ik_llama.cpp |
| TG | 20.9 t/s (6-layer head/tail split) |
| PP cold | 223-377 t/s (-ub と配置依存) |
| 実タスク | Django tenant module を長尺生成可能 |
| 用途 | orchestrator model |
| License | Modified MIT ($20M / 100M MAU 制限) |
元の記録では、CPU pinned memory、VRAM 72GB、RAM 512GBでぎりぎり動く構成として整理しています。ik_llama.cpp のMLAと -ot を調整し、Claudeと併用してデータパイプラインを整備する予定です。