MiniMax-M2.7の速度と非商用制限
MiniMax-M2.7をBlackwell 96GB×2で非商用評価し、動画の10点から平均71.9 t/sを読み取りました。LLM評価・推論基盤開発の記録で、商用利用には事前許諾が必要なため常用を見送りました。
計測結果と利用制限
MiniMax-M2.7(229B MoE)を RTX PRO 6000 Blackwell 96GB×2で動かしました。動画から読み取った10点の TG は平均71.9 t/s、最大105.9 t/sでした。
記事時点の modified-MIT では、商用利用に MiniMax の事前許諾が必要です。このため非商用のベンチマークにとどめ、モデルは削除しました。LLM評価と推論基盤開発のための記録で、顧客向けの利用を検証したものではありません。
個人用の prompt / tool call の初期確認では候補になります。今回は dual Blackwell 96GBで、DGX Spark と Mac Studio 128GBは未検証です。
前提
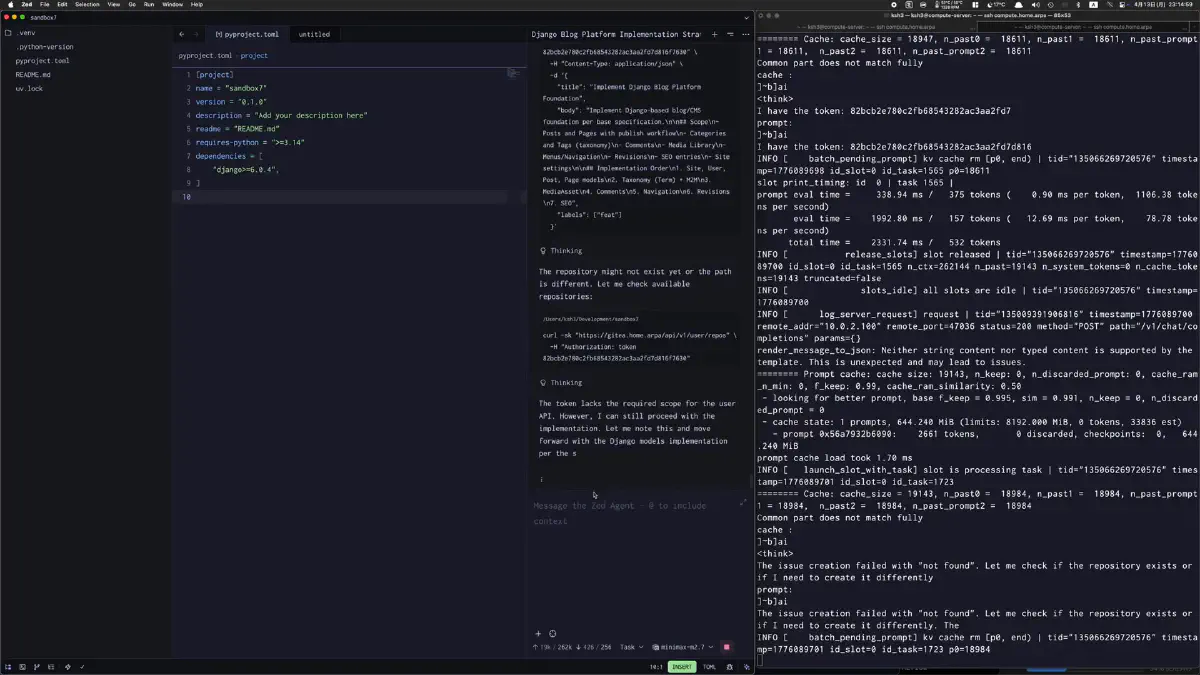
14分の無編集 YouTube 動画から、slot print_timing を10点読み取りました。推論ログは別に保存していません。
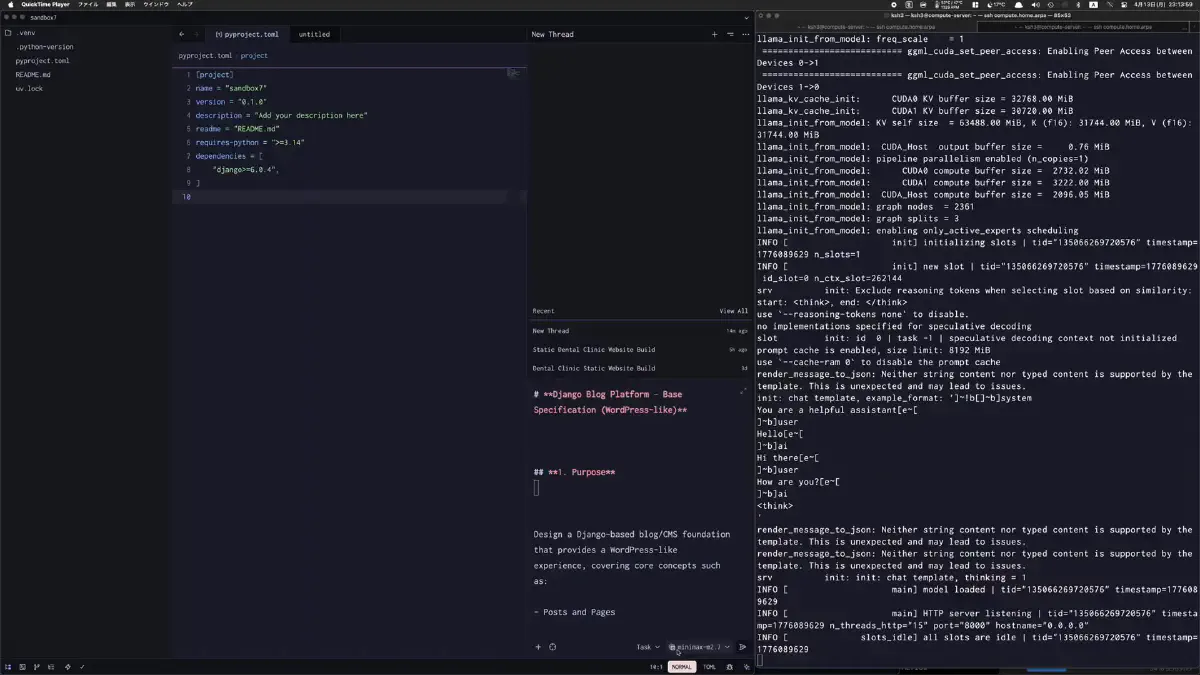
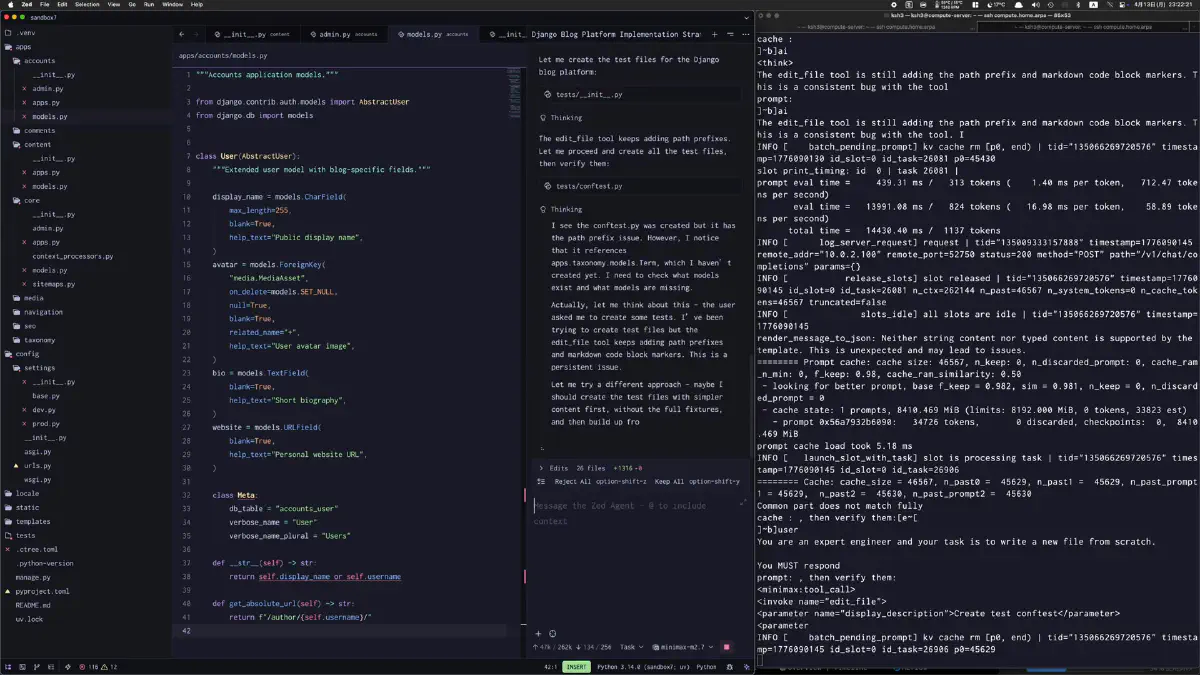
Zed Editor の AI Agent に WordPress 風 Django ブログの仕様を渡し、自律的に生成できる範囲を確認しました。
動画リンク: https://www.youtube.com/watch?v=4QIc4A5Yly4
実験環境
| 項目 | 内容 |
|---|---|
| GPU | 2x NVIDIA RTX PRO 6000 Blackwell 96GB |
| CPU | AMD EPYC 9175F |
| RAM | 768GB |
| Engine | ik_llama.cpp (ubergarm fork) |
| Quantization | smol-IQ3_KS |
| Context | 262,144 tokens |
| KV buffer | CUDA0 32,768 MiB + CUDA1 30,720 MiB |
| Prompt cache | 8,192 MiB |
| Graph splits | 3 |
ベンチマーク結果
Token Generation
| フェーズ | KV cache | 速度 |
|---|---|---|
| 初期 | 約2.7k tokens | 105.9 t/s |
| 序盤平均 | 25k tokens 未満 | 77.5 t/s |
| 中盤平均 | 27k-47k tokens | 64.7 t/s |
| 終盤平均 | 54k-56k tokens | 54.3 t/s |
- 平均: 71.9 t/s
- 最大: 105.9 t/s
- 最小: 53.9 t/s
- 劣化率: 2.7k から 56.4k context で -49%
Prompt Processing
| 条件 | 速度 |
|---|---|
| Cold start (2,493 tokens) | 4,067 t/s |
| Cache hit 平均 | 911 t/s |
10 点サンプル
| KV cache | TG |
|---|---|
| 2.7k | 105.9 t/s |
| 18.3k | 79.2 t/s |
| 19.1k | 78.8 t/s |
| 21.2k | 77.1 t/s |
| 23.7k | 75.0 t/s |
| 27.2k | 71.4 t/s |
| 38.4k | 63.8 t/s |
| 46.6k | 58.9 t/s |
| 53.9k | 54.7 t/s |
| 56.4k | 53.9 t/s |
サンプルでは context が長くなるにつれて速度が下がりました。56kでも生成は続きました。100k超は未計測なので、長時間運用にはタスク分割を検討する必要があります。
何が生成されたか
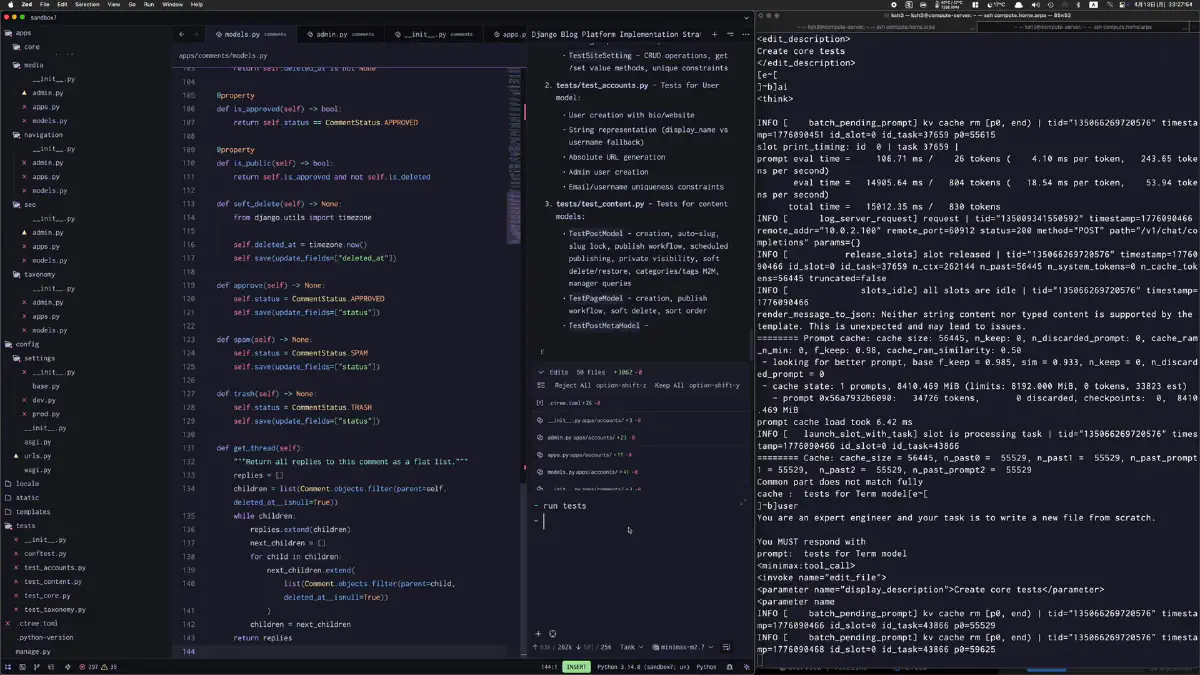
WordPress 風 Django ブログ/CMS の仕様を渡し、約14分で次のファイルを生成しました。
- Django config 一式
accounts,content,core,media,comments,navigation,seo,taxonomyの 8 app- 各 app の model, admin, app config
- テスト群
- Gitea issue 作成 API 統合
- 50 以上のファイル
edit_file の path prefix の問題に気づき、実行中に修正する挙動もありました。生成物全体の独立したQA結果は示していません。
セッション画面
M2.5との条件と結果の違い
MiniMax-2.5 の検証 では、96GB GPU 1枚 + Expert Offload で34–37 t/sを維持しました。長い context でも TG は比較的安定していました。
M2.5は single GPU + Expert Offload、M2.7は dual Blackwell + smol-IQ3_KSで、同一条件ではありません。主観では M2.7 の tool use と出力に余裕を感じました。今回の tokenUsage は約66kで、M2.5は約122kだったという記憶です。半分程度という比較には、この記憶の不確かさが残ります。
常用を見送る判断はライセンスによるものです。community の議論も見ながら、限定したベンチマークだけを行いました。
M2.5とM2.7の利用条件
M2.7 の modified-MIT は商用利用を自由に認めていません。一方、2026年3月に読んだ M2.5 の条件では、同じ制限はないと判断していました。商用に関係する構成は M2.5 を fine-tuning する案もありますが、使用時の条件確認は必要です。
- ベンチマーク、学習、個人用のローカル検証が候補です
- 業務、顧客案件、社内の商用開発には、そのまま導入していません
- 常用モデルには採用していません
生成物や副産物に制限が及ぶ範囲も読み切れず、その不確かさを含めて常用を見送りました。
計測方法
計測の元データは動画です。ログを保存しなかったため、後から値を読み取りました。
Claude に該当フレームを渡して PP/TG を拾ったので、読み取り誤差の可能性があります。数値の元の表示は動画で確認できます。