
Qwen3.6-27BのNVFP4・MTP・LoRA実測
Qwen3.6-27B NVFP4+MTPをvLLMで測定。動的LoRAを使うLLM導入の速度、VRAM、tool errorと未完走の結果を記録します。
SGLang FP8 + LoRA動的切替ではTGが20-30 tok/sでした。EAGLEを使うにはマージドモデルかフルチューンモデルが必要と考えましたが、複数インスタンスでは重み x N のVRAMが増えます。そこで sakamakismile/Qwen3.6-27B-Text-NVFP4-MTP をvLLMで動かし、MTPとLoRA動的切替をエージェント側で制御する構成を検証しました。
動画リンク: https://www.youtube.com/watch?v=HP1Bl-h45bE
構成
vLLM v0.19.2rc1(V1)で sakamakismile/Qwen3.6-27B-Text-NVFP4-MTP を動かしました。RTX PRO 6000 Max-Q Blackwell 96GB x 2、TP=2です。TP=1も試しましたが、ここでは省略します。num_speculative_tokens=3、FP8 KV、Prefix Caching、Chunked Prefillを有効にしました。
  podman run --rm -it \
  --name naughty \
  --pull=always \
  --publish 8001:8001 \
  --device nvidia.com/gpu=all \
  --shm-size=8g \
  -v /mnt/data/models/lora-adapters:/loras:ro \
  -v /mnt/data/models:/hf/hub:ro \
  -e HF_HOME=/hf \
  -e HF_HUB_CACHE=/hf/hub \
  -e HF_HUB_OFFLINE=1 \
  -e TRANSFORMERS_OFFLINE=1 \
  -e TORCH_CUDA_ARCH_LIST=12.0 \
  -e VLLM_TARGET_DEVICE=cuda \
  -e VLLM_USE_V1=1 \
  -e VLLM_FLASHINFER_MOE_BACKEND=throughput \
  -e VLLM_USE_FLASHINFER_MOE_FP4=1 \
  registry.home.arpa/vllm-openai:cu130-nightly-fe9c3d6 \
  sakamakismile/Qwen3.6-27B-Text-NVFP4-MTP \
    --host 0.0.0.0 \
    --port 8001 \
    --served-model-name Qwen3.6-27b-NVFP4 \
    --trust-remote-code \
    --language-model-only \
    --quantization modelopt \
    --enable-prefix-caching \
    --dtype auto \
    --tensor-parallel-size 2 \
    --gpu-memory-utilization 0.88 \
    --max-model-len 262144 \
    --max-num-seqs 8 \
    --kv-cache-dtype fp8 \
    --reasoning-parser qwen3 \
    --enable-auto-tool-choice \
    --tool-call-parser qwen3_coder \
    --default-chat-template-kwargs '{"enable_thinking": true}' \
    --speculative-config '{"method":"qwen3_5_mtp","num_speculative_tokens":3}' \
    --override-generation-config '{"temperature":1.0,"top_p":0.95,"top_k":20,"presence_penalty":0.0,"repetition_penalty":1.0}'
初期化は合計約102秒でした。モデルロードはtarget 1.45s / drafter 0.21s、torch.compile は45.95s / 6.97s、CUDA Graph Captureは2sです。FB Usedは87.6 GB/GPU、Freeは9.69 GB/GPU、KVは1,115,200 tokensでした。
LoRA アダプタ (axolotl, bf16)
axolotlでbf16学習したLoRAを、NVFP4ベースへ実行時に適用しました。
  base_model: /mnt/data/models/models--Qwen--Qwen3.6-27B/snapshots/5d316fa25c3a0b6251198e9e7a94e863a435536a
tokenizer_type: AutoTokenizer
trust_remote_code: true

datasets:
  - path: datasets/familiar-sft-v2/train.jsonl
    type: chat_template
    ds_type: json
    field_messages: messages
    roles_to_train:
      - assistant
test_datasets:
  - path: datasets/familiar-sft-v2/val.jsonl
    type: chat_template
    ds_type: json
    field_messages: messages
    roles_to_train:
      - assistant

chat_template: tokenizer_default
sequence_len: 16384
sample_packing: false
pad_to_sequence_len: false

adapter: lora
lora_r: 16
lora_alpha: 32
lora_dropout: 0.05
lora_target_modules:
  - q_proj
  - k_proj
  - v_proj
  - o_proj
  - gate_proj
  - up_proj
  - down_proj

output_dir: /mnt/data/models/lora-adapters/qwen3.6-27b-familiar-bf16-lora
save_safetensors: true
save_total_limit: 2
save_steps: 50
eval_steps: 50
logging_steps: 5

micro_batch_size: 1
gradient_accumulation_steps: 8
num_epochs: 2
learning_rate: 5.0e-5
lr_scheduler: cosine
warmup_ratio: 0.05
optimizer: adamw_torch

bf16: true
fp16: false
tf32: true
load_in_8bit: false
load_in_4bit: false
gradient_checkpointing: true
/mnt/data/models/lora-adapters を :ro でマウントし、起動後に適用しました。seq=4ではLoRAあり8595 tok/s、なし85105 tok/sでした。動画と以下の本計測はLoRAなしx2です。
スループット実測
Djangoに近いタスクを流し、vLLMログの10秒間隔の値を集計しました。
Generation Throughput (TG)
- 平均 (全体): 155.7 tok/s
- 平均 (アクティブ, >50 tok/s): 161.4 tok/s
- 最大: 190.4 tok/s
- 最小: 32.6 tok/s
- アクティブサンプル: 43 / 45
Prompt Processing (PP)
- 平均 (アクティブ, >0): 831.2 tok/s
- 最大: 2,773.3 tok/s
- 最小 (アクティブ): 226.6 tok/s
- アクティブサンプル: 28 / 45
MTP 投機デコード
- Mean Acceptance Length (MAL) 平均: 3.64
- MAL 最大: 4.00
- Draft Acceptance Rate 平均: 87.9%
- Draft Acceptance Rate 最大: 100.0%
- Draft Acceptance Rate 最小: 70.3%
Caching
- Prefix Cache Hit Rate: 68.7% → 91.2% (最終)
- GPU KV Cache Usage 最大: 2.1%
繰り返すtool callでprefix cacheが育ち、後半は91%になりました。max_num_seqs=8 でも単一ストリームに近い使い方だったため、KV使用率は最大2.1%でした。
GPU 状態 (DCGM)
実行中のGrafana DCGMから読んだ値です。
- GPU Utilization: 92% / 93%
- Memory Utilization: 53% / 43%
- Temperature: 84°C / 85°C
- Power: 281 W / 299 W
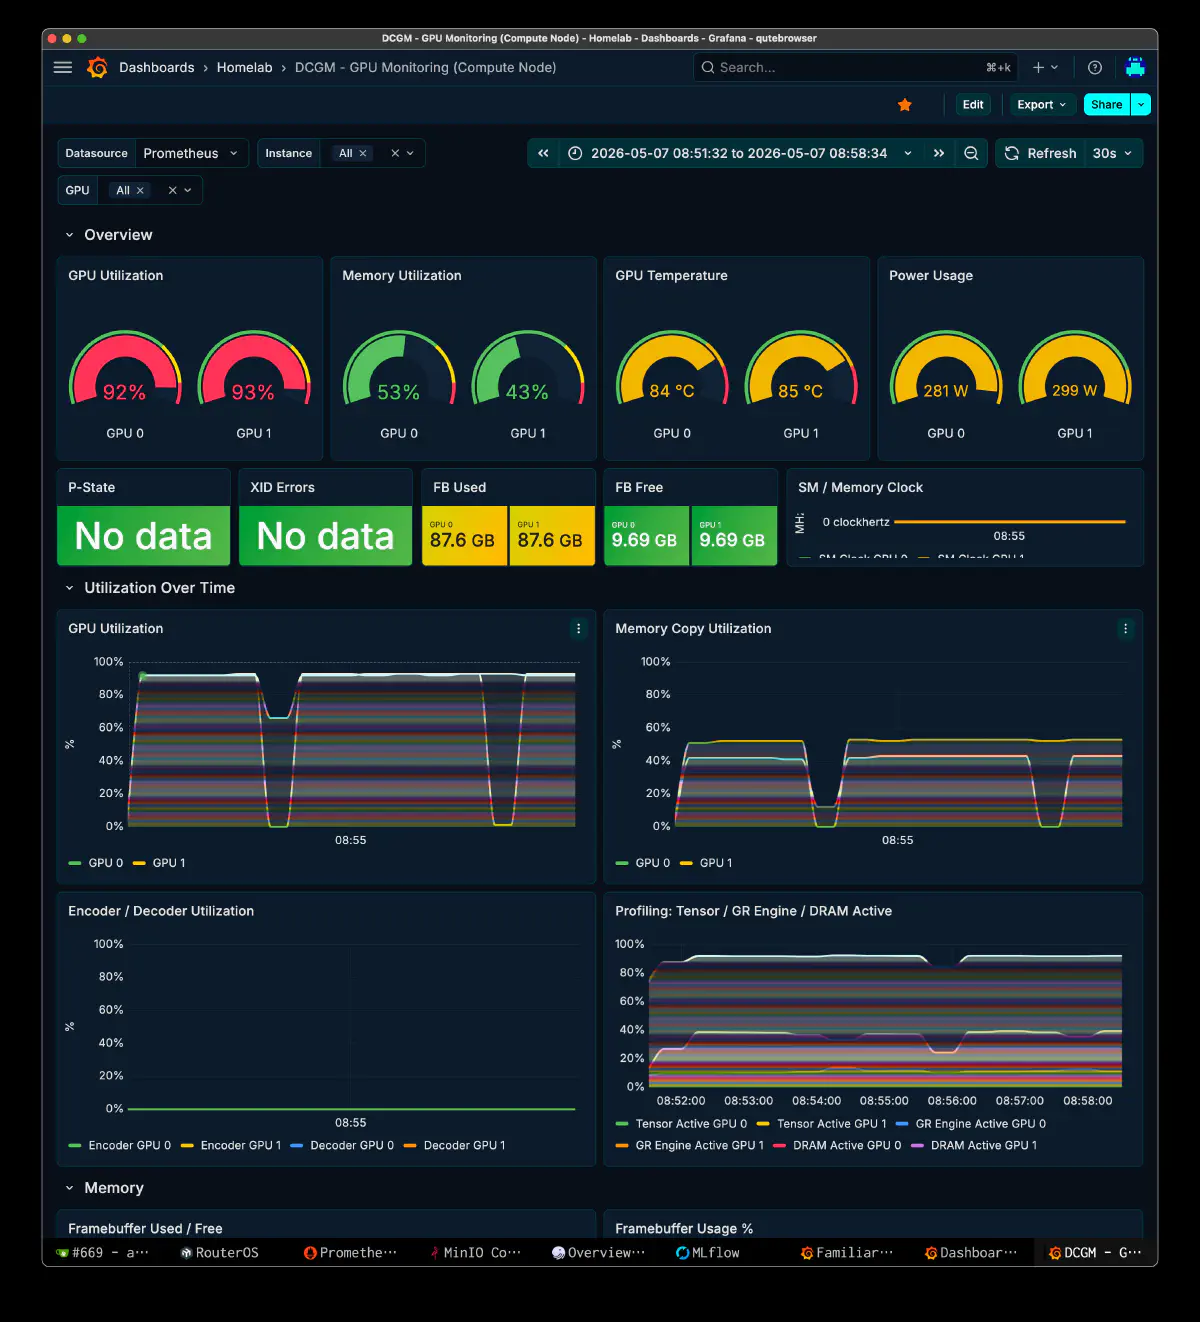
エージェント実タスクでの比較: vLLM NVFP4 vs SGLang FP8
自作エージェントで、vLLM NVFP4+MTP(alias: naughty)とSGLang FP8(alias: frisky)に同ジャンルのタスクを渡しました。Familiar Tool Callsの各1セッションの集計です。
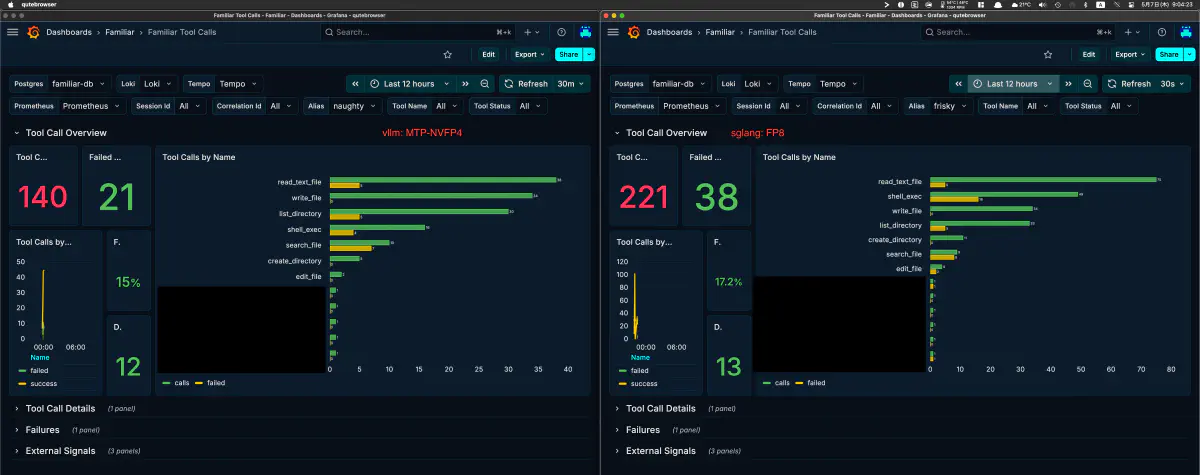
- vLLM NVFP4: 140 calls / 21 failed (15.0%)
- SGLang FP8: 221 calls / 38 failed (17.2%)
失敗率の差は約2ポイントでした。ただし各1セッションだけで、統計的な比較ではありません。後半のNVFP4は出力が鈍って未完走、FP8は完走しました。動画にもNVFP4のtool errorが見えます。
Prefix Cache の挙動が独自 CTXManager で割れた件
CTXManager で合成した同じworkloadでも、vLLMだけprefix cache hitが0のままの時間帯がありました。SGLangとik_llamaは0.8-1.0でした。合成側のキーより、vLLMのcache挙動か起動オプションを疑っていますが、原因は未確定です。
所感
- SGLang FP8(約30GB)で動的LoRAを優先し、EAGLEを使わない場合は20-30 tok/sでした。マージド / フルチューンモデルをインスタンス別に置く案は、重み x N のVRAMが制約です。
- vLLM MTP-NVFP4は約15GB + LoRAの重みで、複数インスタンスのLLM導入を考えやすくなります。contextもインスタンスごとに分けられます。LMCacheeと組み合わせたいという構想もあります。
- LoRAありの平均は約90 tok/s、なしは161 tok/sという記録です。SGLang FP8 + LoRAの20-30 tok/sより3-4倍でした。品質評価は未実施で、tool error率に大きな差はありませんでした。
- 当時はLMCacheのNVFP4が未対応で、併用はできませんでした。tracking issue: https://github.com/LMCache/LMCache/issues/3163