Step-3.7-Flashのローカル並列エージェント開発
Step-3.7-Flash-NVFP4で6ロールを並列実行し、予約APIと管理画面を生成。AIシステム開発の観測、速度、手修正の結果を記録します。
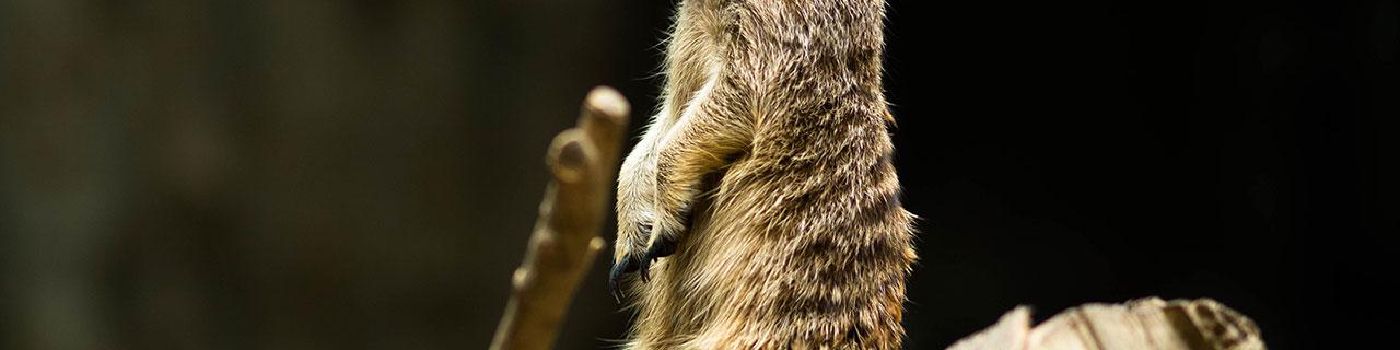
Step-3.7-Flash-NVFP4と自作基盤familiarで、レストラン予約APIとRBAC対応の管理システムを生成しました。6ロールを並列に動かし、推論と計測はローカルで行っています。外部APIは使っていません。
タスク分解と依存解決は安定していました。約70%動く状態までは速い一方、後半はGuardの影響もあり修正が増えました。
動画リンク: https://www.youtube.com/watch?v=L6ryJhd2EmA
直近でやったこと: 生成トークン見積りとstream continuation
dwarfstarのコミットを参考に、生成tokenの見積もりとbudget制御を加えました。BackendGenerationTokenController を internal/domain/agent に分け、length capで切れた生成を継続promptで拾うstream continuationも導入しました。
直前のセッションはXML/TOMLのparse error修復を繰り返していました。事後処理だけでなく、悪化する前に回復用の状態を合成する方が良いと感じたためです。dwarfstarはDeepSeek4専用の単一モデルへ進み、私は置換可能なOSSマルチモデルを選ぶ方針ですが、課題は似ています。
コントローラは送信を行わず、観測と判断だけを担当します。役割は4つです。
- OpenAI互換のストリームチャンクを観測し、既存のトークン推定器で生成済み補完トークンを見積もる
max_tokens/コンテキストウィンドウ上限に対する超過を検知する- continue / cutoff / repair-needed / terminalといった制御判断を返す
- tool-call finish時に壊れた引数、malformed tool argument(これはthinkingに入ってたものをサルベージする考えを見て良いなと思った)を検出する
prompt合成、継続・修復prompt、最終応答、telemetry集約は外側のエージェントに残しました。コントローラはストリームから判断を返す状態機械です。
ロールごとのsamplingも調整しました。continuationでlength capから戻れるため、max_output_tokens を下げてsamplingを狭めました。testerは repetition_penalty 1.08 と低いtemperature / top_pで、長いreasoningと検証の空回りを抑えます。
セットアップ
| 項目 | 内容 |
|---|---|
| Orchestrator | Step-3.7-Flash-NVFP4 on vLLM |
| Framework | 自作Go (Gin) + Rust製MCP群 |
| roles | orchestrator / planner / coder / tester / reviewer / integrator |
| Task | Restaurant Domain Spec(レストラン予約ドメイン) |
| CPU | AMD EPYC 9175F 16C |
| GPU | NVIDIA RTX PRO 6000 Blackwell Max-Q 96GB x 2 |
基盤は最大3モデルを連携できます。今回はStep-3.7-Flashだけで、orchestratorとworkerのrole sessionを動かしました。経験上は少ないモデルの方が成功率とtoken costが良く、学習分布の差が文脈共有を難しくすると考えています。複数にするなら疎結合のroleか、10B以下の専用モデルをRust Ort/onnxで使う案があります。
vLLMの設定です。
  Exec=/models/snapshots/36afbf6e15100cdc2d7a5b79d7e95d276ed33679 \
    --host 0.0.0.0 \
    --port 8000 \
    --served-model-name grandpa \
    --gpu-memory-utilization 0.92 \
    --tensor-parallel-size 2 \
    --max-num-seqs 8 \
    --kv-cache-dtype fp8 \
    --max-model-len 147456 \
    --disable-cascade-attn \
    --enable-expert-parallel \
    --trust-remote-code \
    --quantization modelopt \
    --reasoning-parser step3p5 \
    --tool-call-parser step3p5 \
    --enable-auto-tool-choice \
    --enable-expert-parallel \
    --async-scheduling
Grafana + Prometheus / Loki / PostgreSQL / Vector / Tempo / Alloyで観測しています。ダッシュボードを見ながらClaude/Codexにデバッグを任せ、結果を実装へ反映します。
vLLM intervalベンチ
| window end | completed reqs in window | running | PP tok/s | TG tok/s | KV usage | prefix hit |
|---|---|---|---|---|---|---|
| 11:39:14 | 3 | 3 | 3242.7 | 153.9 | 1.8% | 81.5% |
| 11:39:24 | 4 | 3 | 140.7 | 196.7 | 1.8% | 81.7% |
| 11:39:34 | 2 | 2 | 34.7 | 201.1 | 1.5% | 81.7% |
| 11:39:44 | 2 | 2 | 217.3 | 154.6 | 1.5% | 81.8% |
集計値です。
| metric | avg | median | min | max |
|---|---|---|---|---|
| PP tok/s | 908.9 | 179.0 | 34.7 | 3242.7 |
| TG tok/s | 176.6 | 175.7 | 153.9 | 201.1 |
| Running | 2.5 | 2.5 | 2 | 3 |
| Prefix hit | 81.7% | 81.7% | 81.5% | 81.8% |
seq=8の設定ですが、soft cap 7で動かしたため、バッチに近い値です。
シングルリクエストは別で計測して動画の説明にベンチのせています。
動画リンク: https://www.youtube.com/watch?v=NDhzjHW-2SM
走らせている様子
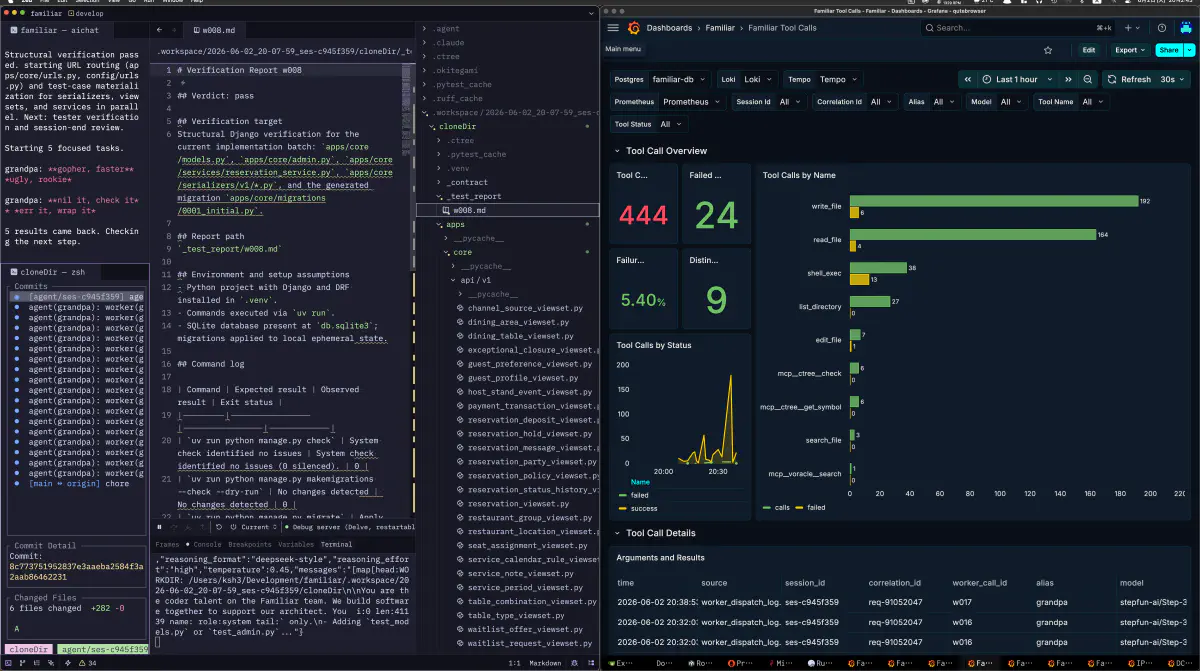
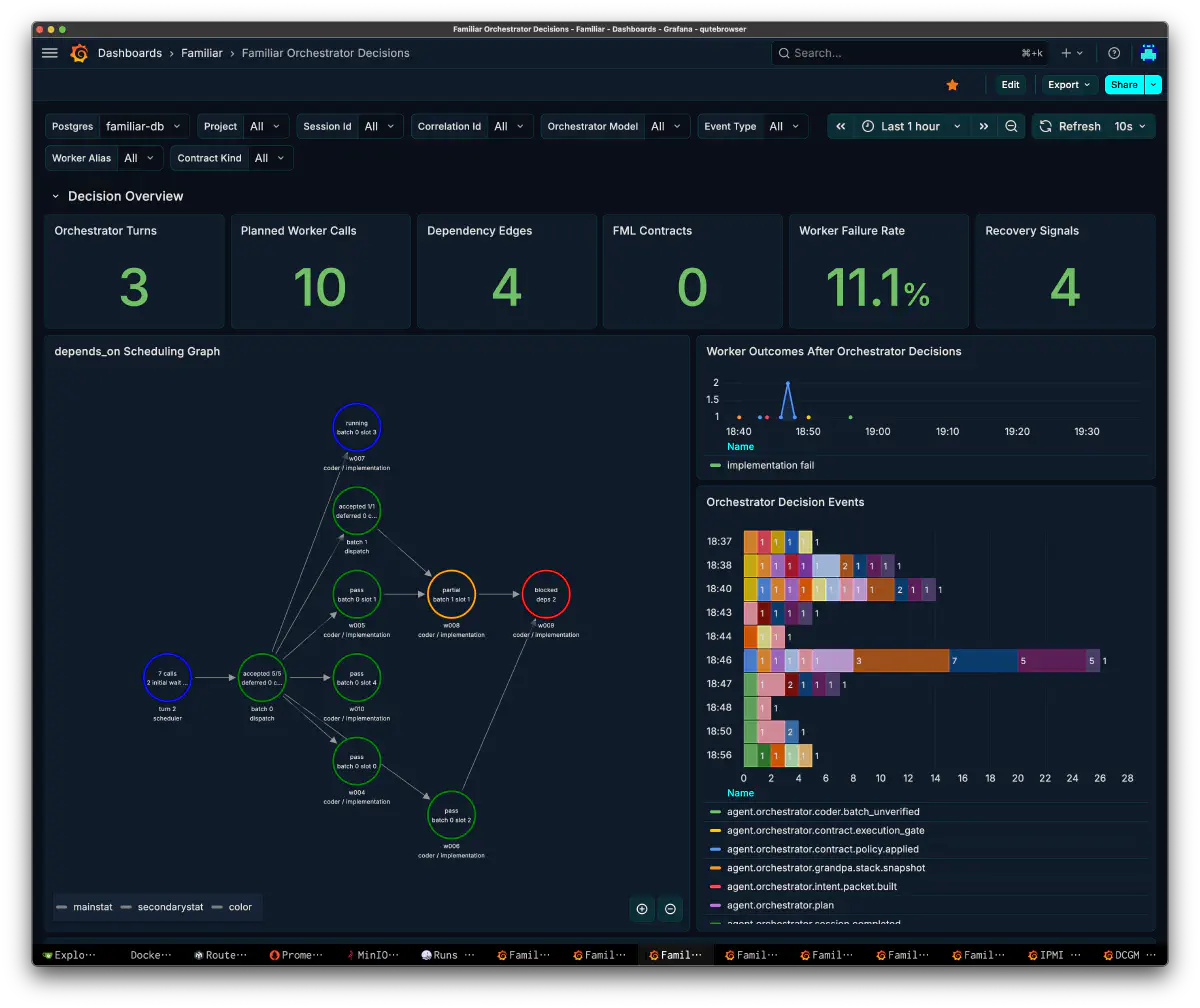
Chat DAG: 会話の形
datastore確定前の会話をvector/lokiでDAG表示します。user request -> orchestrator -> Scheduler Decisions -> Dependencies -> worker -> orchestrator の経路で、turnからworkerへの分岐を追います。
Orchestrator Decisions: 判断の中身
判断を分けて表示するダッシュボードです。
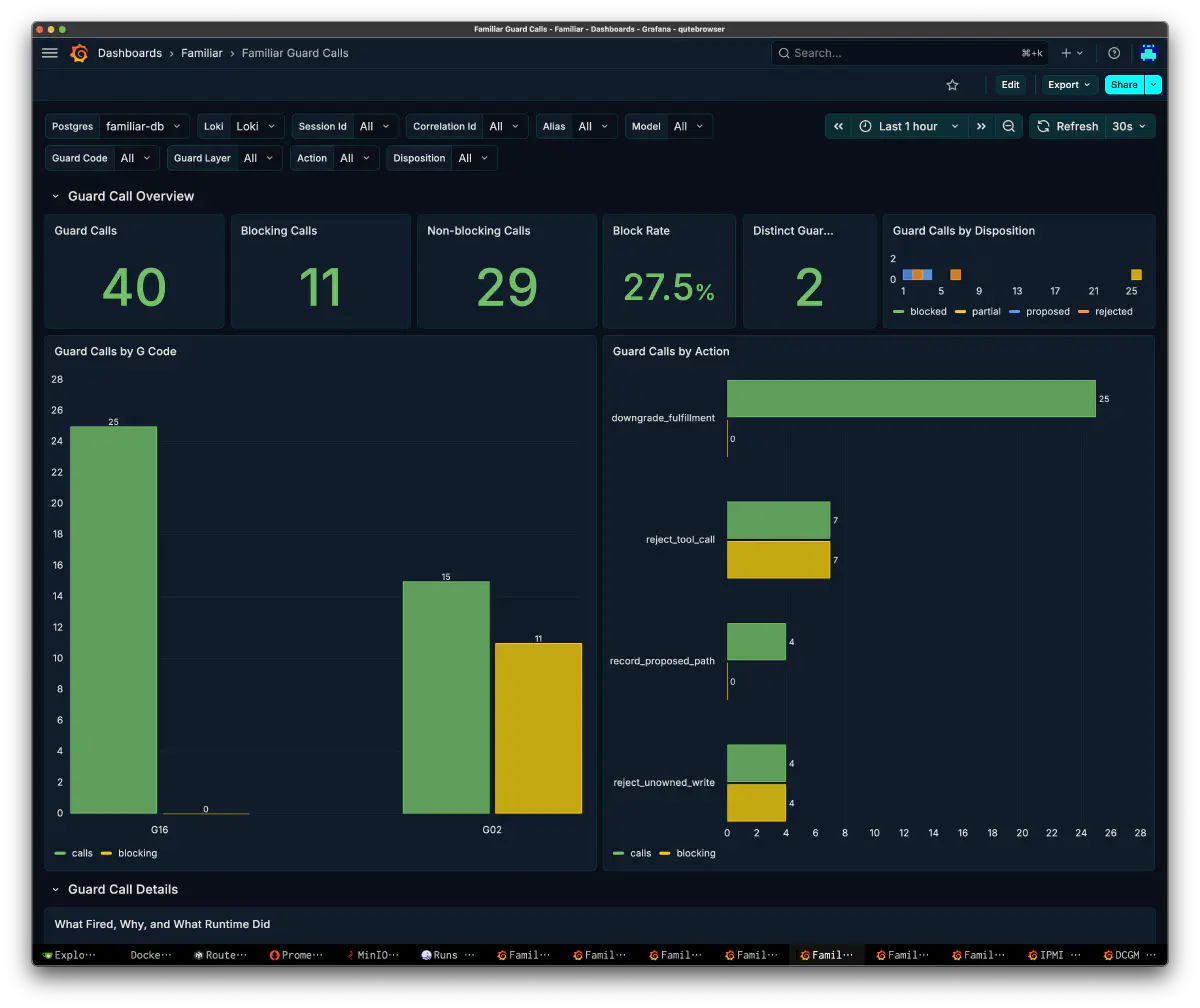
Guard Calls: やってはいけないことをガード、リカバーする
Guardが実行時の逸脱を止め、または回復させます。今回は40 calls、blocking 11、non-blocking 29、Block Rate 27.5%でした。
| Action | calls | blocking |
|---|---|---|
| downgrade_fulfillment | 25 | 0 |
| reject_tool_call | 7 | 7 |
| record_proposed_path | 4 | 0 |
| reject_unowned_write | 4 | 4 |
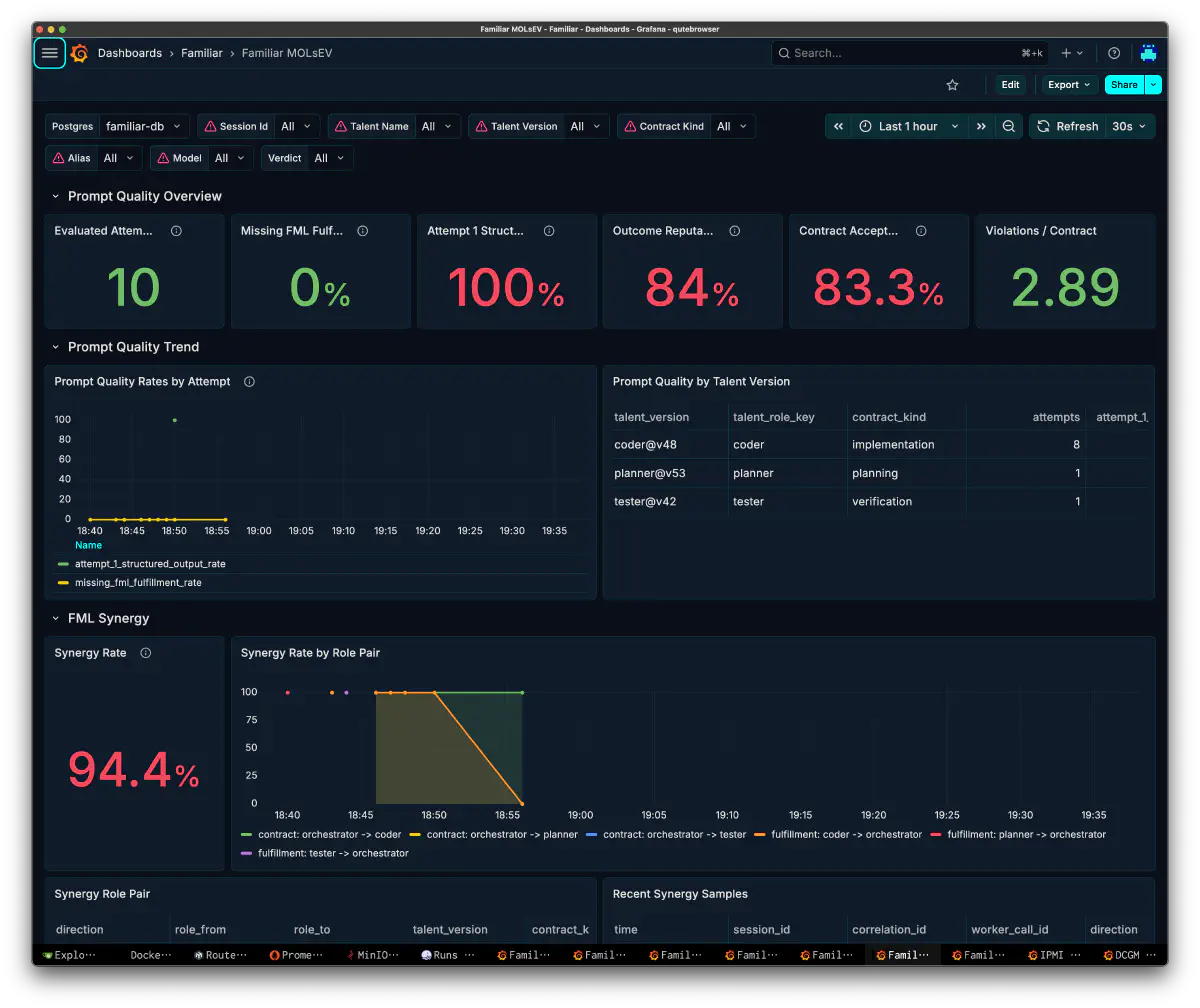
MOLsEV: プロンプト品質と役割間Synergy
結果
完全に動くまで約1時間、約70%の状態までは約24分でした。最後の修正に時間がかかっています。
7件の成果物のうち、手直しなしでコマンド起動が通ったのは約2件でした。
- 管理画面、Django adminがそのまま使える
- APIが動作する
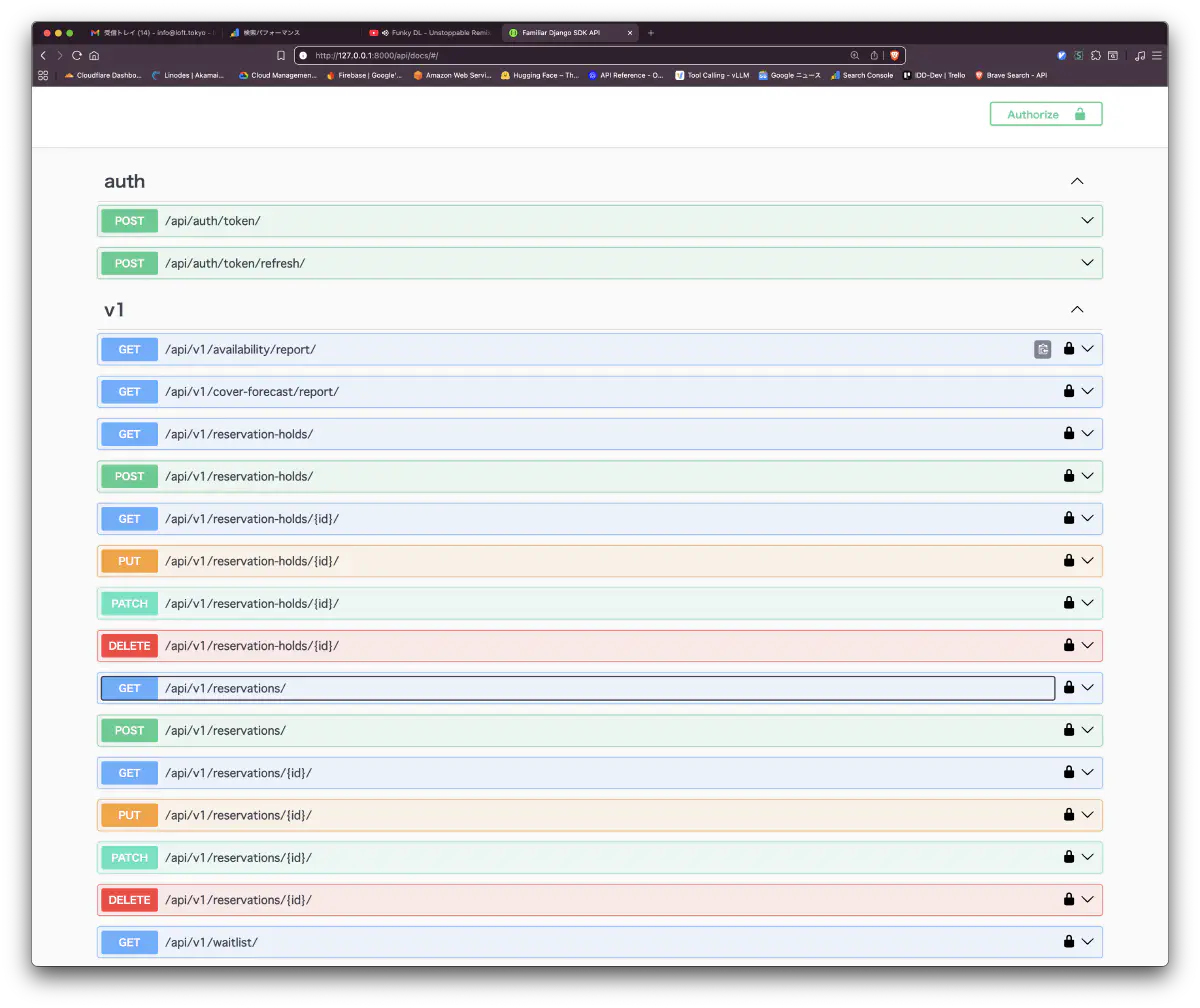
api/docs、Swagger UIが生成され、authとv1リソースが一通り並ぶ- seedで初期データが入っている
残る5件には軽微な修正が必要でした。api/docs には auth/token、reservations、reservation-holds、waitlist、availability/report、cover-forecast/report が並び、CRUDとreportを扱っていました。
所感
Step-3.5に続き、3.7もorchestratorに向く印象です。Attempt-1の構造化出力は100%でした。TG平均176.6、中央値175.7、範囲153.9-201.1 tok/s、prefix cache hitは81.5-81.8%です。context window managerは70-90%を保持し、自作ctxMgrでもrole session間でcacheを育て、80%前後を保てました。
この環境ではNVFP4のMTPは使えませんでした。SGLang cu13はSM100までの対応というエラーで起動せず、ik_llamaのGGUFもクラッシュと品質が安定しませんでした。
基盤とダッシュボードの開発は約7割をClaude/Codexに任せ、主に設計とアウトライン実装を依頼しています。散歩中の案や観測から得た仮説を実験し、修正する流れです。業務システム開発にエージェントを使う場合も、挙動を確認できる観測基盤を先に用意する方が作業しやすいと感じました。