
ctreeのAST解析とMCP連携
Rust製ctreeでコード構造と変更をハッシュ付きの要約にしました。LLM導入による開発支援に向け、strong/weakの解析範囲とpathfinder・Serenaの使い分けを説明します。
ctreeで取得する情報
Rust で AST ベースの解析器 ctree を作りました。ローカル LLM にコード構造を要約して渡し、必要なシンボルだけを詳しく読むためのツールです。
よく使う言語を対象に、ハッシュ付きスナップショットで実装と依存の変更を追います。ファイルごとに解析の詳しさを変えられます。
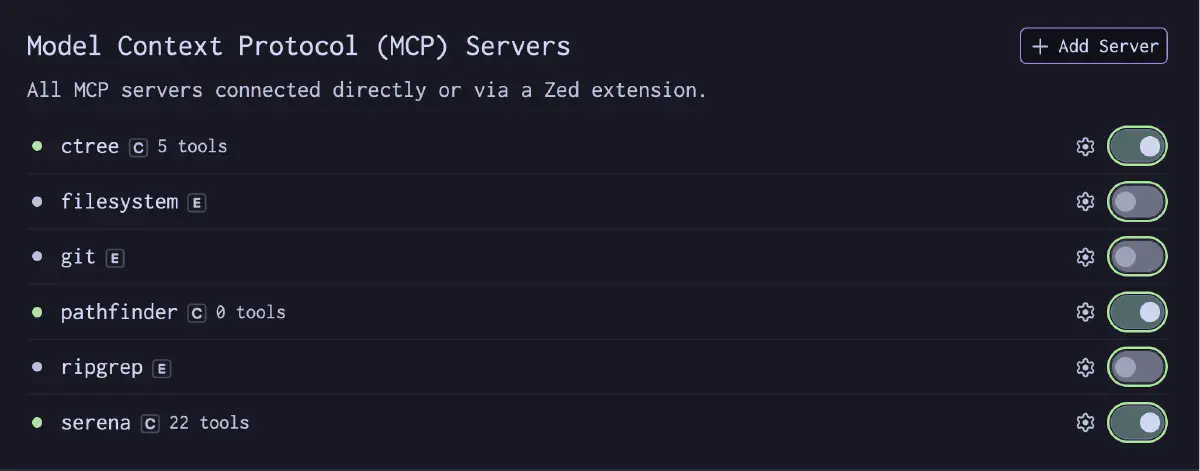
ctree の要約から対象を選び、Serena の find_symbol で定義を読みます。pathfinder はファイルパスを解決します。
LLM導入の開発支援で、入力する context を減らすための構成です。
Serenaの前に構造を読む
Serena で全シンボルを先に読むと context が増えます。必要な定義を読む前に、構造の要約が必要でした。
ctree を Serena の前段に置きます。
| 層 | ツール | 役割 |
|---|---|---|
| ファイル操作の精度向上 | pathfinder | パス解決の失敗をリカバリし、コンテキスト膨張を防ぐ |
| コードベースの浅い俯瞰 | ctree | 実装と依存の変化をハッシュベースでコンパクトに提供 |
| シンボルの精密な解析 | Serena | find_symbol で特定シンボルの定義・参照を取得 |
pathfinder がパス、ctree が構造、Serena が定義を扱います。独立した3つの MCP ツールです。
CLI
  $ ctree --help
Generate annotated tree + symbols + compact ctx

Usage: ctree [OPTIONS] [COMMAND]

Commands:
  init
  reset
  check
  clean
  help   Print this message or the help of the given subcommand(s)

Options:
      --mcp                    Run as MCP stdio server
      --config <CONFIG>        Config file path (default: .ctree.toml if exists)
      --root <ROOT>            Scan root path [default: .]
      --syntax <SYNTAX>        [possible values: go, rust, python, typescript,
                                csharp, dart, lua, awk, shell, kotlin, swift,
                                markdown, html]
      --include <INCLUDE>      Include globs
      --exclude <EXCLUDE>      Exclude globs [default: **/tmp/**,**/testdata/**,
                                **/.git/**,**/vendor/**]
      --strong <STRONG>        Strong scope globs
      --weak <WEAK>            Weak scope globs
      --sw <SW>                Max annotation words per strong file line [default: 12]
      --ww <WW>                Max annotation words per weak/symbol-only file line [default: 3]
      --reasoning <REASONING>  Reasoning level [possible values: high, medium, low]
      --template <TEMPLATE>    Output template [possible values: plain, hugo, jinja]
  -h, --help                   Print help
ASTで解析する範囲
対応言語
tree-sitter の AST parser を、よく使う言語に絞って実装しました。
Go, Rust, Python, TypeScript/JavaScript, Dart, Kotlin, Lua, Shell, Awk, C#, Swift, Markdown, HTML
アプリ本体に加え、shell script と文書も同じ仕組みで扱います。
strong / weak スコープ
ファイルを strong(詳細)と weak(概要)に分けます。
  [ctree]
watch = "rust"
root = "."
include = ["src/**/*.rs", "tests/**/*.rs"]
exclude = ["**/tmp/**", "**/testdata/**", "**/.git/**", "**/vendor/**", "**/target/**"]
strong = ["src/**"]
weak = ["tests/**"]
sw = 24
ww = 5
reasoning = "medium"
strong は詳細な symbol 要約、weak は短い概要です。設定で確認する範囲を切り替えます。
全ファイルの情報量を揃えず、詳しく見る対象を指定するためです。
reasoning プリセット
reasoning = "high" | "medium" | "low" で要約の詳しさを変えます。
| reasoning | 用途 |
|---|---|
| high | 小規模プロジェクト、詳細な解析が必要な場面 |
| medium | 通常の開発作業(デフォルト) |
| low | 大規模モノレポ、トークンを最小限に抑えたい場面 |
ハッシュベースのスナップショット
strong / weak の pattern と reasoning から決定論的にハッシュを作り、snapshot ディレクトリを分けます。
  .ctree/
  rust/
    e83adb52/          ← スコープ設定のハッシュ
      snapshots/
        .baseline.txt
        rev/
          0001.txt
          0002.txt
範囲を切り替えても過去の snapshot は残ります。元の設定に戻すと再生成せずに利用できます。
MCP ツール
5つの MCP ツールを公開します。
| ツール | 役割 |
|---|---|
check | スナップショットの生成・更新。最新の差分を返す |
get_baseline | コードベース全体のアノテーション付きツリー + シンボル要約を返す |
get_revs | リビジョン履歴(何が変わったか)を返す |
get_text | ハッシュからシンボルや依存のテキストを取得する |
get_depends | シンボル間の依存関係を探索する |
実際の出力
ctree check — スナップショット生成と差分検出
  $ ctree check --syntax rust
frequency=always
action=generate
latest_before=0001
latest_after=0001
(no new rev)
変更がなければ (no new rev)、変更があれば新しい revision と symbol のハッシュを返します。
初回生成の出力です。
  $ ctree check --syntax rust
frequency=always
action=generate
latest_before=
latest_after=0001
rev_file=.ctree/rust/{scope_hash}/snapshots/rev/0001.txt
hashes={hash1},{hash2},{hash3},...

{hash1}
source=symbol kind=module name=... scope=strong path=src/.../main.rs line=2
mod ...;
--{hash1}
{hash2}
source=symbol kind=function name=... scope=strong path=src/.../mcp.rs line=164
fn ...(args: ...) -> Result<...> {
--{hash2}
ハッシュを get_text に渡すと symbol の本文を読めます。
get_baseline — コードベースの浅い俯瞰
get_baseline はファイルツリー、symbol 要約、token 推定値を返します。ソース全文を送らず、ここから選んだ定義を Serena の find_symbol で読みます。
自社の LLM pipeline で使っており、出力形式の詳細は公開していません。
get_revs — リビジョン差分
symbol と依存の追加・削除を revision 差分で返します。get_text にハッシュを渡すと本文と依存の詳細を取得できます。
この出力形式の詳細も非公開です。
3つのツールの使い分け
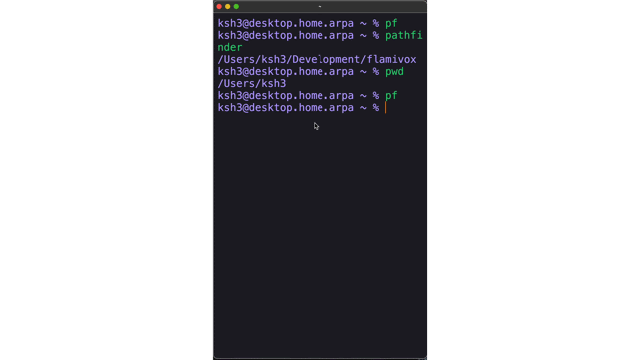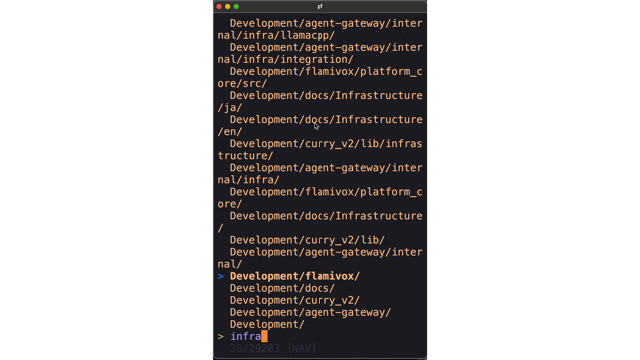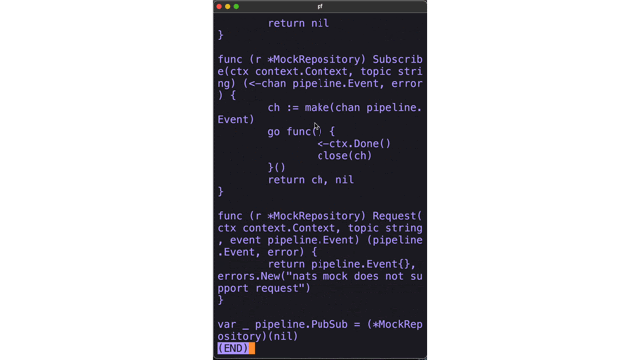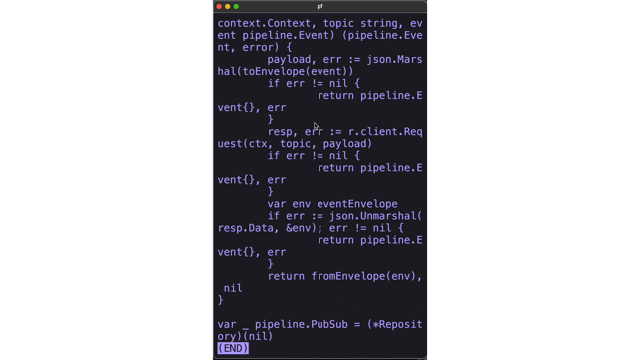
pathfinder — パス解決の失敗をリカバリする
pathfinder は、誤ったディレクトリ名から実在するパスの候補を返します。
  path_resolve:
  check_path: "content/ja/docs/tech/infrastrcture/podman-quadlet-systemd-ubuntu.md"
                                      ^^^^^^^^^^^ typo
  →  resolved: "content/ja/docs/tech/infrastructure/podman-quadlet-systemd-ubuntu.md"
  $ pathfinder --help
pathfinder — semantic path finder & MCP resolution server

USAGE
    pathfinder [OPTIONS]          Interactive semantic directory finder (default).
    pathfinder --mcp [OPTIONS]    Start as an MCP server.

FINDER OPTIONS
    --include-builds    Include build/artifact dirs (target, dist, …).

MCP OPTIONS
    --root <PATH>       Add a project root directory to watch and index.

GENERAL OPTIONS
    -h, --help          Print this help message and exit.
    -V, --version       Print version, model, and PCA config.

MCP TOOLS
  1. path_resolve        Resolve a failed file path to the best match.
  2. tool_retry_with_resolve  Resolve + retry the operation in one call.
  3. roots_list          Return configured root directories.
  4. reindex_paths       Force a full index rebuild.

ENVIRONMENT VARIABLES
    PF_MCP_INFERENCE    Inference mode: "general" (default) or "code".
    Models (both INT8 quantized):
      general → mxbai-edge-colbert (17M, 48-dim)
      code    → lateon-code-edge (17M, 48-dim)
想定ワークフロー
  1. pathfinder  → LLM のパス typo を解決(ENOENT → tool_retry_with_resolve)
2. ctree check → スナップショット更新、変更されたシンボルのハッシュを取得
3. get_baseline → コードベースの浅い俯瞰を得る
4. 関心のあるシンボルを特定 → Serena の find_symbol で定義・参照を深掘り
5. get_revs + get_text → 変更されたシンボルの詳細を取得
独立したツールから、要約、対象の選択、定義の順に情報を取得します。
8K〜32Kのローカル LLM でも、使う情報を選んで context の消費を抑える狙いです。
注意事項
- 対象は対応する言語で、汎用の静的解析器ではありません
get_baseline/get_revsの形式は、自社 LLM pipeline の一部として非公開です- ONNX / ColBERT などの ML 推論は見送りました。strong / weak で範囲を管理し、決定論的な設計を保っています
- MCP 2024-11-05に対応し、Claude Code / Zed Editor などから使えます