
homelabで使う9本のRust製MCPサーバー
familiarを支える検索、コード解析、DB参照など9本のRust製MCPサーバーを紹介します。LLM導入とAIシステム開発に使う責務分担・コンテキスト制限・非同期連携の設計です。
familiarで使う9本のMCPサーバー
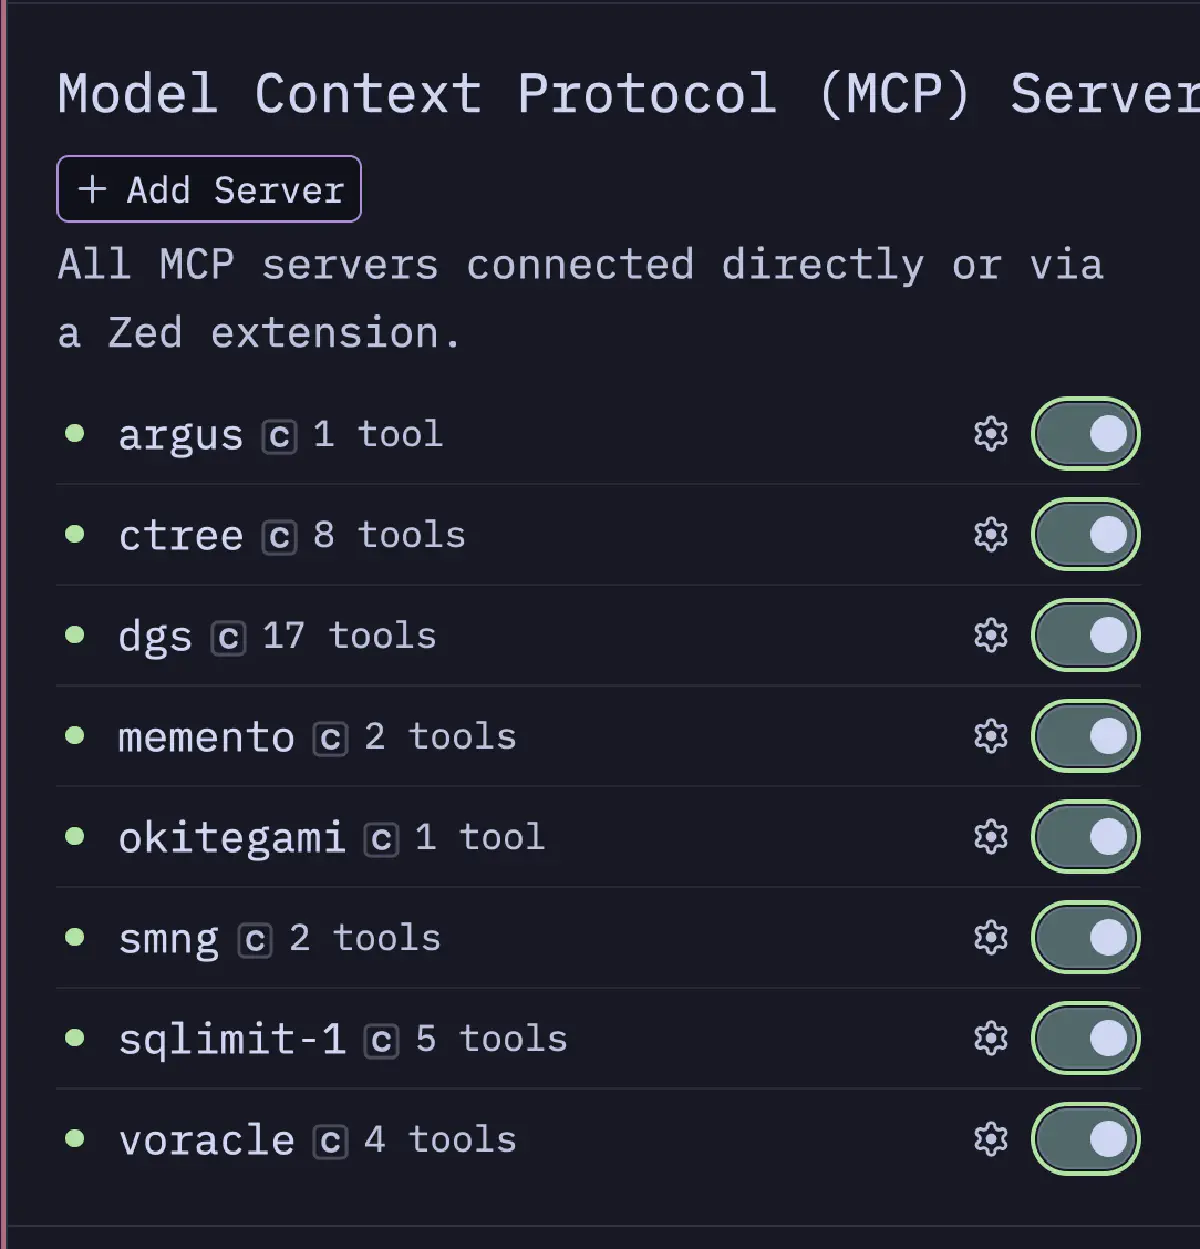
familiarのオーケストレーションでは、記録時点で9本のMCPサーバーを使っています。すべてRust製のstdio JSON-RPC 2.0です。1日に1-2本ほど作って試し、残ったものを改良してきました。LLMを開発作業に組み込むための設計と用途をまとめます。
homelabの構成
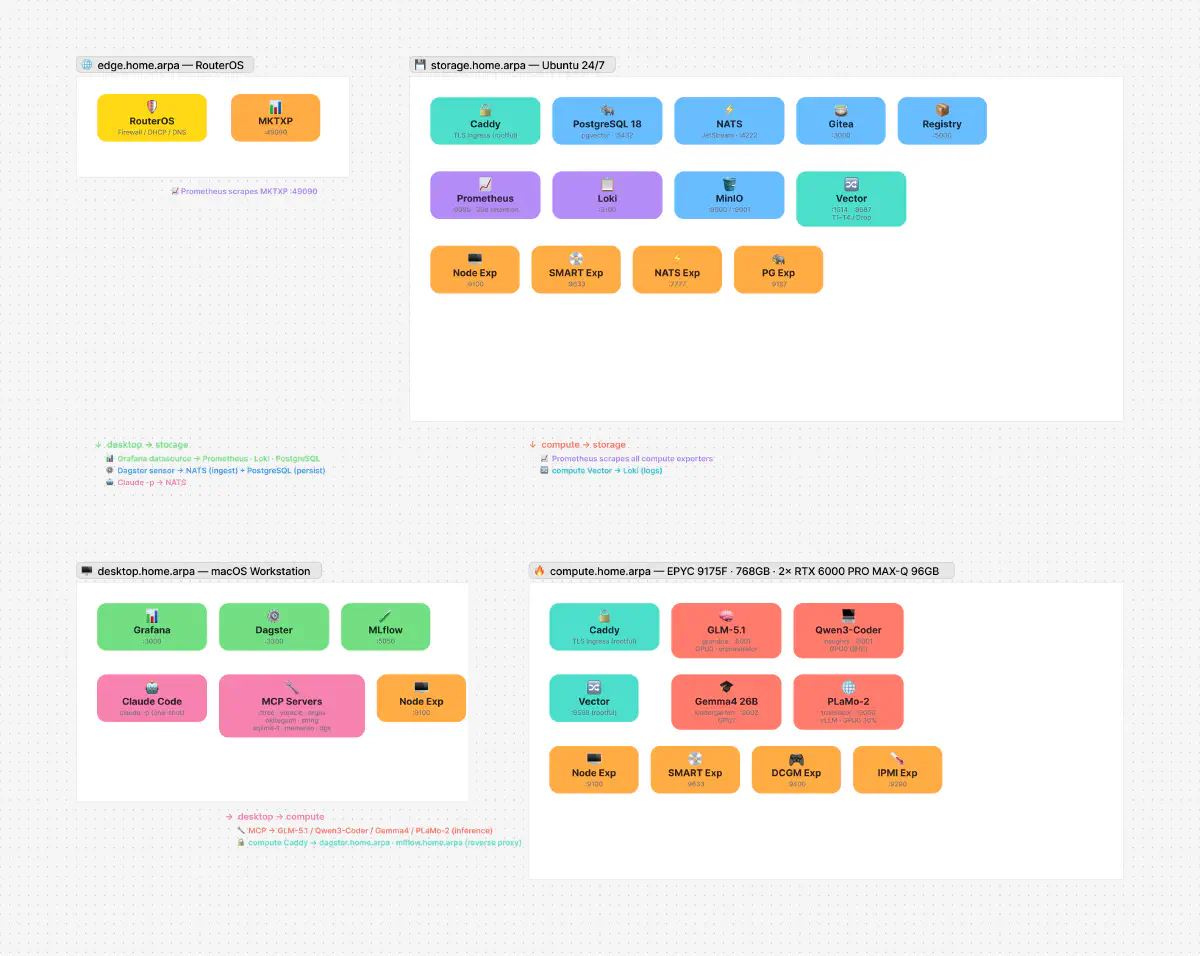
MCPサーバーを動かしているhomelabの構成です。
| MCP サーバー | ツール数 | 一言 |
|---|---|---|
| voracle | 4 | Obsidian vault セマンティック検索 + ウェブリサーチ |
| argus | 1 | クロスリポジトリ コードインテリジェンス |
| ctree | 8 | コードツリー構造解析 + チェックポイント |
| dgs | 17 | ひみつ |
| memento | 2 | ひみつ |
| okitegami | 1 | Discord 置き手紙 |
| smng | 2 | homelab シークレット管理 |
| sqlimit-1 | 5 | read-only DB 探索 |
resolve-inferenceはfamiliar本体へ統合済みです。独立したMCPではありませんが、下に設計経緯を残します。
voracle: vault検索とウェブリサーチ
Obsidian vault向けのセマンティック検索とウェブリサーチです。ONNX embeddingとColBERT rerankingをローカルで動かします。researchはBrave Search APIで得た知見をvaultへ蓄積します。詳細は別記事にあります。
ツール: search, read, research, related
argus: リポジトリを横断するシンボル検索
Giteaの全リポジトリをインデックスします。tree-sitterでシンボルを抽出し、ColBERT MaxSimで検索結果を並べ直します。
  CLI (index + embed)           MCP Server (query)
     |                              |
     v                              v
[Gitea API: repos/search]    [CWD auto-index on startup]
     |                              |
     v                              v
[git clone/fetch]             [argus.see tool]
     |                              |
     v                              v
[tree-sitter: symbols]        [adaptive lexical filter -> ColBERT rerank]
     |                              |
     v                              v
[ColBERT embed (batch)]       [Gemini summarize]
     |                              |
     v                              v
[redb: symbols+embeddings]    [hit tracking + NATS pulse]
embeddingは3層で扱います。
- Batch:
argus embedでインデックス時に全シンボルを事前計算 - Hot-hit: アクセス3回以上のシンボルはクエリ時に再 embed して鮮度を保つ
- On-demand: 未キャッシュのシンボルはクエリ時に embed して永続化
ツール: see(期待するシンボル・モジュール・仕様を指定してリポジトリ横断検索)
ctree: コード構造・依存関係・リビジョン
.ctree.tomlでスコープを定義し、checkでコードのシンボル構造と依存関係を解析します。checkpointで作業の節目を記録します。
ツール: check, checkpoint, get_affected, get_depends, get_symbol, get_text, get_revs, get_baseline
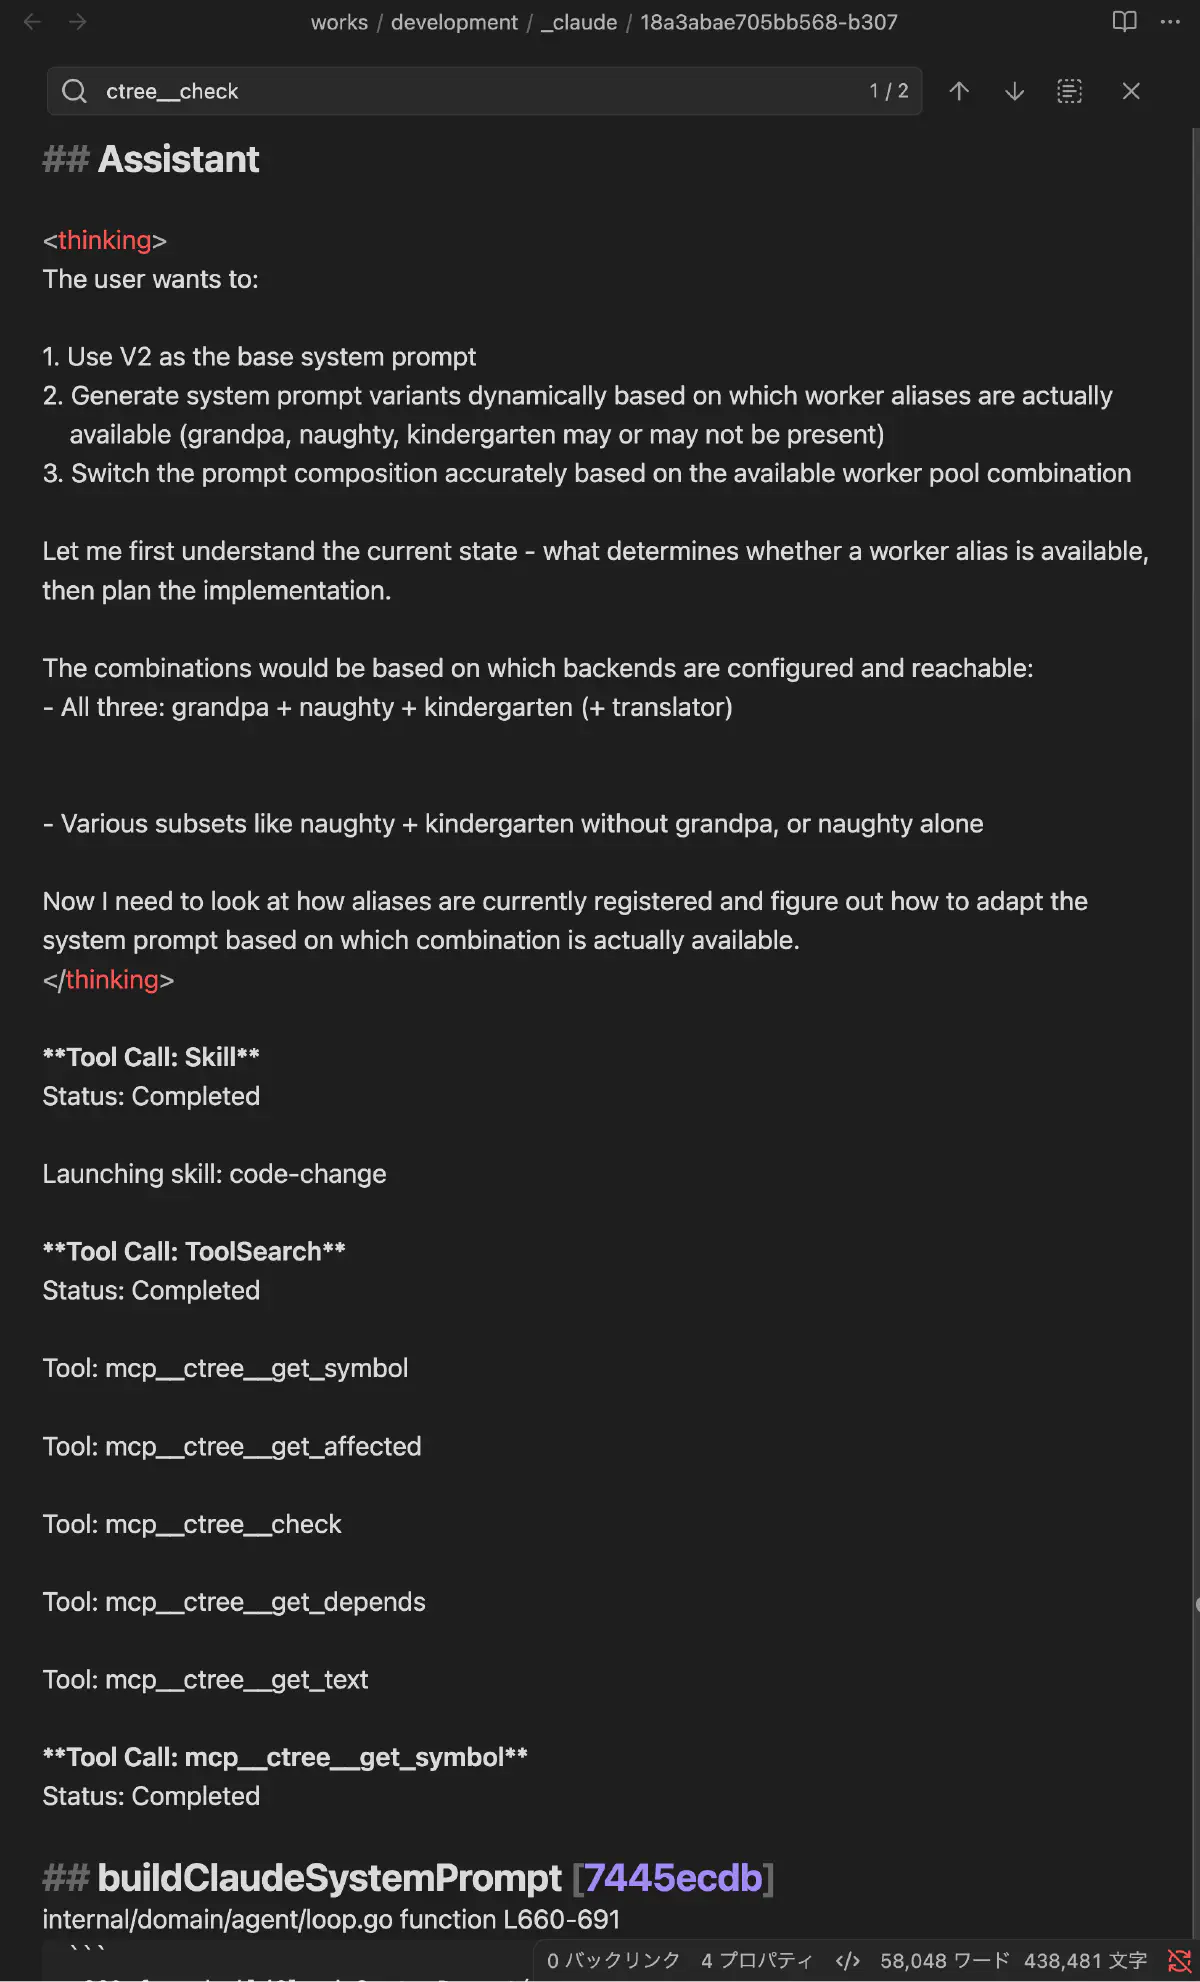
familiarの開発では、変更後にcheckpointでリビジョンを残し、次の実装前にget_affectedで影響範囲を確認します。Obsidianの作業ログにもctree__checkやctree__get_symbolが繰り返し残っています。
多くの応答は5tok程度のreplyか、シンボル名とハッシュです。コード本体は必要なときだけget_textで取得します。依存関係を確認しながら、コンテキスト消費を抑える構成です。以前はserenaと併用していましたが、この構成が安定してから不要になりました。自前のgiteaとdistribution(registry)を入れた後は、argusを通じてiacやコードベースの設計・ノウハウを参照しながらコーディングできています。
dgs – 17 tools (non-public)
9本の中でツール数が最大です。設計と実装の詳細は非公開です。
memento – 2 tools (non-public)
AIエージェント管理に関わるMCPです。設計と実装の詳細は非公開です。
okitegami: Discordへの非同期通知
LLMエージェントが作業の節目にDiscordへ通知します。ツールは1つです。
進捗を置き、人間は都合のよいときに返事を残します。次にエージェントが通知するとき、残っている返事を読みます。
  1. いまの作業結果を Discord に置き手紙する
2. そのついでに、過去の手紙に返信がついていれば読む
3. 返信がなければ何もしない
新しい通知を置くことが読み取りの契機です。返事を探すポーリングループは作りません。
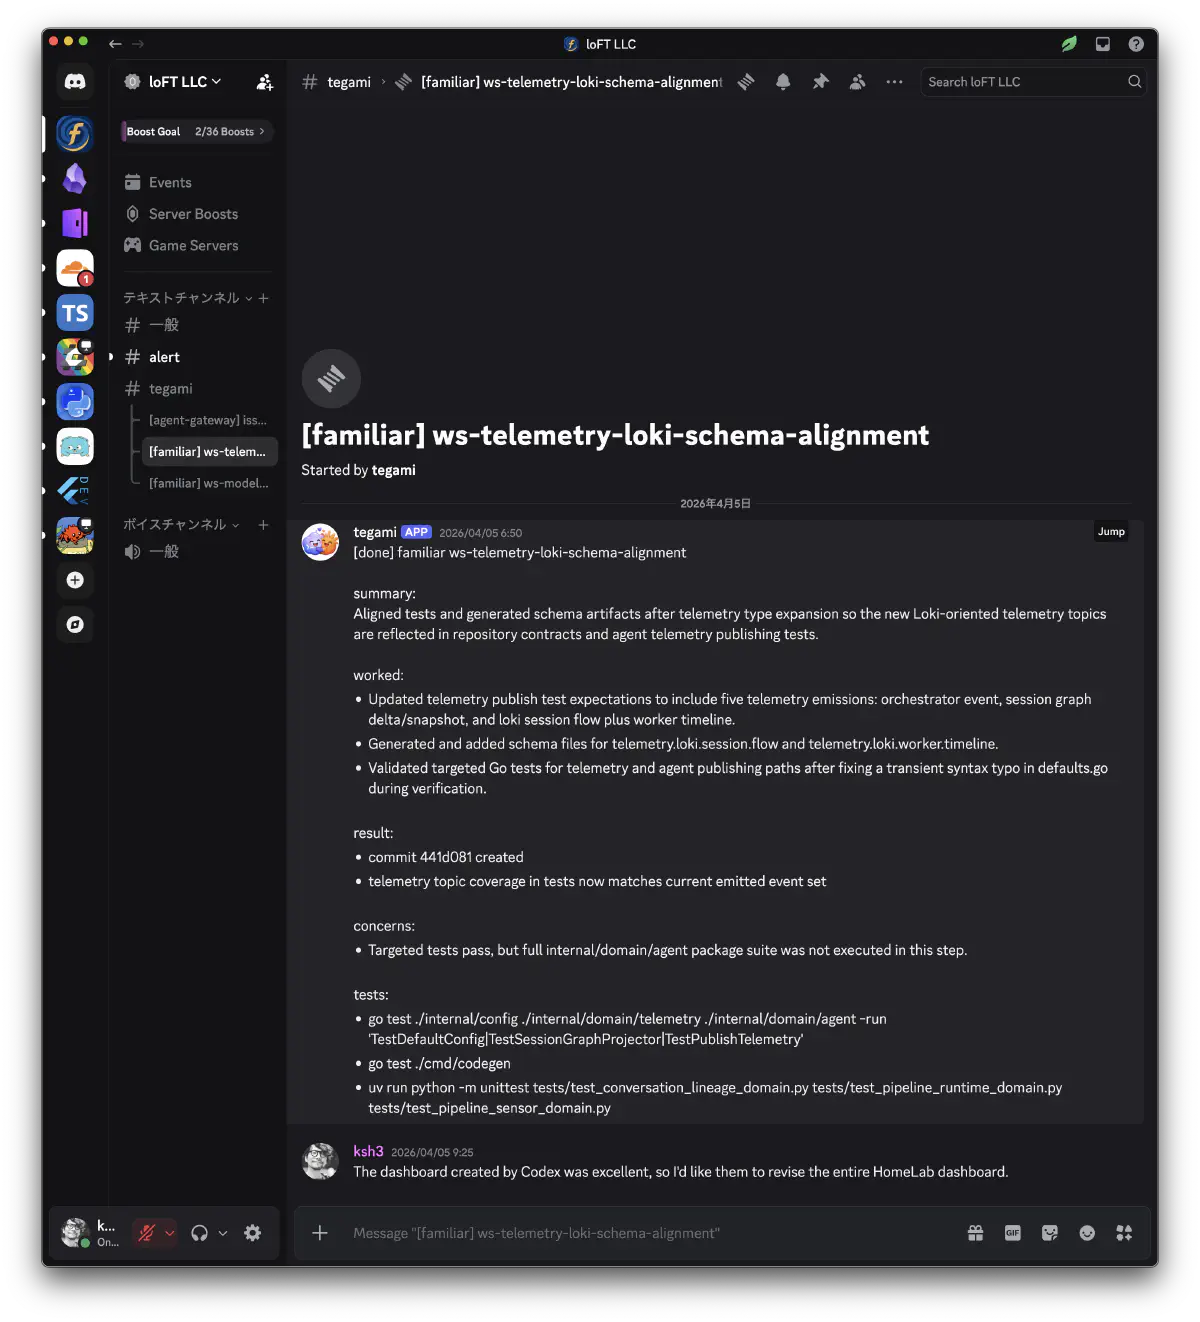
エージェントは開発中に#tegamiへスレッドを作り、進捗を残します。私は後から読み、気づいたことをリプライします。1ヶ月後の返事でも、次にtegamiを呼んだときに拾い、確認を求めたり修正したりします。
急ぎの返事は求めません。返事がなくても作業を続けられるので、長時間の自律作業と人間の確認を非同期でつなげられます。
ツール: tegami
smng: 認証情報と接続情報
homelabのクレデンシャル、エンドポイント、接続情報を管理します。*.home.arpa内のサービス認証情報を取得します。
ツール: list_services, get_secret
sqlimit-1: 1行に制限したDB参照
familiarのメインDBだけを対象に、クエリ結果を最大1行へ制限します。LLMにLIMIT 1を書かせるのではなく、ツールが必ずサブクエリで包みます。
SELECT * FROM (<user_sql>) AS _q LIMIT 1
PostgreSQLのdefault_transaction_read_only = onを設定した専用ユーザで接続します。非SELECT文も拒否し、読み取り専用で使います。
接続情報はsmngから取得できます。sqlimit-1はスキーマのバージョン管理も担当します。dump_schemaで取得したスキーマに変更があれば、新しいバージョンを残します。少ないコンテキストでデータ構造を確認する用途です。
smngは認証情報、sqlimit-1はDB参照とスキーマ記録を担当します。責務を分けて組み合わせています。
ツール: tables, describe, sample, query1, dump_schema
resolve-inference: ENOENTを避けるパス解決
LLMがパスを推測してENOENTを起こす問題に対応するために作りました。ファイルシステムインデックス、字句スコアリング、ColBERT MaxSimで候補を選びます。現在はfamiliarに統合しています。
精度改善にはクエリ履歴が効きました。直近5件の解決パスをリングバッファで保持し、ディレクトリとパッケージのアフィニティで候補を補正します。
  Go モノレポ(106ファイル、client.go が4-11箇所に存在):
  履歴あり: 85.0% (17/20)
  履歴なし: 35.0% (7/20)
  差分:     +50.0pp
3つのColBERTモデルをアンサンブルで評価しましたが、精度はすべて87.3%で、レイテンシだけ3.7倍になりました。この比較ではモデル変更で改善せず、字句アルゴリズム側を見直しました。アンサンブルを廃止し、クエリ履歴の相関へ注力しています。
廃止・統合したツール
廃止したツールの多くは、別のツールへ統合しました。resolve-inferenceはfamiliar本体に入り、初期shelpaのファイルシステム機能はctreeとdgsへ分かれて引き継がれました。
Rustとstdio JSON-RPC 2.0なら、1日ほどでMCPサーバーの形を作れます。試して不要なら廃止し、使えるものを改良する進め方です。
共通の設計
各サーバーで揃えている方針です。
- Rust + stdio JSON-RPC 2.0: プロセス起動が速く、メモリフットプリントが小さい
- 単機能: 1つのツールが1つの問題を解決する。多機能にしない
- LLM エージェントの実務から生まれた: 「こういうときに困る」から逆算して作っている
- グレースフルデグラデーション: ツールが落ちても他のツールは動く。familiar 本体のフローが止まらない
41ツールを9プロセスで動かし、合計メモリ使用量は数十MBです。Rustの小さいバイナリと実行時オーバーヘッドが、多数の小さなプロセスを並走させる構成に合っています。