voracleのresearchを開発フローに組み込む
ウェブ調査をvaultへ保存するvoracleのresearchを安定化しました。UTF-8 panic修正、ONNXモデル移行、MCP統合を通じ、LLM導入後の開発で調査結果を再利用する仕組みを記録します。
researchパイプラインの安定化
voracleのresearchを日常の開発に使い、約1週間で安定化しました。前回の記事で扱ったONNX embedding、ColBERT reranking、MCPサーバー、distilに続き、取得・保存・検索をつなぐ実装です。
調べた内容をvaultへ保存する
最初の目的は、曖昧な言葉でも見つけられるセマンティック検索でした。researchを加えて、開発中に調べた内容も保存するようにしました。
Brave Search APIで取得したウェブコンテンツをMarkdownへ変換し、サマリを付けてvaultに保存します。ブラウザの履歴に埋もれがちな情報を、後から検索できる形にします。
日常の開発でエージェントが調べた知見もObsidian vaultへ蓄積されます。専用の探索CLIを意識して使わなくても、次の開発でvaultを検索して以前の調査を参照できます。
この流れをLLM導入後の開発に使うため、3月末から4月頭にresearchを安定化しました。
下書きと中間ファイルをインデックスから除外
検索対象を確定したナレッジへ絞りました。作業中の下書きやシステムファイルはノイズになるため除外します。
  obsidian/
├── articles/           # 自分の記事
│   ├── _drafts/        # ラフ(draft段階)
│   └── _processed/     # 記事済みアーカイブ
├── web-research/       # research コマンドの出力先
│   └── {category}/note_id.md
├── tasks/              # タスク管理
├── thoughts/           # 関心事メモ
└── works/              # 作業記録
    └── development/
        ├── _claude/
        ├── _codex/
        └── _gemini/
_と.で始まる名前を一律に除外します。_drafts/、_processed/、.search_result.jsonlなどの中間成果物が対象です。
  # vault の状態確認
voracle -status
  vaults: 1
  obsidian: 847 notes, 2,341 chunks
  excluded: _drafts, _processed, _claude, _codex, _gemini
index: .voracle.usearch (f16 HNSW, 2341 vectors)
store: .voracle.db (SQLite)
完成した記事、researchで保存した知見、自分のメモを検索できます。
TurboQuantの調査で動作確認
vaultを整理した日に、GoogleのTurboQuantとローカルLLMの量子化手法をresearchで調べました。
voracle research "TurboQuant|local LLM"
処理は次の順です。
- クエリからキーワードを抽出
- Brave Search API で日英両言語の Web + News を検索
- URL を重複排除してリスト化
- 各 URL で取得、
html-to-markdown-rsで Markdown に変換 - コンテンツの質とノベルティでスコアリング
- 上位 N 件を vault の
web-research/に Markdown ファイルとして保存 - サマリと frontmatter(トピック、カテゴリ、難易度)を自動生成
結果は61,813文字、約26,540トークンでした。Claude Codeのツール結果上限を超えたため、ファイル経由で読みました。調査自体は動いています。
英語の"TurboQuant quantization"と日本語の「量子化 ローカル LLM」を並行して検索します。別言語のキーワードは、トピック設定ファイルとのmaxsimマッチングで選びます。片方で得られない情報を補う設計です。
追記: 今回の調査では日本語で有用な記事が少なく、英語で未翻訳の情報を得られました。スコアを調整し、ほとんどの記事を英語ベースで取得するようにしました。
UTF-8文字の途中でスライスしてpanic
同じ日に、より広いクエリでresearchを実行しました。
voracle research "TurboQuant|ColBERT LLM|Modern BERT"
次のpanicが起きました。
  thread 'main' panicked at src/infra/inference/lfm.rs:237:49:
byte index 2000 is not a char boundary; it is inside '━' (bytes 1998..2001)
Claudeが書いたサマリ前の切り詰め処理が、文字境界を確認せずバイト位置でスライスしていました。
  // NG: バイト位置 2000 が文字の途中に落ちる可能性がある
let truncated = if text.len() > 2000 { &text[..2000] } else { text };
Rustのtext.len()はバイト数です。━(U+2501)はUTF-8で3バイト(1998..2001)を占め、位置2000が文字の途中でした。取得したウェブコンテンツには罫線、記号、日本語が含まれます。
floor_char_boundaryで文字境界へ戻しました。
  let truncated = if text.len() > 2000 {
    let boundary = text.floor_char_boundary(2000);
    &text[..boundary]
} else {
    text
};
floor_char_boundaryは指定位置以下の最も近い文字境界を返します。2000が文字の途中なら1998へ戻ります。Rust 1.73で安定化されたAPIです。
テストも追加しました。
  #[test]
fn truncate_multibyte_boundary() {
    // '━' (U+2501) は UTF-8 で 3 バイト (0xE2 0x94 0x81)
    let text = "a".repeat(1998) + "━━━";
    assert_eq!(text.len(), 2007); // 1998 + 9
    let boundary = text.floor_char_boundary(2000);
    assert_eq!(boundary, 1998);
    let truncated = &text[..boundary];
    assert!(truncated.is_char_boundary(truncated.len()));
}
英語だけのテストでは、この入力の問題を見つけられませんでした。日本語や記号を含むデータで確認する必要があります。
サマリ生成をQwen3.5-0.8Bへ変更
summarize、keyword extraction、frontmatter生成はLiquidAIのLFM2.5-350M-ONNXを使っていました。ライセンスの制約を理由にonnx-community/Qwen3.5-0.8B-ONNXへ変更しました。
選定理由です。
- Apache 2.0 ライセンスで商用利用に問題がない
- 0.8B パラメータで推論負荷が現実的
- ONNX 形式(INT8/FP32)で直接ロードできる
infra/inference/の構成は維持し、LFM2.5の担当箇所をQwen3.5-0.8Bへ差し替えました。
  src/infra/inference/
  embed.rs     # 密ベクトル埋め込み(pplx-embed-v1-0.6b → 変更なし)
  colbert.rs   # ColBERT MaxSim リランキング(変更なし)
  lfm.rs       # LFM2.5 → Qwen3.5-0.8B に置き換え
ONNX Runtimeはort = "=2.0.0-rc.12"に固定します。multi-bert-inferenceとedge-retrievalでも同じ方針です。ortクレートはRC版の間に破壊的変更が入る場合があるため、動作確認済みの版を使います。
  # Cargo.toml
[dependencies]
ort = "=2.0.0-rc.12"
tokenizers = "0.21"
tokenizersでtokenizer.jsonを読みます。Qwen3系はSentencePieceではない独自形式ですが、HuggingFaceのtokenizersが対応しています。
  # モデル配置
ls ~/.local/share/voracle/models/
  qwen3.5-0.8b-onnx/
  model.onnx
  model_quantized.onnx
  tokenizer.json
  config.json
pplx-embed-v1-0.6b/
  model.onnx
  tokenizer.json
mxbai-edge-colbert/
  model.onnx
  tokenizer.json
サマリはLFM2.5と同等以上に感じました。特に日本語で改善した印象がありますが、定量比較はしていません。
インポート処理とテスト
インポート全体をレビューし、不足していたテストを追加しました。
パイプラインの全体フロー
researchの全体フローです。
  クエリ入力
  → キーワード抽出 (Qwen3.5-0.8B)
  → Brave Search (primary language + counter language)
  → URL 重複排除・ドメインストライク除外で HTML 取得
  → tree-sitter-html でコンテンツ抽出 + ボイラープレート除去
  → html-to-markdown-rs で Markdown 変換
  → スコアリング → 上位 N 件を選出
  → vault writer で web-research/ に保存
  → サマリ + frontmatter 生成 (Qwen3.5-0.8B)
ドメインストライクは、ペイウォールや空コンテンツを繰り返すドメインを除外します。3回以上失敗したドメインをBrave Searchの-site:へ加えます。ページごとではなくドメイン単位で管理します。
  # ストライク状況の確認
voracle admin strikes

# 誤爆したドメインの復帰
voracle admin allow example.com
テスト追加
追加したテストです。
writer.rs: vault 書き込み時の既存ファイルとの衝突処理resolver.rs:_/.プレフィックス除外ルールの境界ケースextraction/: 空コンテンツやエラーレスポンスのハンドリング
  #[test]
fn writer_avoids_overwriting_existing_note() {
    let dir = tempdir().unwrap();
    let writer = VaultWriter::new(dir.path());

    // 同一 URL で2回書き込み
    writer.write_research_note(&entry_a).unwrap();
    writer.write_research_note(&entry_a_updated).unwrap();

    // 2回目は別ファイルになる(上書きしない)
    let files: Vec<_> = fs::read_dir(dir.path()).unwrap().collect();
    assert_eq!(files.len(), 2);
}

#[test]
fn resolver_excludes_underscore_prefix() {
    let dir = tempdir().unwrap();
    fs::create_dir_all(dir.path().join("_drafts")).unwrap();
    fs::write(dir.path().join("_drafts/note.md"), "# test").unwrap();
    fs::write(dir.path().join("visible.md"), "# test").unwrap();

    let resolver = VaultResolver::new(dir.path());
    let notes = resolver.scan();
    assert_eq!(notes.len(), 1);
    assert_eq!(notes[0].file_name(), "visible.md");
}
agent-gatewayから呼び出す
vaultとresearchの安定化後、agent-gatewayのMCPプリセットへvoracleを追加しました。
agent-gatewayは、LLMエージェントが使うMCPサーバーの設定をプリセットで管理します。
  // internal/agent/mcp/presets.go

func PresetVoracle(command string) ServerConfig {
    if command == "" {
        command = "voracle"
    }
    return ServerConfig{
        Name:    "voracle",
        Command: command,
        Args:    []string{"--server"},
    }
}

func PresetOkitegami(command string) ServerConfig {
    if command == "" {
        command = "okitegami"
    }
    return ServerConfig{
        Name:    "okitegami",
        Command: command,
        Args:    []string{"--server"},
    }
}
エージェントからvaultを検索し、必要ならresearchを実行して結果を保存できます。調査と再利用を同じ開発フローにつなげました。
日常で使うgrepとresearch
実際のコーディングは半日ほどでした。散歩中に考えた小さな改善を、少しずつ実装しています。
記録時点のコマンドです。
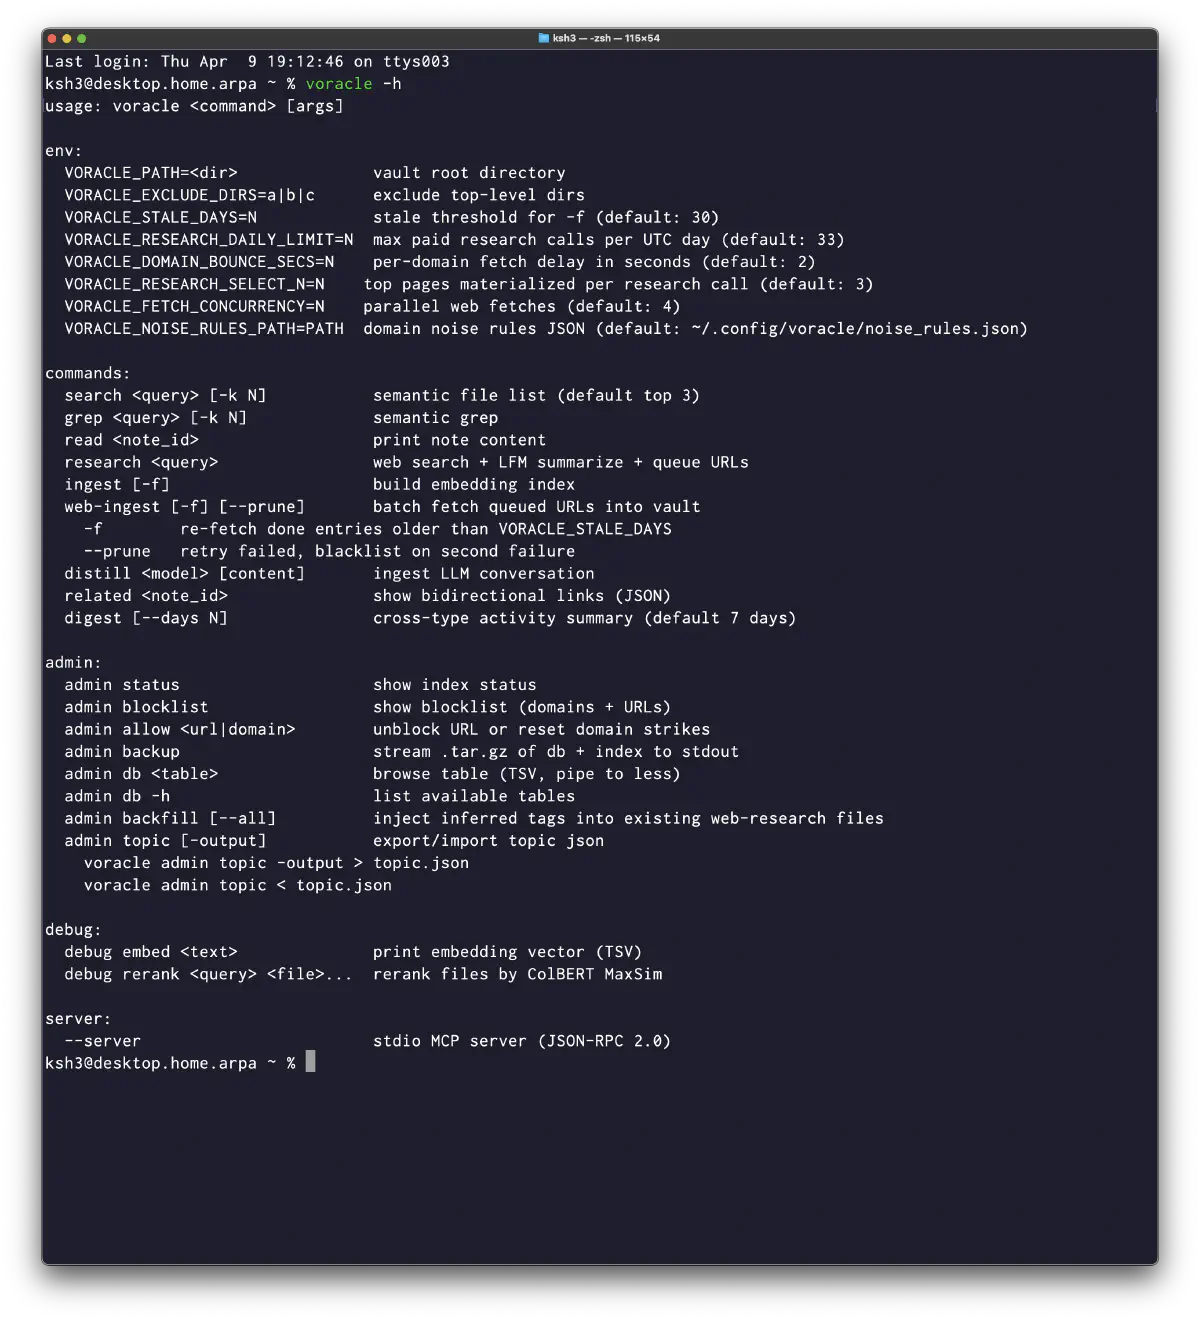
よく使うのはgrepとresearchです。grepは完全一致ではなく、意味が近いチャンクを探します。
  ksh3@desktop.home.arpa ~ % voracle grep "turbo quant"
/Users/ksh3/Development/obsidian/web-research/2026/04/09/technology/2029b5389eccfe38.md:16  [How to test TurboQuant]  (4.2379)
  Verify correctness and measure real-world impact before deploying TurboQuant to production.

/Users/ksh3/Development/obsidian/web-research/2026/04/09/technology/2029b5389eccfe38.md:5  [Triton + vLLM (serving workloads)]  (4.2284)
  Advanced
  Engineers building inference serving pipelines who want to test TurboQuant in a vLLM-like environment

/Users/ksh3/Development/obsidian/web-research/2026/04/09/technology/2029b5389eccfe38.md:2  [How to use TurboQuant]  (4.2177)
  A practical guide for developers who want to try TurboQuant KV cache compression. Covers available implementations, s...
researchの知見と自分の記事を、同じインデックスから検索できます。
  ksh3@desktop.home.arpa ~ % voracle grep "GLM-5.1"
/Users/ksh3/Development/obsidian/articles/llm/glm-4-7-flash-cpu-hybrid-gpu-benchmark_en.md:19  [NVFP4 + vLLM Operational Evaluation]  (6.9704)
  In addition to the IQ5_K benchmarks above, GLM-4.7-Flash-NVFP4 was also evaluated on vLLM for operational suitability.

/Users/ksh3/Development/obsidian/articles/llm/glm-4-7-flash-cpu-hybrid-gpu-benchmark_ja.md:33  [共通変数]  (6.8849)
  IMG=compute.home.arpa/ik_llama-cpu:latest
  MO=/mnt/data/hf/hub/models--ubergarm--GLM-4.7-Flash-GGUF

/Users/ksh3/Development/obsidian/web-research/2026/04/08/technology/5ee34b17c638fe00.md:40  [GLM-5 - GlmMoeDsa]  (6.7509)
  The zAI team launches GLM-5, and introduces it as such:
  > GLM-5, targeting complex systems engineering and long-horizon agentic tasks.
ペイウォールで内容を取れないドメインも、自動除外の対象になっています。
  ksh3@desktop.home.arpa ~ % voracle admin blocklist
Exclude Domains (strike >= 3 = excluded):
  [X] github.com  40  (paywall)
  [X] www.ponkotsu.dev  11  (paywall)
  [X] medium.com  7  (paywall)
  [X] dev.to  4  (paywall)
  [X] machinelearningmastery.com  3  (paywall)
  ...
researchはMCPツールとしても動き、Claude Codeやagent-gatewayが開発中に呼びます。自分とAIの調査を同じvaultに保存し、必要なときだけ参照します。調べる際はまずvoracle grepを使うようになりました。
検索ノイズを減らす、特定の結果を上位に出すといった改善を、帰宅後30分ほどで実装することもあります。日常の使い方に合わせて調整を続けています。