
DeepSeek Harnessのローカル実行構成
DeepSeek-V4-Flash-Vision-ExpとV4.1-FlashをRTX PRO 6000 Max-Q 2枚で使いました。LLM導入に向け、familiar-daemon、agent-gateway、ancestorの分担とDjango実装時のログを示します。
変更した構成
familiar の自作 agent を DeepSeek Harness に置き換えました。
gateway、agent、infra を内包した構成から agent を外し、DeepSeek Harness(以下 dsh)をコンテナ Pod で動かします。dsh には Pod 内でフル権限を渡しています。
familiar は familiar-daemon と agent-gateway に分けました。推論バックエンドを管理する既存の ancestor と合わせて、3つで dsh を動かします。
Codex Astra のリリース後、性能の確認も兼ねて約1週間で移植しました。
初期設計は 前回の記事 にあります。今回は agent の変更と実行結果を扱います。
動画
Pod 内の dsh と、compute 上の vLLM を使った実行の動画です。
1本目は deepseek-ai/DeepSeek-V4-Flash-Vision-Exp の公式 checkpoint で、Django のドメイン層を実装した実行です。設定と数値は「Vision-Expでの実行内容」に示します。
動画リンク: https://www.youtube.com/watch?v=KD-4jm46izk
2本目は DeepSeek-V4.1-Flash の EXL3 2.0bpw による別の実行です。diffbot の 量子化モデル を使いました。
動画リンク: https://www.youtube.com/watch?v=CBkIkCtIxJI
旧familiarの機能
旧 familiar は gateway、agent、infra を含むモノリスで、次の機能を持っていました。
- コンパクション
- メモリー
- サマライズ
- ロールごとのメモリー管理
- knowledge基盤の操作
- 独自ツール
- MCP。Goで書いていたので、
embedでMCPのソースを丸ごと埋め込んだりもしていた - OpenTelemetry、Vector、Prometheus、Grafanaへのobservability
- GrafanaとGraphQLで作ったwhat-ifやreplay
- Dagster assetsのpipeline
- shell実行を検証するコンテナの仕組み
- ツールのリカバリー
ローカル LLM が失敗しやすい処理を、ツールや実行管理で補う開発が中心でした。
dshを選んだ理由
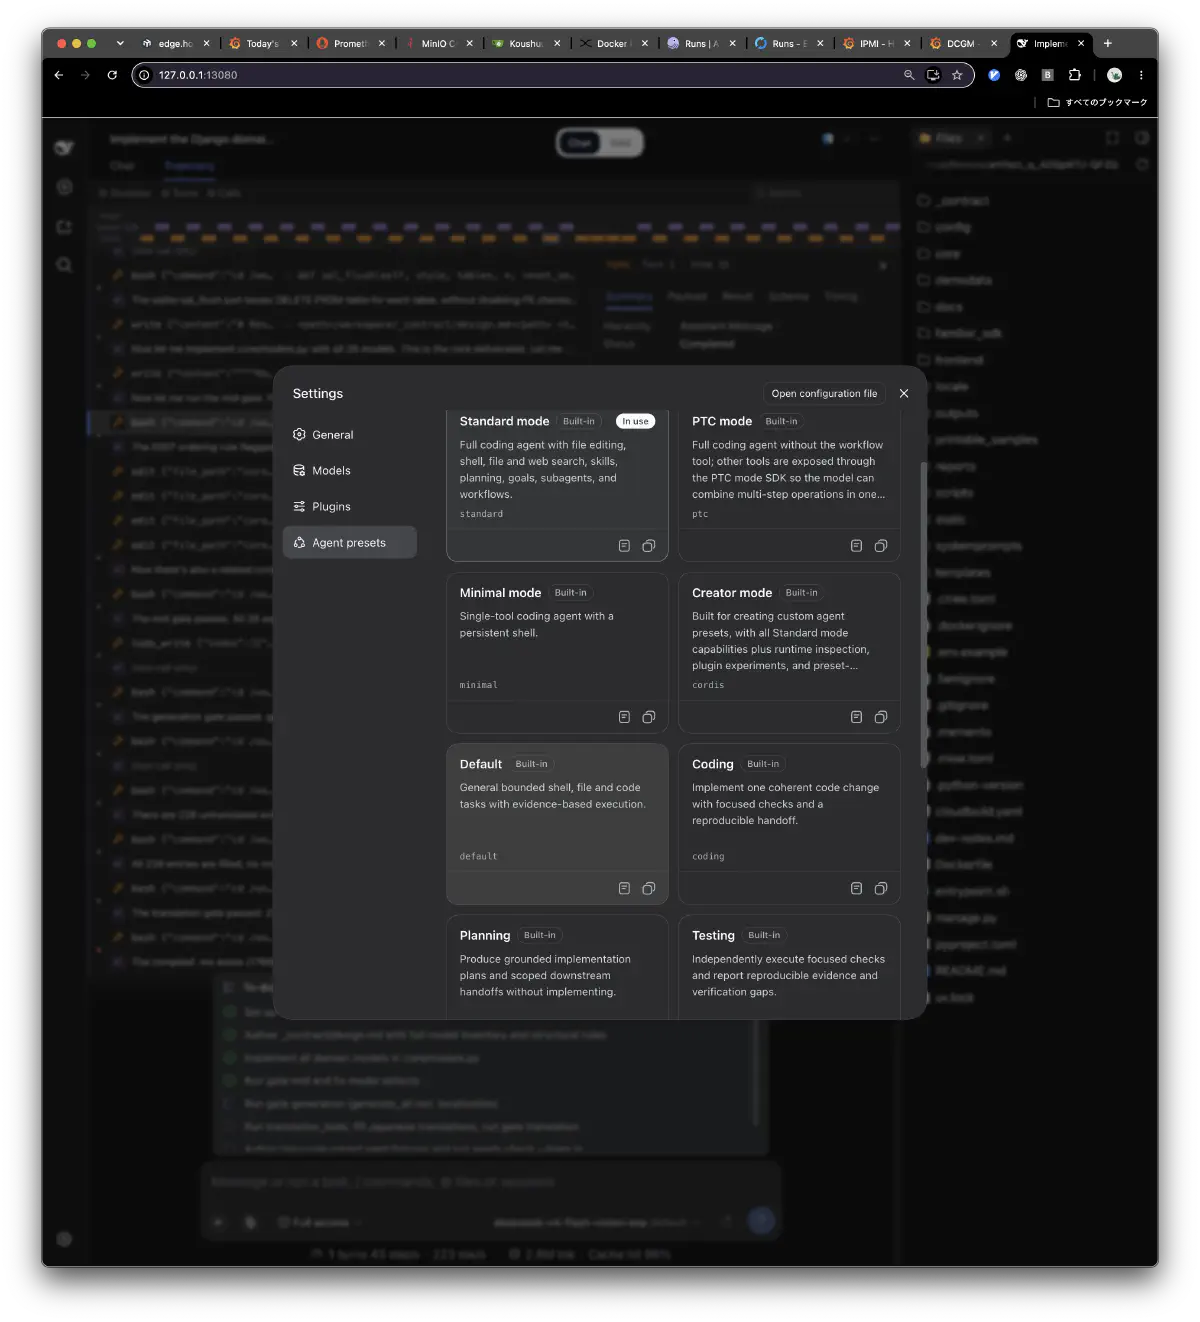
dsh を選んだ理由は、機能をプラグインで追加できる設計です。
記事時点ではプラグインが増え、必要な機能を既存の実装でまかなえる場合もありました。
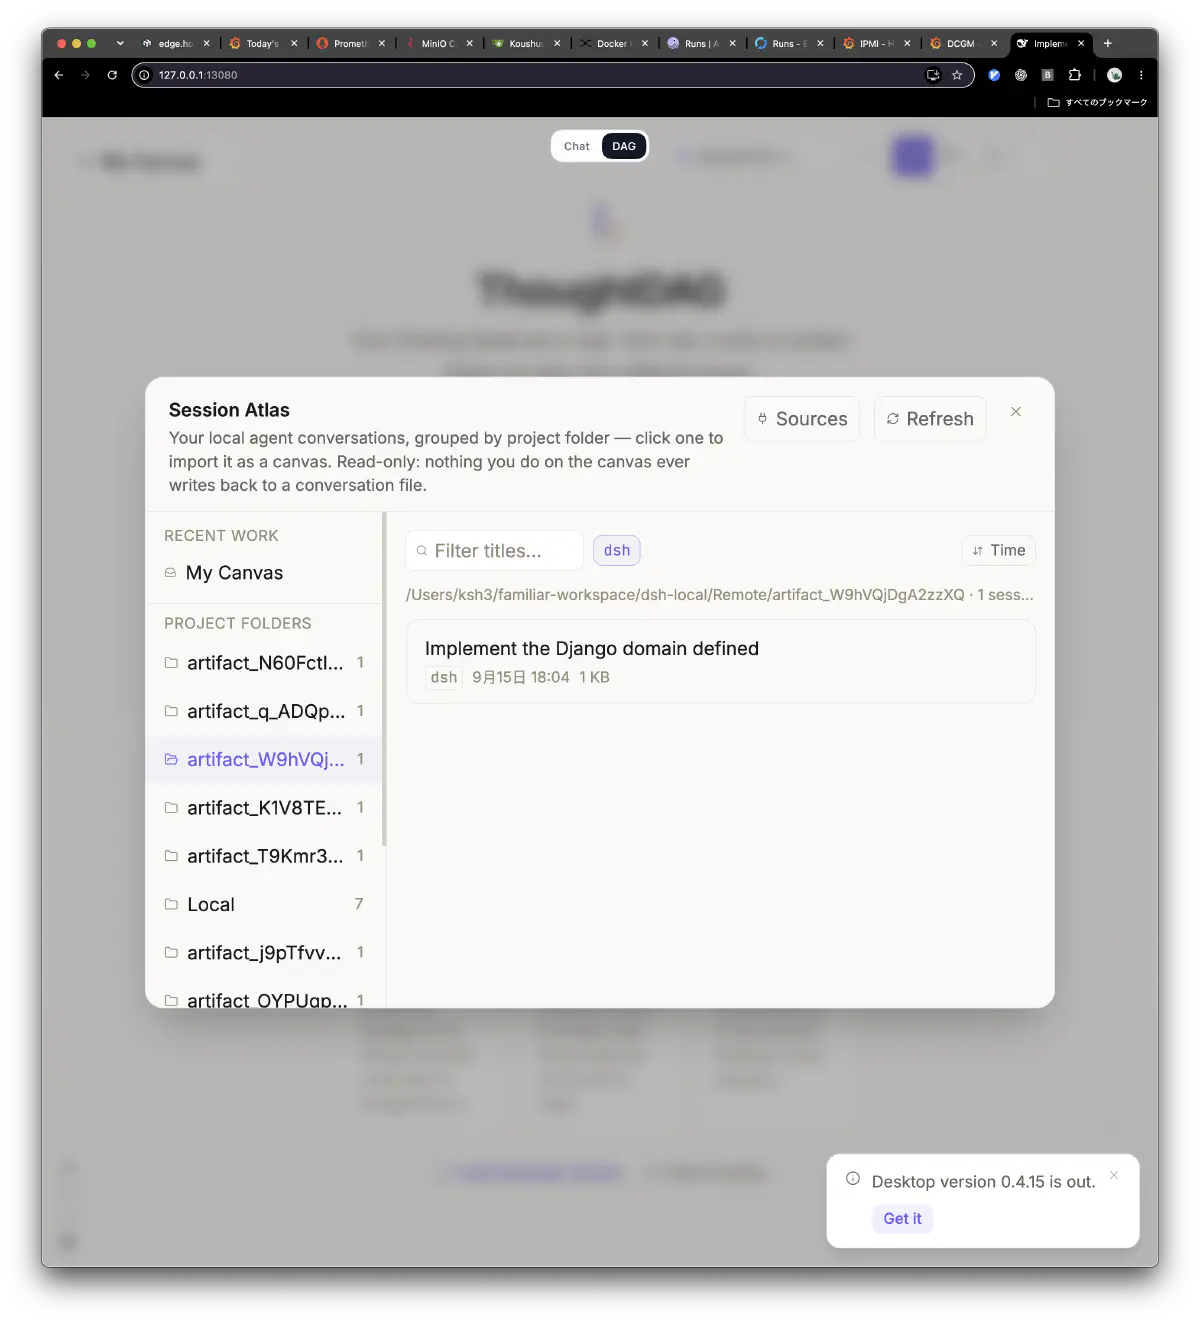
Grafana と GraphQL で自作した what-if / replay も、プラグインに置き換えました。ThoughtDAG は LLM の context をグラフで表示・編集し、分岐した実行を試せます。desktop の dsh では、Chat の隣の DAG タブから使っています。
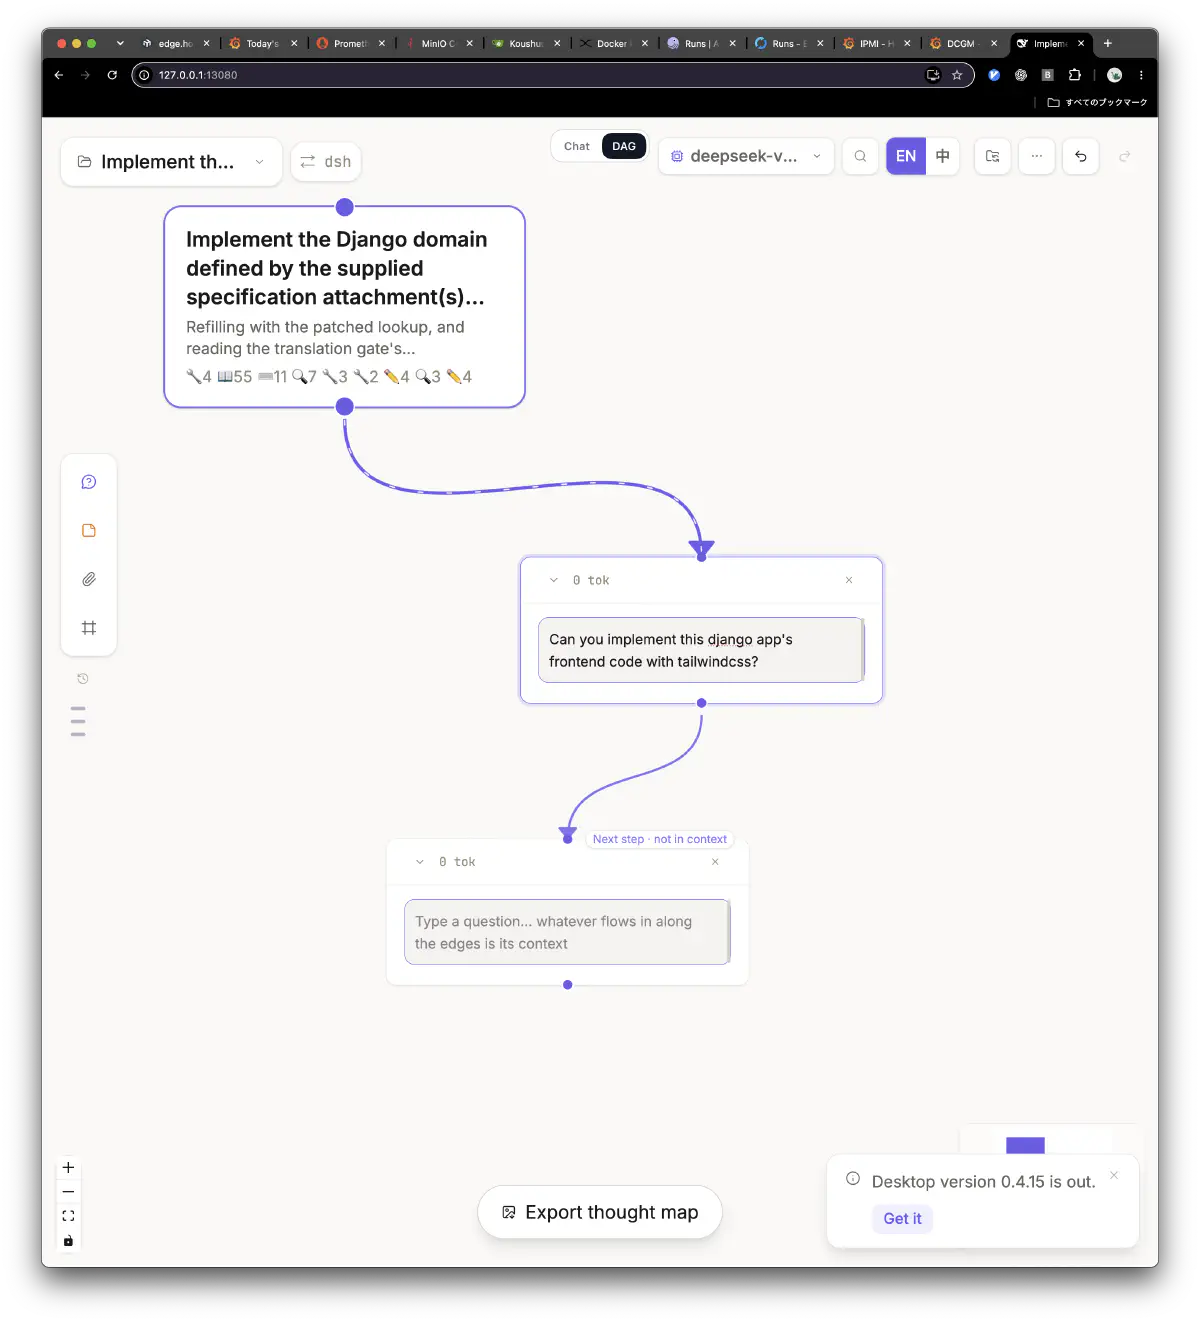
外部で開発・保守されるプラグインを使い、自作する範囲を減らしています。
3つのコンポーネント
agent 以外のインフラ機能を移植し、担当を分けました。
| コンポーネント | 実装 | 役割 | 旧familiarとの関係 |
|---|---|---|---|
| familiar-daemon(famd) | Go | dshへの依頼(delegation)の受付、隔離したworkspace、状態の永続化、復旧、結果の回収、Podの管理 | familiarから分けた |
| agent-gateway | Go | dshやOpenAI互換クライアント向けの推論gateway。起動中のAncestorインスタンスを見つけて、公開モデルIDでルーティングする | familiarから分けた |
| ancestor | Rust | compute hostの推論サーバーの管理。presetから構成を作り、Podman Quadletとsystemdのuser serviceで起動、停止する | 前からある。そのまま使った |
famd は agent の実行と自身の運用イベントの NATS publish を担当します。OpenAI 互換エンドポイントと prompt、tool call、response の capture は agent-gateway の担当です。capture は非同期で NATS に送り、OpenTelemetry などにもこのイベントを使います。
推論サーバーの起動・停止は ancestor が担当します。famd に依頼を送っても、自動では起動・停止しません。
今の構成
flowchart LR
  subgraph desktop["desktop.home.arpa"]
    CLI["famdctl"]
    UI["dsh Web UI"]
  end
  subgraph compute["compute.home.arpa"]
    FAMD["familiar-daemon<br/>control / launcher / finalizer"]
    GW["agent-gateway"]
    ANC["ancestor"]
    VLLM["vLLM"]
    RELAY["famd-egress<br/>inference relay"]
    subgraph pod["runtime Pod"]
      DSH["DeepSeek Harness<br/>Full access"]
      WEB["Web relay"]
    end
  end
  NATS[("NATS")]
  CLI --> FAMD
  CLI --> GW
  CLI --> ANC
  FAMD --> pod
  ANC --> VLLM
  DSH --> RELAY --> GW --> VLLM
  GW -. discover .-> ANC
  FAMD -. events .-> NATS
  GW -. capture .-> NATS
  UI -. "SSH tunnel<br/>pod forward" .-> WEB
compute.home.arpa では、famd の control、launcher、finalizer と agent-gateway がネイティブサービスとして動きます。
famd-egress は Pod からの推論の入口です。dsh が http://famd-egress:8080/v1 に送ったリクエストを agent-gateway に中継します。Quadlet コンテナで、root filesystem は read-only、capability はすべて落としています。
desktop の famdctl から delegation を送ると、受付後に runtime Pod が作られ、dsh が起動します。Pod には dsh と Web relay が入ります。dsh には Pod 内でフル権限を渡します。その理由と制約は「フル権限について」に示します。
famdctlでの操作
famdctl のコマンド構成です。
  ksh3@desktop.home.arpa ~ % famdctl
famdctl [--json] [--config path] [--idempotency-key key] <command>

  ancestor    List, inspect, plan, ensure or stop Ancestor services
  delegation  List, submit, inspect, wait for, retrieve or cancel a delegation
  session     List, start, recover, observe or close a DSH session
  events      Stream lifecycle events, resuming with --after
  artifact    Inspect or download a verified artifact
  pod         List, start, stop, remove, drain or forward runtime Pods
  dsh-local   Prepare, sync and open the local DSH Web UI
  workbench   Alias for dsh-local open
  workspace   Initialize or locate the local work records and DSH mirror
  gateway     List public models
  config      Initialize or inspect saved settings
  doctor      Check configuration; --online probes supported service APIs
  completion  Print a bash or zsh completion script

Use famdctl <command> --help for details. Output is formatted for reading.
Add --json anywhere before -- for raw JSON responses and JSONL events.
Exit status: 0 success/waiting, 1 service/local/terminal failure, 2 usage error.
Root submit/run, status, wait, result and cancel are delegation shortcuts.
Save endpoints once with config init, then use alias fam=famdctl.
ancestor は ancestor、gateway は agent-gateway、delegation、session、events、artifact、pod は famd を操作します。接続先と認証情報はサービスごとに分けています。
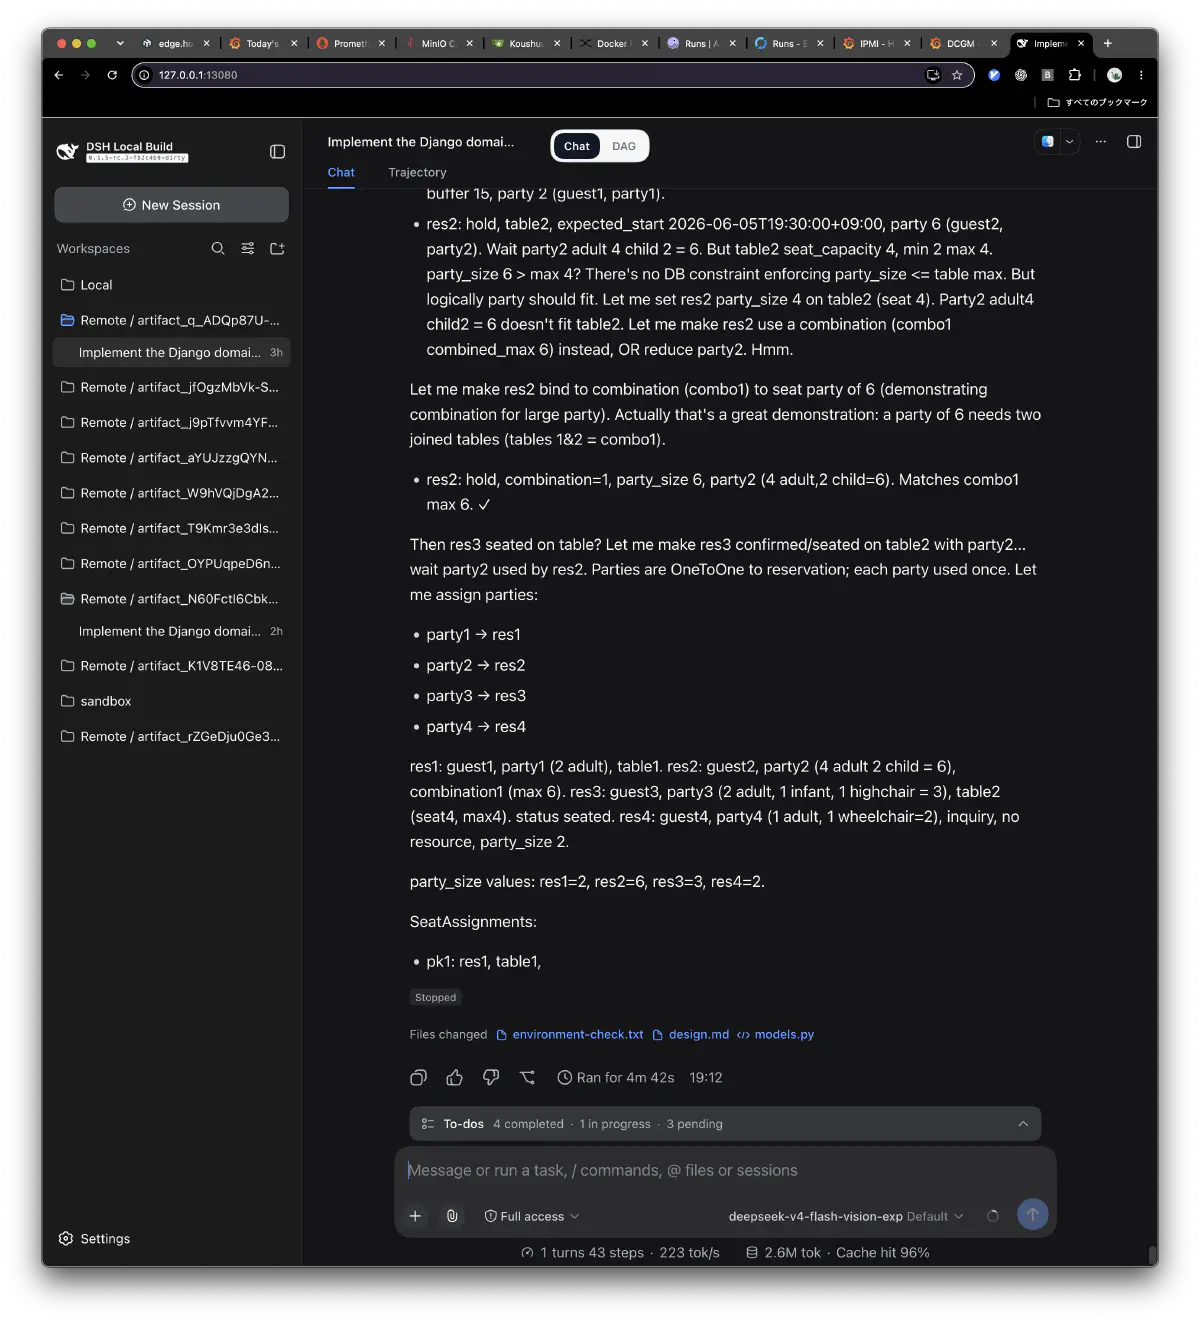
Django のドメイン実装を依頼した例です。--detach では受付のみ返ります。
  ksh3@desktop.home.arpa ~/familiar-workspace % famdctl delegation submit --workflow django --detach /Users/ksh3/familiar-workspace/task/task.json
Work record: /Users/ksh3/familiar-workspace/workflow/django/2026-09-15/18-03-25
STATUS    DELEGATION           SESSION              ACCEPTED
accepted  del_W9hVQjDgA2zzXQ   ags_NPoXgKU5IGYmAg   2026-09-15 18:04:17
Receipt only; execution is not confirmed.
Next: famdctl delegation wait del_W9hVQjDgA2zzXQ
pod forward で compute.home.arpa 経由のトンネルを張り、ブラウザーで Pod 内の dsh を開きます。
  ksh3@desktop.home.arpa ~/familiar-workspace % famdctl pod forward del_W9hVQjDgA2zzXQ
http://127.0.0.1:13080/?token=<redacted>
Pod pod_EaTd58jSdfE2kA is forwarded through compute.home.arpa; press Ctrl-C to close the tunnel.
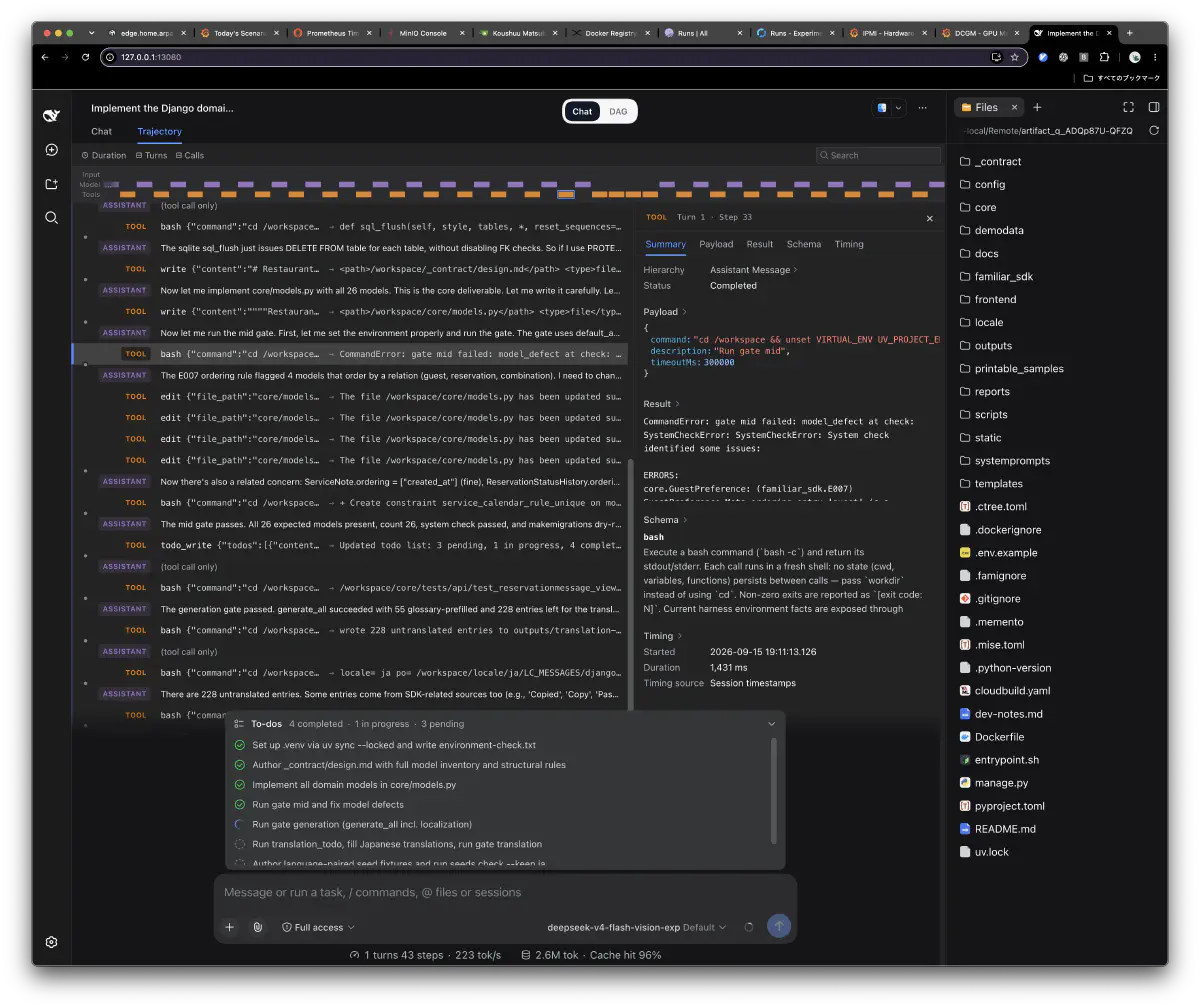
Web UI の Chat と Trajectory で、To-dos と /workspace のファイルを確認できます。セッションは desktop の ~/familiar-workspace/dsh-local/Remote/ に同期され、dsh の Remote / artifact_… からも開けます。
vLLM と runtime Pod が停止中の、compute-server の podman ps です。
  ksh3@compute-server:~$ podman ps
CONTAINER ID  IMAGE                                                                                                            COMMAND               CREATED         STATUS         PORTS       NAMES
77af06a3024b  registry.home.arpa/ml-foundry-mlflow@sha256:e0916a7bce42adc92f5b688e212ece81c0b1ce363e92eaf02b1118161f23cf3b     mlflow server --h...  5 hours ago     Up 5 hours                 mlflow
2144fc65532d  registry.home.arpa/ml-foundry@sha256:df3d06efff1570a47085c8002d980d66085c01c69b5d07d5afab98c4f482c888            dagster api grpc ...  5 hours ago     Up 5 hours                 dagster-user-code
381a9063ea00  registry.home.arpa/ml-foundry@sha256:df3d06efff1570a47085c8002d980d66085c01c69b5d07d5afab98c4f482c888            dagster-webserver...  5 hours ago     Up 5 hours                 dagster-webserver
9df064d0e85b  registry.home.arpa/ml-foundry@sha256:df3d06efff1570a47085c8002d980d66085c01c69b5d07d5afab98c4f482c888            dagster-daemon ru...  5 hours ago     Up 5 hours                 dagster-daemon
c9849a9fd9a5  registry.home.arpa/famd-inference-relay@sha256:702149bdc55611ef25ba40d98c0181d55e9d786507ad5b991e17ccbc96bd4ed4  --upstream http:/...  17 minutes ago  Up 17 minutes              famd-egress
famd-egress は推論 relay です。famd の control と agent-gateway はネイティブサービスなので、この一覧には出ません。
Dagster と MLflow は ml-foundry の構成です。model-foundry を agent-gateway に合わせて改修し、モデル用に加えて投資研究用の ML pipeline も追加しました。
Vision-Exp 実行時は、ancestor が起動した ancestor-deepseek-v4-flash-vision-exp と、Pod の dsh runner / dsh web も動きます。両方は famd-dsh-runner イメージで、--managed が dsh、--proxy-only が Web relay です。Pod は 127.0.0.1 に1ポートだけ公開し、Web UI はトンネル越しに接続します。
Vision-Expでの実行内容
1本目では、compute の vLLM で DeepSeek-V4-Flash-Vision-Exp を動かし、Podman Pod の dsh に Django のドメイン層を実装させました。モデルへのリクエストはホスト内で処理します。ローカルLLM導入で、アプリケーション開発を実行する構成の例です。
構成
  MODEL: deepseek-ai/DeepSeek-V4-Flash-Vision-Exp @ 6821d6ad3681a4b137b066b76094fa82ebd0a380
IMAGE: registry.home.arpa/voipmonitor/vllm:ds4-jovian-r9-5bea08859798
HOST:  compute.home.arpa:8000 (engine) <- pod forward <- desktop.home.arpa (client)
POD:   dsh runner, dsh web
GPU:   NVIDIA RTX PRO 6000 Blackwell Max-Q ×2 (GPU 0,1 / 300W cap)
| 項目 | 設定 |
|---|---|
| context | 1M(max-model-len 1048576)、最大出力393,216 tokens |
| 重み | 公式checkpointのまま。FP8(e4m3、128×128 block)、expertはFP4、それ以外はbfloat16。追加の量子化はしていない |
| 並列 | TP2(tensor-parallel-size 2)、NVLinkなし |
| speculative decoding | DSpark fixed-probabilistic K3(3 token) |
| KV cache | GPU KVのみ、LMCacheなし |
| GPU memory | gpu-memory-utilization 0.968 |
| 同時リクエスト | 4(max-num-seqs 4) |
| batch | max-num-batched-tokens 4096 |
| reasoning effort | high |
| その他 | tool calling有効、vision有効、OpenAI互換のchat completions API |
vLLM service の ExecStart です。env file は ancestor の active ディレクトリから読みます。
ExecStart=/usr/bin/podman run --name=ancestor-deepseek-v4-flash-vision-exp --cidfile=%t/%N.cid --replace --rm --cgroups=split --network=host --init --sdnotify=conmon -d --ulimit stack=67108864:67108864 --device=nvidia.com/gpu=0 --device=nvidia.com/gpu=1 -v /mnt/data/hf/hub/models--deepseek-ai--DeepSeek-V4-Flash-Vision-Exp:/models:ro -v /mnt/data/hf/jit/ds4-vision-exp-jovian-r9:/cache -v /mnt/data/hf/tmp/ds4-vision-exp-jovian-r9:/container-tmp --env-file /home/ksh3/.local/state/ancestor/active/ancestor-deepseek-v4-flash-vision-exp.env --pull never --entrypoint=/usr/local/bin/lmcache-mp-wrapper.sh --ipc=host registry.home.arpa/voipmonitor/vllm:ds4-jovian-r9-5bea08859798 /usr/local/bin/serve-ds4-flash.sh
serving profile は local-inference-lab/rtx6kpro の DeepSeek-V4-Flash Jovian Judgement r9 の Vision spec をもとにしました。gpu_memory_utilization は GPU KV 用の0.975、LMCache 用の0.970ではなく、0.968にしています。
entrypoint は lmcache-mp-wrapper.sh を通りますが、LMCACHE_MODE は未設定です。host tier は使わず、GPU KV のみで実行しました。
同じ RTX PRO 6000 2枚での DeepSeek V4 Flash 0731 と DSpark K5 の計測は 別の記事 にあります。モデルと設定が異なるため、直接比較はしていません。
engineログの数値
約7分の engine ログに、70件の chat completion リクエストがありました。
| 指標 | 値 |
|---|---|
| decode throughput(平均) | 180 tok/s(ピーク257.9 tok/s) |
| prefill throughput(prompt処理中の窓の平均) | 444 tok/s |
| DSpark draftの採択 | 53,246 / 72,615 tokens(73.3%)、depth 3での平均採択長3.20 |
| prefix cache hit rate | 87.5% → 98.0% |
| decodeだけの窓(平均) | 216.6 tok/s |
| prefillが混ざる窓(平均) | 156.3 tok/s |
prefix cache hit rate は87.5%から98.0%に上がり、新しい prefix が入る際に3回下がりました。
decode のみの窓と prefill を含む窓の比較では、chunked prefill を含むと decode が約28%低くなりました。同じ engine 内の比較です。
動画の dsh ステータスバーは201 tok/s、cache hit 93%です。期間と分母が異なるクライアント側の値で、engine の値とは一致しません。
数字の注意点
数値は engine ログの10秒窓の平均です。TTFT、ITL、リクエストごとの latency は取得していません。token 合計も rate×10秒からの概算です。
r9 の公開値は600W Workstation カードの計測です。今回は300W Max-Q なので、そのまま比較できません。
フル権限について
旧 familiar では、過剰なガードで実行が繰り返し失敗し、出力品質も下がりました。複雑なパイプなどの shell をコンテナ内で dry-run する方式に変え、ガードを外しました。その経験から、今回も Pod 内ではフル権限を使っています。
記事時点では ds4、glm5.3-flash、qwen38-flash-next を日常の作業に使っています。3月頃より、作業に使える OSS モデルが増えました。
制限なしの実行には破壊的操作のリスクが残ります。試す環境を隔離し、先にスナップショットを取る必要があります。
所感
約6か月の自作 agent 開発で、モデル選定、実行時の問題、MCP の実装を確認できました。OSS を再利用する方針と並行して、AI コーディングで独自の仕組みも作ってきました。
dsh のプラグインとコミュニティで公開されるツールを使い、今後は自作する範囲を減らす方針です。今回、agent を置き換え、推論と実行を管理する基盤を残しました。